Lion-ER:只激活3B,开始学驭物
招商局狮子山实验室发布 Lion-ER-35B-A3B,以 35B 总参数、3B 激活参数切入具身推理。十项基准全线提升,但真正考验仍是能否把榜单能力转化为真实机器人成功率。
35B 总参数,推理时只动用 3B
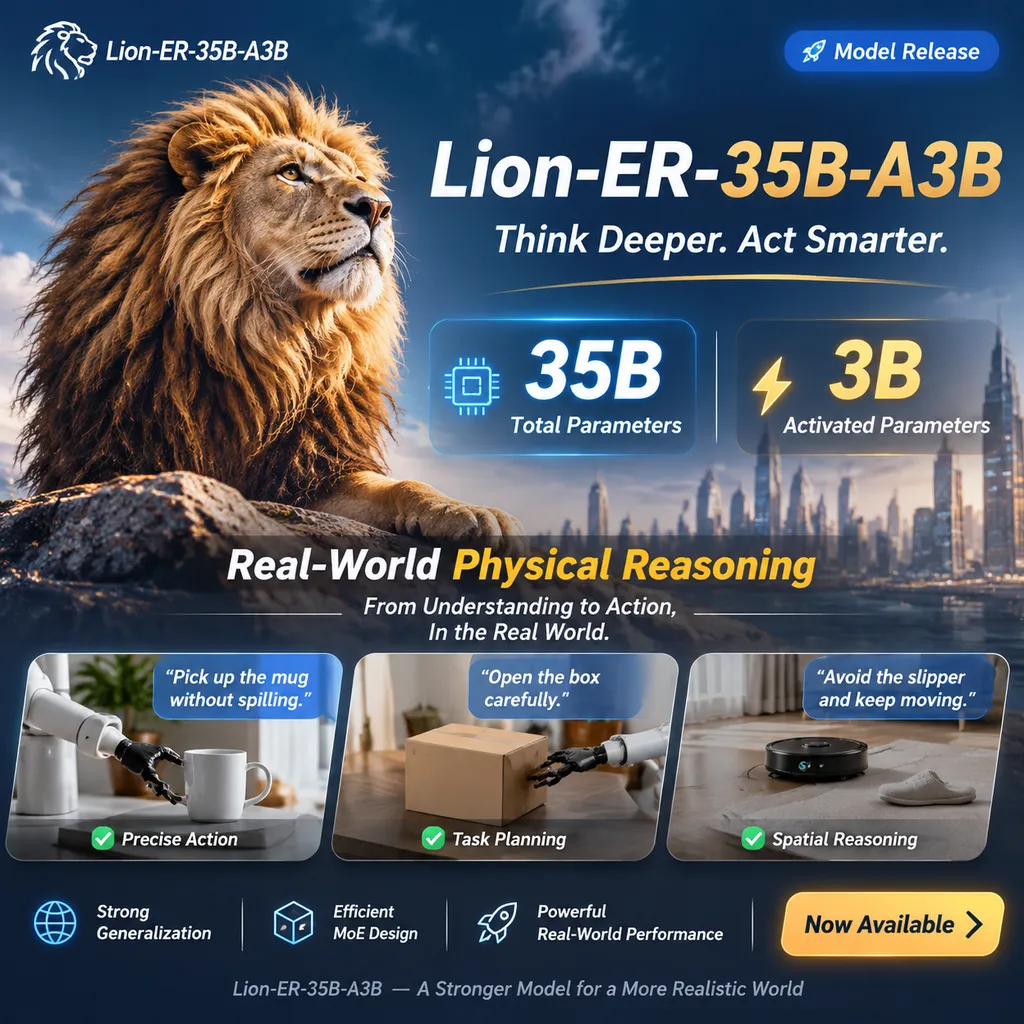
招商局狮子山人工智能实验室近日发布「驭物™ Lion-ER-35B-A3B」,把目标直接对准真实物理世界的理解与推理。模型总参数量为 350 亿,但每次推理仅激活约 30 亿参数;按照发布方披露的结果,Lion-ER-35B-A3B 在十项相关基准上实现全线提升。
截至 2026 年 11 月 4 日,这次发布最值得关注的并不是又多了一个“35B-A3B”模型,而是团队试图回答一个更棘手的问题:大模型会做题、会看图之后,能不能进一步理解物体如何被抓取、移动、组合和改变,并把这种理解用于真实机器人任务。
**具身推理是模型围绕物体、空间、动作和因果关系进行判断,并将判断用于现实环境决策的能力。**它不只要求模型识别“桌上有一个杯子”,还要理解杯子的开口方向、遮挡关系、可抓取位置、装水后的重量变化,以及机械臂从哪个角度接近更不容易碰倒旁边的物体。
这也是 Lion-ER 与普通视觉问答模型最核心的定位差异。普通视觉语言模型可以告诉你“图中有一把剪刀”,具身推理模型则需要进一步判断剪刀是否被其他物体压住、握住刀刃是否危险、哪个部位适合夹取,以及拿起剪刀之后场景会发生什么变化。
A3B 省的是计算,不是模型权重
**A3B 是 Active 3 Billion 的缩写,表示模型每次生成或推理时只激活约 30 亿参数。**Lion-ER-35B-A3B 虽然拥有 350 亿总参数,但单个输入不需要经过全部参数,而是由路由机制选择与当前任务更相关的专家模块参与计算。
**混合专家模型是通过稀疏路由机制,让不同输入调用不同参数子集的神经网络架构。**它有点像一家拥有多个专业科室的医院:医院的总人员规模很大,但一名患者不需要同时接受所有医生会诊,而是由分诊系统把问题交给少数相关科室。
这种架构的价值是把“模型容量”和“单次计算量”部分拆开。350 亿总参数可以容纳更多知识和能力分工,约 30 亿激活参数则试图把每次推理的计算成本控制在小模型附近。
但“只激活 3B”绝不等于“部署只需要装下 3B”。模型的完整专家权重通常仍需驻留在显存、内存或分层存储中,路由、注意力层、共享参数和专家通信也会产生额外开销。对开发者来说,A3B 主要降低的是每个 token 的有效计算量,而不是自动把 35B 权重变成一台低配设备就能无压力运行的 3B 模型。
参数量也不能直接换算为速度。真实吞吐还会受到量化精度、批处理规模、上下文长度、专家负载均衡、显存带宽和推理框架实现影响。尤其在多卡部署中,如果被选中的专家分散在不同设备上,通信成本可能抵消一部分稀疏计算收益。
Lion-ER 不是另一个通用聊天模型
Lion-ER-35B-A3B 的差异化方向是物理世界推理,而不是继续在通用问答、数学竞赛或代码生成榜单上正面硬碰。它要处理的是空间关系、物体属性、动作后果、状态变化和可供性等问题,这些能力共同决定模型是否真的“懂物”。
**可供性是物体在特定环境中允许主体执行哪些动作的属性。**门把手可以旋转或下压,杯柄适合抓取,抽屉边缘可以拉动,但同一个动作换到玻璃杯口或刀刃上就可能失败甚至造成危险。
物理世界理解至少包含五层能力:
- 对象识别:分清场景中的物体、部件和材料;
- 空间关系:判断前后、内外、支撑、接触、遮挡和距离;
- 物理属性:估计软硬、轻重、易碎性、摩擦和稳定性;
- 因果预测:推断推动、倾斜、抓取或移除物体后的结果;
- 动作规划:把目标拆成可执行步骤,并根据环境反馈调整计划。
Lion-ER 如果能够把这些能力稳定串联起来,它的价值会明显超过单纯的图像描述模型。例如,仓储机器人面对一个被纸箱遮挡的目标物时,真正需要的不是一句“目标部分不可见”,而是判断先移开哪个箱子、移动方向是否会引发堆叠坍塌,以及目标露出后从哪里抓取最稳妥。
“十项全线提升”有意义,但还不是终局证明
发布方称 Lion-ER-35B-A3B 在十项基准上全部取得提升,这说明模型改进并非只针对单一数据集或单一题型。相比只挑选一两个优势项目宣传,跨十项评测保持一致增长,至少表明训练方法具有一定泛化倾向。
不过,现阶段公开信息尚不足以把“全线提升”换算成真实机器人能力。用于严肃比较的完整评测至少还应包括基准名称、测试集规模、对照模型、输入分辨率、提示词设置、是否使用思维链、平均分与方差,以及多次运行的稳定性。
“提升”本身也需要参照物。如果基线是同尺寸通用模型,那么结果主要证明具身专项训练有效;如果对照对象包括更大规模的闭源多模态模型,意义会更强;如果测试集与训练数据存在较高相似度,榜单优势则可能被高估。
真实物理任务尤其容易出现基准与现场之间的落差。模型在静态图片上判断“哪个物体会掉落”,并不代表它能在摄像头抖动、光照变化、深度缺失和机械臂控制误差同时存在时完成抓取。前者考验语义和物理常识,后者还涉及连续感知、实时规划、控制闭环与故障恢复。
因此,十项基准全线提升是一个积极信号,但不是“机器人已经懂得现实世界”的充分证据。更有说服力的数据应该是实体机器人上的任务成功率、平均完成时间、碰撞次数、重规划频率和跨场景泛化能力。
不靠堆数据,真正要看数据如何组织
Lion-ER 的发布强调“不靠堆砌数据”,这实际上击中了具身智能训练的一个现实难题:高质量物理交互数据比网页文本昂贵得多,也更难标准化。
互联网文本可以低成本复制和清洗,机器人轨迹却需要设备、场地、操作人员和传感器共同参与。同一个“把杯子放进托盘”的任务,还会因为机械臂型号、相机位置、杯子材质、托盘尺寸和动作控制频率不同而产生明显差异。
单纯扩大数据量也未必能自动产生物理理解。大量重复的成功轨迹可能让模型记住常见动作,却无法解释动作为什么有效;只有成功样本而缺少失败样本,也会让模型学不到“哪些动作看似合理但会造成碰撞、滑落或倾倒”。
高价值的具身数据通常需要覆盖状态、动作和后果三者之间的关系。相比再增加一百万张孤立图片,一组包含动作前状态、动作指令、执行轨迹、动作后状态和失败原因的数据,可能更有助于模型形成因果判断。
Lion-ER 所谓“不靠堆砌数据”最终要由训练配方来证明。开发者真正关心的是:模型是否使用真实机器人轨迹、仿真数据、视频数据或合成推理数据;不同数据之间如何配比;是否加入反事实样本;以及评测集是否与训练集严格隔离。截至目前提供的公开资料并未完整披露这些细节,因此还不能把这句话理解为已经解决了具身数据效率问题。
35B-A3B 正在成为一条成熟路线
35B 总参数、3B 激活参数并不是孤立设计,2026 年已有通用模型采用相近的稀疏专家配置。Qwen3.6-35B-A3B 同样以 350 亿总参数和 30 亿激活参数为核心卖点,但它更偏向通用多模态、Agent 与编码能力;Lion-ER 则把容量集中到物理世界理解和具身推理。
| 模型或架构 | 总参数 | 单次激活参数 | 主要定位 | 当前公开信息的重点 | |---|---:|---:|---|---| | Lion-ER-35B-A3B | 35B | 3B | 具身推理、真实物理世界理解 | 十项相关基准全线提升 | | Qwen3.6-35B-A3B | 35B | 3B | 通用多模态、Agent、编码 | 以较低激活量提供接近更大稠密模型的能力 | | 27B 稠密模型 | 27B | 27B | 通用或垂直任务 | 全参数参与计算,部署逻辑相对直接 | | 35B 稠密模型 | 35B | 35B | 高容量通用推理 | 单次计算量更高,但没有专家路由开销 |
这组对比说明,Lion-ER 的亮点并不是首创 A3B,而是把已经在通用模型中验证过的稀疏架构带向具身推理。对于机器人系统而言,这个方向很实际:模型必须在有限延迟和功耗下持续处理视觉输入,不能每次决策都等待一个超大稠密模型完成长时间推理。
Lion-ER 也不能仅凭相同的参数标签与 Qwen3.6 直接比较性能。两者的训练目标、输入形式和评测体系不同,一个通用模型在代码或数学上的领先,并不能推导出它在物体操作上更强;反过来,具身基准得分更高也不意味着 Lion-ER 更适合作为聊天助手。
它更像机器人的“大脑中层”
Lion-ER 当前更适合被理解为机器人技术栈中的推理模块,而不是一套拿来就能控制机械臂的完整系统。一个真实机器人通常还需要相机与深度传感器、目标检测与跟踪、定位系统、运动规划器、低层控制器和安全机制。
模型在这套系统中的位置更接近“大脑中层”:上接视觉和语言感知,下接动作规划与控制。它可以判断“先移开红色盒子,再抓取后面的杯子”,但把这句话转换为关节角度、夹爪力度和避障轨迹,仍需要专门的控制模块完成。
这种模块化定位反而更容易落地。开发者可以先把 Lion-ER 用作场景理解器、任务分解器或动作验证器,而不是一开始就让它端到端接管机器人。对于工业环境而言,让模型提出计划,再由确定性规划器检查碰撞和安全约束,通常比直接输出控制信号更可靠。
值得尝试的场景包括:
- 仓储分拣中的遮挡分析与抓取顺序规划;
- 制造业装配中的零件关系判断与步骤检查;
- 家庭机器人对容器、工具和易碎物品的操作规划;
- 无人设备对复杂场景的因果风险判断;
- 机器人训练数据的自动标注、失败归因和轨迹筛选。
现在最需要补齐的是可验证性
Lion-ER-35B-A3B 的产品方向是成立的,但发布后的关键问题已经从“有没有模型”变成“外部能不能复现”。截至 11 月 4 日,现有资料尚未完整交代模型权重获取方式、开源许可证、上下文长度、支持的输入模态、推理框架、量化方案和硬件需求。
这些信息对开发者的重要性不亚于榜单成绩。具身模型如果只能在特定内部环境运行,它更接近研究展示;只有模型权重、推理工具和评测脚本能够被外部团队使用,社区才可能验证它在不同机器人、相机和任务上的迁移能力。
视频输入能力也值得重点确认。真实物理过程是连续发生的,单张图片很难表达物体运动、碰撞、液体流动和形变;如果模型主要处理静态图像,它更接近物理常识推理模型,如果支持长视频或连续视觉状态,才更接近真实具身系统所需的世界动态理解。
延迟指标同样不能缺席。机器人动作规划通常不能只看每秒生成多少文本 token,而要看从传感器输入到动作决策的端到端响应时间。一个推理质量很高但单步等待数秒的模型,可能适合离线规划,却难以处理快速变化的开放环境。
我们的判断:方向比参数更重要,证据还要继续补
Lion-ER-35B-A3B 是一次值得关注的垂直模型发布,因为它没有继续把“更会聊天”当作唯一目标,而是主动进入空间、物体、动作和因果关系交织的真实世界。
3B 激活参数也是一个务实选择。具身系统对延迟、成本和功耗更敏感,稀疏专家架构能够在保留 35B 模型容量的同时压低单次计算量,比直接堆一个更大的稠密模型更符合机器人部署逻辑。
但当前最需要警惕的是把“十项基准提升”直接等同于“机器人能力突破”。具身智能最终必须在实体环境中接受噪声、遮挡、控制误差和安全约束的共同检验,静态基准只能覆盖其中一部分。
Lion-ER 接下来的含金量将取决于三件事:第一,是否公布完整评测表和对照设置;第二,是否提供可复现的模型、代码或在线体验;第三,是否拿出真实机器人上的任务成功率和跨环境测试结果。
如果这三项能够陆续补齐,Lion-ER 可能成为国产具身推理模型中一条有辨识度的路线;如果后续仍只有参数标签和汇总榜单,它就更像一次方向正确、但证据尚未完成闭环的技术预告。
参考来源
- Hugging Face:Mixture of Experts Explained:介绍混合专家模型的稀疏路由、计算效率与部署挑战,用于理解 A3B 架构。
- 知乎:通义 Qwen3.6 开源,3B 激活参数对比 27B 性能:提供 Qwen3.6-35B-A3B 的参数配置与部署定位,作为同规格稀疏模型参照。
- Reddit LocalLLaMA:Qwen3.6-35B-A3B 发布讨论:社区对 35B 总参数、3B 激活参数和多模态能力的讨论。