中科大开源RNA模型structRFM
中科大团队开源结构引导RNA基础模型structRFM,并于今日登上Nature。模型基于约2100万组序列—结构数据预训练,可服务RNA结构预测、同源分类与功能推断。
中国科学技术大学今天正式开源 RNA 序列基础模型 structRFM,相关研究成果已于 11 月 5 日凌晨发表于《Nature》。这不是把通用语言模型简单搬到生物序列上的又一次尝试,而是一次更明确的路线选择:让模型在预训练阶段同时学习 RNA 的序列上下文与碱基配对关系,而不是等到下游微调时再补结构知识。
**structRFM 是一个通过结构引导掩码预训练、面向 RNA 结构预测与功能推断的开源基础模型。**中国科大医学影像智能与机器人实验室周少华教授、熊鹏特任研究员团队为其构建了约 2100 万组 RNA 序列—二级结构配对数据,并开放模型、代码及相关任务实现。按照中国科大公布的信息,这是该校 2026 年以来以第一署名及通讯单位在 Nature、Science、Cell 发表的第 16 篇成果。
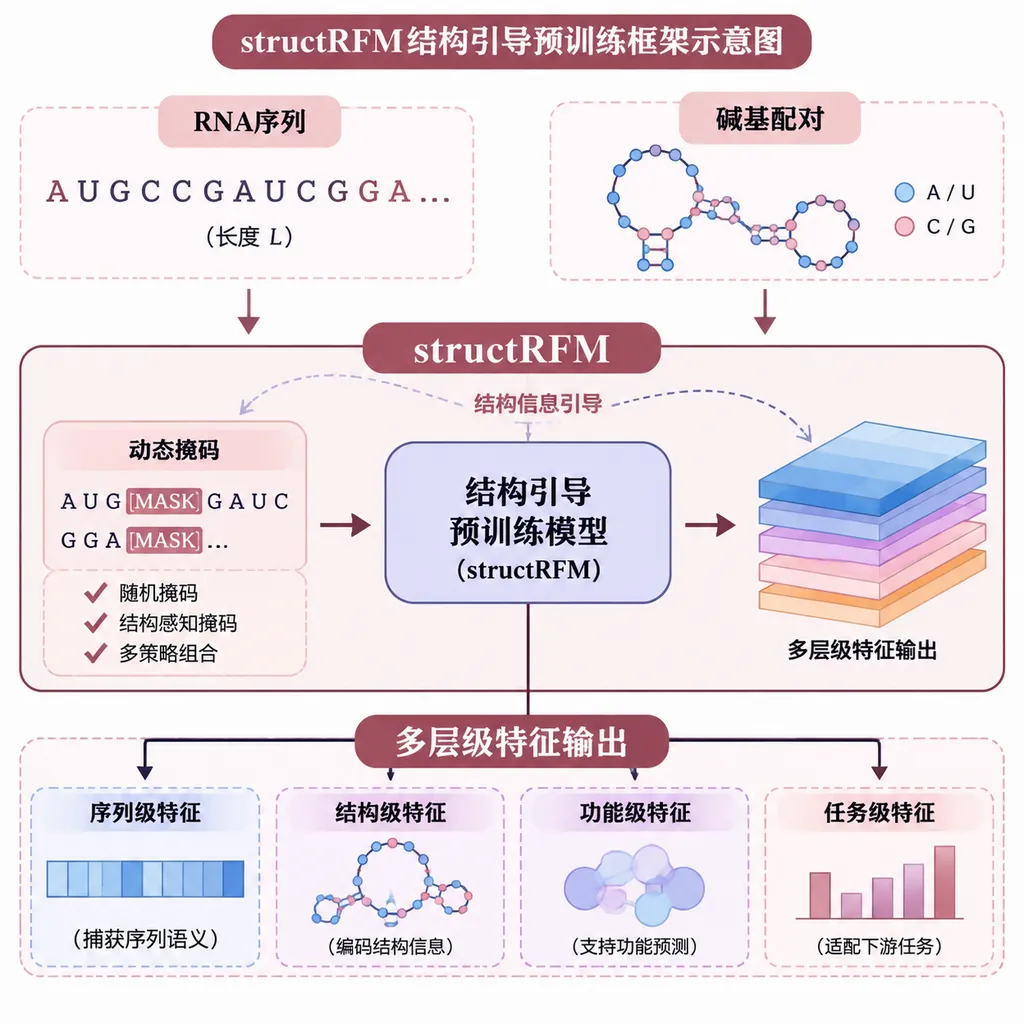
核心变化:模型不只读序列,还学习哪些碱基会配对
**RNA 基础模型是从大规模 RNA 序列中学习通用表示、再适配结构和功能任务的预训练模型。**它与自然语言模型的直觉相似:RNA 由腺嘌呤、尿嘧啶、胞嘧啶和鸟嘌呤等核苷酸构成,模型可以通过预测被遮住的片段,学习局部上下文、保守模式和家族特征。
**单纯把 RNA 当成一行字符,无法完整描述它的生物学行为。**自然语言主要沿一维顺序展开,而 RNA 链上的两个核苷酸即使在线性序列中相隔很远,也可能通过碱基配对靠在一起,形成发卡、茎环等二级结构,并进一步折叠成三维构象。RNA 是否稳定、能否与蛋白质或小分子结合,以及是否参与剪接和翻译调控,都可能受到这些结构影响。
**RNA 二级结构是由链内碱基配对关系形成的二维拓扑结构。**它位于原始序列和三维构象之间,既比三维实验结构更容易规模化获得,又比纯序列包含更多生物物理信息,因此是 RNA 基础模型最现实的结构知识入口。
**structRFM 的关键方法是结构引导掩码语言建模,即 SgMLM。**传统掩码语言模型随机遮住部分核苷酸,再要求网络根据上下文恢复原始字符;structRFM 则进一步利用配对匹配操作,把存在结构依赖的核苷酸纳入训练目标。直观地说,模型不仅要猜一句话里被盖住的字,还要理解远处哪两个字通过一条看不见的线相互约束。
**动态掩码比例用于平衡序列学习和结构学习。**如果训练过度偏向结构,模型可能损失对通用序列模式的感知;如果结构信号过弱,又会退化成普通 RNA 语言模型。研究团队让核苷酸级掩码和结构引导掩码共同参与预训练,以减少模型只记住单一任务偏差的风险。
2100万组配对数据,才是这项工作的底座
**structRFM 的基础数据集包含约 2100 万条经过计算注释的 RNA 序列—二级结构配对样本。**对于 RNA 研究而言,这个规模的重要性不只是样本数量多,而是每条序列都有对应的结构信息,使模型可以在统一目标下学习序列与配对关系。
**计算注释解决了实验结构数据稀缺的问题,但也引入了标签噪声。**实验测定 RNA 结构成本高、覆盖有限,无法直接支撑千万级预训练;团队因此使用 BPfold 生成结构注释。这样做能迅速扩大数据规模,但模型学到的结构上限也会受到 BPfold 偏差影响,尤其是非经典碱基配对、假结和复杂环境下的构象变化。
**structRFM 的输出不局限于一个序列向量。**预训练完成后,模型只需要 RNA 序列作为输入,即可抽取三类表示:描述整条 RNA 的序列级特征、描述每个位置的核苷酸级特征,以及描述任意两个位置关系的核苷酸对级矩阵特征。
这三类表示分别对应不同任务:
- 序列级特征适合 RNA 家族分类、非编码 RNA 分类等整体验证任务;
- 核苷酸级特征适合剪接位点预测等逐位置标注任务;
- 核苷酸对级特征适合二级结构接触图和三维结构约束建模;
- 分类级表示可用于分析不同 RNA 家族在特征空间中的聚类与同源关系。
**多层级输出是 structRFM 比单一分类模型更像基础模型的原因。**研究者不必为每个任务重新训练一个从零开始的编码器,而是可以冻结或微调 structRFM,再接入较轻的任务头或结构模型。
从零样本分类到三维预测,structRFM覆盖了哪些任务
**零样本推断是指模型在没有针对目标任务额外训练的情况下,直接利用预训练表示完成分类或预测。**structRFM 在 RNAcentral 的 23,994 条 RNA 子集上表现出清晰的家族聚类能力,并在 Rfam 的 24,523 条 RNA 与 ArchiveII600 的 3,611 条 RNA 上检验了同源和非同源序列对的表示差异。
**structRFM 在与 15 种生物语言模型的比较中进入零样本同源分类的领先梯队。**这一结果说明结构引导预训练学到的不只是训练数据里的固定配对模板,还能把同一 RNA 家族的共同模式编码进向量空间。不过,零样本聚类效果好不等于可以直接替代系统发育分析或实验验证,它更适合用作候选筛选和数据探索工具。
**二级结构预测是 structRFM 最直接受益于结构预训练的任务。**模型可将核苷酸对级表示转化为接触概率矩阵,再通过阈值或下游预测头恢复配对关系。相比只在下游阶段接触结构标签的模型,structRFM 从预训练开始就反复学习远距离依赖,因此在新发布 RNA 家族上仍保持了较好的预测表现。
**三级结构预测是 structRFM 更有想象力、也更难验证的方向。**团队把 structRFM 特征引入名为 Zfold 的三级结构预测方案,用预训练获得的配对和序列表示辅助估计三维构象,同时检查由三维结构反推的二级结构是否合理。这里的价值并不是宣称 RNA 版 AlphaFold 已经完成,而是为三维模型提供更强的序列—结构先验。
**功能推断展示了结构特征不只服务于折叠任务。**团队测试了剪接位点预测、内部核糖体进入位点识别和非编码 RNA 分类,其中剪接位点数据包含 16,505 条 RNA,IRES 识别数据包含 1,164 条 RNA,nRC 非编码 RNA 分类数据包含 2,600 条 RNA、覆盖 13 个类别。
**内部核糖体进入位点是允许核糖体在非传统起始机制下进入 RNA 并启动翻译的序列或结构区域。**IRES 往往同时依赖序列模式与局部折叠,仅看短字符窗口容易遗漏远距离配对;structRFM 的结构表示与这类任务天然匹配。
与RNA-FM、SpliceBERT和AlphaFold 3不是同一种竞争关系
**structRFM 的主要定位是通用 RNA 表示底座,而不是包打天下的端到端结构系统。**RNA-FM 更接近序列语言模型基线,SpliceBERT 专注剪接相关表示,AlphaFold 3 则是面向多类生物分子复合物三维结构预测的系统。把它们放在一张表里,应该比较定位和输入输出,而不能只挑某个跑分宣布全面领先。
| 模型或系统 | 核心定位 | 预训练结构知识 | 典型输出 | 已披露规模或限制 | 开放情况 | |---|---|---|---|---|---| | structRFM | RNA 通用基础模型 | 有,二级结构引导掩码 | 序列级、核苷酸级、核苷酸对级特征 | 约 2100 万组序列—结构数据;最大输入 512 nt | 代码、模型与任务实现已开放 | | RNA-FM | RNA 序列语言模型 | 主要从序列统计规律学习 | RNA 表征及下游特征 | 在 ncRNA 分类等任务中仍是强基线 | 可用于研究 | | SpliceBERT | 剪接相关预训练模型 | 结构不是主要训练主线 | 核苷酸级剪接特征 | 更偏向剪接位点等专项任务 | 面向研究使用 | | AlphaFold 3 | 生物分子复合物三维结构预测系统 | 直接建模三维结构与分子相互作用 | 三维坐标及置信度 | 计算需求与任务形态不同 | 不属于同类 RNA 表征底座 |
**structRFM 相对 RNA-FM 的优势是把结构依赖前置到预训练阶段。**参考实验显示,两者在 nRC 非编码 RNA 分类上均达到领先水平,这意味着结构引导并不会自动在所有功能任务上形成压倒性优势;它更可能在强依赖碱基配对、长距离相互作用的任务中拉开差距。
**structRFM 相对 SpliceBERT 的优势是任务覆盖范围更宽。**SpliceBERT 这样的专项模型可以针对基因组和剪接上下文做更强的领域设计,而 structRFM 同时支持同源分类、二级结构、三级结构、IRES 和 ncRNA 分类,更适合作为研究团队统一的特征提取器。
**structRFM 与 AlphaFold 3 的关系更像上游表征和大型结构系统之间的互补。**前者只输入 RNA 序列即可提取多粒度特征,后者关注更复杂的三维构象和分子间相互作用;structRFM 的实际价值之一,是为 Zfold 等专用三维预测器提供结构先验,而不是在所有生物分子任务上直接替换 AlphaFold 3。
开源门槛不高,但512 nt上限很现实
**structRFM 已在 GitHub 提供代码、安装说明、推理流程和下游任务目录。**官方仓库覆盖零样本同源分类、零样本二级结构预测、二级与三级结构预测、ncRNA 分类、剪接位点预测和 IRES 识别,预训练检查点下载体积约 300 MB。
**约 300 MB 的检查点意味着普通实验室和个人研究者也有机会完成本地特征抽取。**不过,检查点体积并不能直接等同于完整训练成本,2100 万组配对数据的预训练仍需要相当可观的数据处理和算力投入。截至 2026 年 11 月 5 日,团队没有公布商业定价,项目当前定位是开放研究资源,而不是收费在线产品。
**最大输入长度 512 nt 是 structRFM 当前最明确的工程限制。**许多长非编码 RNA、病毒基因组片段和真核转录本远超 512 个核苷酸,直接截断可能破坏跨区段配对关系。团队目前对序列级分类采用分段后汇总的方式,但这只能保留各片段特征,难以完整建模相距数千个核苷酸的远程相互作用。
**扩展上下文长度不能只靠修改一个配置参数。**可行路线包括冻结编码器主体并重新适配位置编码、在长链 RNA 数据上继续预训练,或引入稀疏注意力和分层建模;但这些方法都会改变显存占用、训练稳定性和配对矩阵的计算复杂度。对于核苷酸对任务,长度从 512 扩展到 4096 时,完整两两关系矩阵的元素数量会从 262,144 增加到 16,777,216,扩大 64 倍。
真正的短板不是参数,而是结构标签的可信度
**structRFM 的主要风险来自单一计算结构注释源。**预训练结构由 BPfold 生成,数据虽然达到约 2100 万组,但模型可能继承标注器对经典配对、特定长度和特定 RNA 家族的偏好。规模可以降低方差,却不会自动消除系统性偏差。
**RNA 并不存在永远固定不变的唯一结构。**同一条 RNA 会受到温度、离子浓度、蛋白结合、化学修饰和细胞环境影响,并可能在多个构象之间切换。把一条序列对应到一个确定二级结构,适合大规模训练,却会简化真实生物学中的构象集合。
**下一步更值得关注的是多来源结构监督。**如果后续版本能融合热力学折叠、化学探针实验数据、共进化信号、非经典配对和三维结构约束,structRFM 才可能从结构感知语言模型进一步走向能表达不确定性和环境条件的 RNA 世界模型。
判断:这是一块可复用底座,不是RNA问题的终局答案
**structRFM 最有价值的地方是把结构知识变成了可复用的预训练信号。**过去不少 RNA 模型在下游任务上临时添加结构模块,导致每个任务都要重新设计网络;structRFM 则试图先训练一个共享编码器,再把序列级、位置级和配对级表示交给不同任务使用,这条路线更接近基础模型应有的形态。
**structRFM 登上 Nature 的意义也不在于刷新某一张榜单。**它展示了一种比单纯堆参数更适合科学模型的扩展方式:当可用序列越来越多时,与其只扩大模型,不如把领域内最关键的结构约束写进预训练目标。对于 RNA 而言,这个约束是碱基配对;对于蛋白质、材料和分子设计,类似思路也可能对应空间几何、能量函数和物理守恒关系。
**structRFM 目前更适合科研原型、候选筛选和特征提取,而不是未经验证地直接用于临床或药物决策。**它能缩小实验搜索空间、为结构模型提供先验,并帮助研究者发现潜在功能模式,但计算预测仍需实验数据验证,特别是在新型 RNA 家族、长链 RNA 和动态构象场景中。
**从开发者视角看,structRFM 已经具备值得试用的三个条件。**第一,代码和约 300 MB 的检查点可获得;第二,输出覆盖序列、单核苷酸和核苷酸对三个粒度;第三,下游示例不是单一演示,而是贯穿同源、结构和功能任务。它的 512 nt 上限和标签偏差同样清晰,研究者可以据此判断是否适合自己的数据,而不必把 Nature 论文等同于即插即用的生产系统。
参考来源
- 中国科大发布开源 RNA 序列基础模型 structRFM,成果登上 Nature:中国科大官宣信息、研究背景及主要任务概览。
- structRFM 官方 GitHub 仓库:模型代码、安装方式、检查点说明与下游任务目录。