英伟达开源交互式Cosmos 3
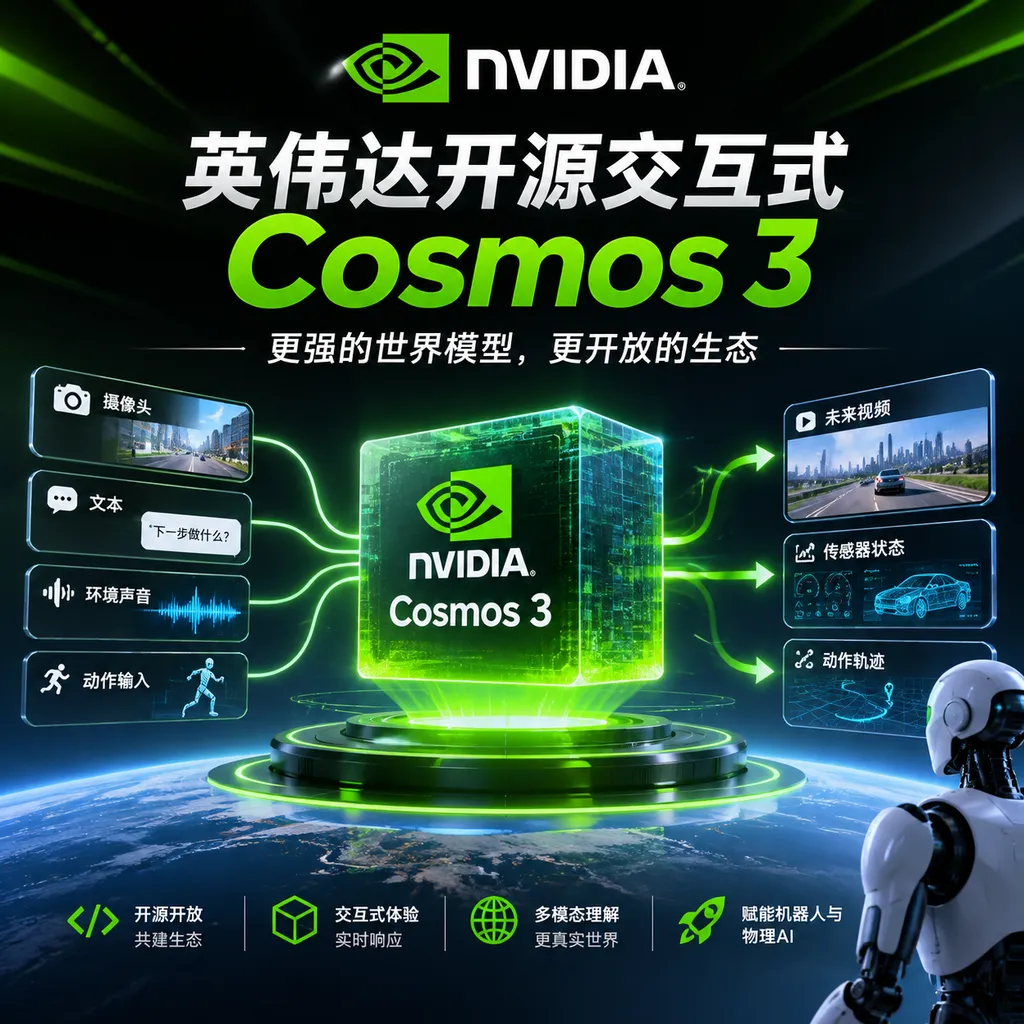
英伟达开放 Cosmos 3 交互式世界模拟模型、示例检查点与训练方案,覆盖自动驾驶、双臂机器人和多模态合成数据。它真正重要的变化,是把一次性视频生成推进到可接受动作并持续反馈的闭环模拟。
英伟达开源交互式 Cosmos 3:世界模型开始进入闭环
英伟达近日开放了 Cosmos 3 的交互式世界模拟能力,并在 Hugging Face 与 GitHub 上发布示例模型检查点、训练方案和配套工具。此次更新重点不是再做一个画面更逼真的文生视频模型,而是让 Cosmos 3 根据车辆或机器人的动作连续预测环境变化,把世界生成、动作条件控制和策略评估接进同一条闭环。
这并不是 Cosmos 3 第一次亮相。Cosmos 3 于 2026 年 5 月正式发布,7 月又增加了面向端侧实时部署的 4B 级 Cosmos3-Edge;最近一轮更新则聚焦 Interactive World Simulation,也就是交互式世界模拟。截至 2026 年 11 月 5 日,官方仓库已经列出自动驾驶、双臂机器人、多视角合成数据和视觉条件迁移等示例检查点。
世界基础模型(World Foundation Model,WFM)是一类学习真实世界状态、运动规律和动作后果,并能生成未来场景的基础模型。 与普通视频生成模型相比,它不仅要回答“下一帧看起来像什么”,还要回答“如果车辆向左转、机械臂抬起杯子,接下来会发生什么”。这一区别决定了 Cosmos 3 的主要用户不是短视频创作者,而是机器人、自动驾驶和工业视觉团队。
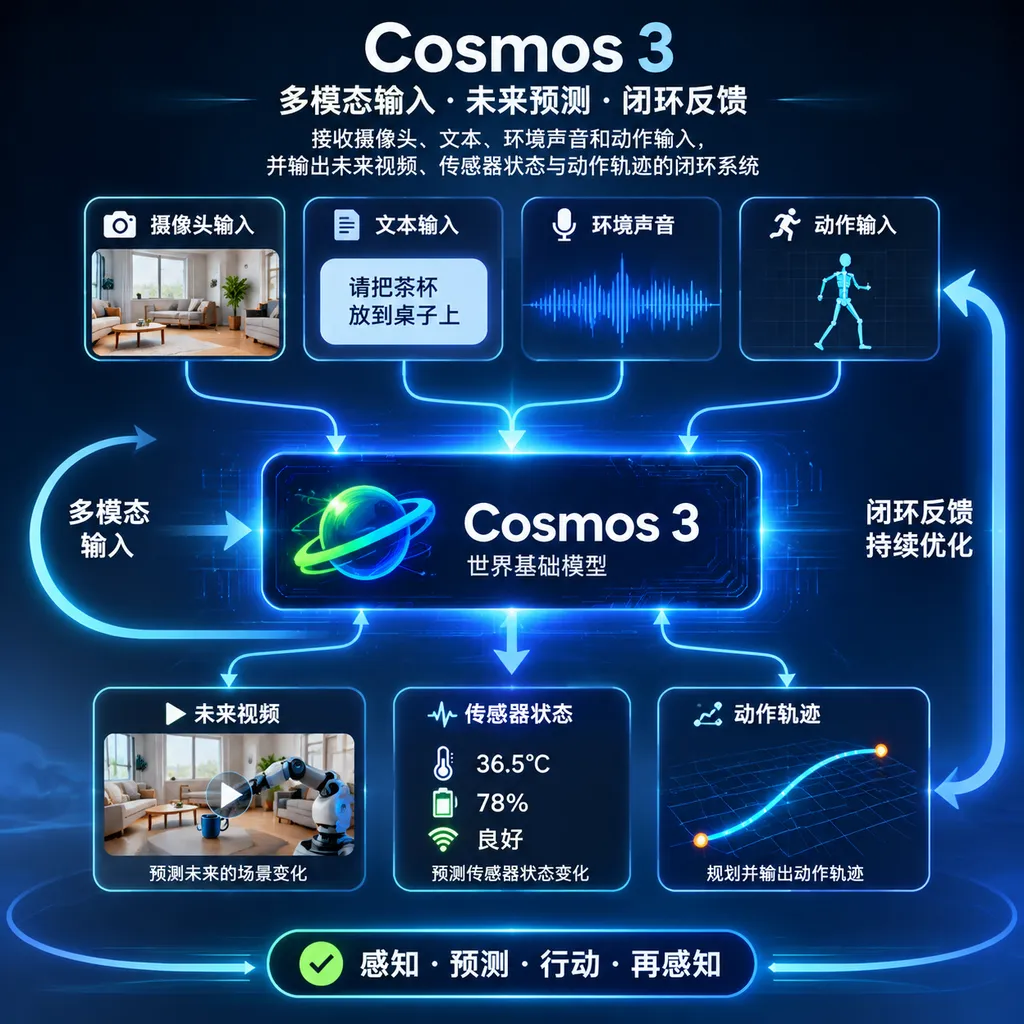
这次开放的核心,是让模型对动作作出连续反馈
交互式世界模拟是指模型接收当前环境与外部动作,预测下一状态,再把预测结果送回系统继续推演的闭环过程。 一次图生视频只需要生成几秒钟合理画面,闭环模拟却必须在连续多轮预测中保持车辆位置、物体状态、碰撞关系和操作结果的一致性。
这一变化可以用自动驾驶测试来理解。传统视频生成模型能够把一张街景图延展成“车辆继续前进”的视频,但它未必真正响应方向盘转角、油门、刹车和路线选择;交互式模型则需要在收到左转动作后,持续更新多路摄像头视角、道路相对位置乃至 LiDAR 表征,使后续画面与动作保持一致。
机器人场景面临同样的问题。一个双臂机器人准备拿起桌上的杯子时,世界模型需要根据两只机械臂的动作预测杯子是否移动、是否滑落、是否与另一只手碰撞,并把结果反馈给策略模型。模型如果只会生成“看起来像拿起杯子”的视频,却不能稳定对应具体关节动作,就无法用于可靠的策略评估。
根据 NVIDIA 在 Hugging Face 发布的交互式世界模拟说明,此次更新提供了面向物理 AI 的示例检查点和训练方案。官方 GitHub 仓库目前列出的代表性模型如下:
| 示例检查点 | 基础版本 | 输入与输出重点 | 主要用途 | |---|---|---|---| | Cosmos3-Nano-Sim-Auto | Cosmos 3 Nano | 多视角画面、动作与 LiDAR | 自动驾驶闭环模拟 | | Cosmos3-Nano-Transfer-Auto | Cosmos 3 Nano | 最多 11 路视角与 LiDAR | 自动驾驶合成数据生成 | | Cosmos3-Nano-Sim-Bimanual | Cosmos 3 Nano | 双臂机器人观测与动作 | 交互式机器人策略模拟 | | Cosmos3-Nano-Sim-Transfer | Cosmos 3 Nano | 视频到深度、分割、边缘、模糊等条件 | 自回归视觉数据转换 | | Cosmos3-Super-Text2Image | Cosmos 3 Super | 文本到单帧图像 | 高质量视觉生成与数据起始帧构造 |
这组模型透露出英伟达清晰的产品思路。Cosmos 3 并不打算用一个超大检查点覆盖所有部署场景,而是以统一架构为底座,再针对自动驾驶、机器人和合成数据生成进行后训练。开发团队可以从通用世界知识出发,继续适配自己的摄像头位置、机器人本体和动作空间,而不必从零训练完整的视频模型。
Cosmos 3 不是一个模型拼盘,而是两座协作的塔
Cosmos 3 是一个同时理解并生成文本、图像、视频、环境声音和动作的全模态世界模型。 英伟达将其称为面向 Physical AI 的 omni-model,目标是把场景理解、物理推理、未来预测和动作生成放进统一底座,而不是分别部署视觉语言模型、视频生成模型和机器人策略模型。
物理 AI(Physical AI)是能够感知现实环境、推理物理关系并通过动作影响现实世界的人工智能系统。 机器人、自动驾驶汽车、智能仓库和工业设备都属于这一范畴,它们面对的不是纯文本中的逻辑问题,而是带有时空约束、传感器噪声和安全风险的连续环境。
Cosmos 3 的核心架构被称为 Mixture-of-Transformers。它不是常见意义上通过路由器选择稀疏专家的 MoE,而是让推理 Transformer 与生成 Transformer 分工协作:前者理解对象、意图和时空关系,后者生成视觉、声音和动作结果。
| 模块 | 主要输入 | 主要输出 | 负责的问题 | |---|---|---|---| | Reasoner 推理塔 | 文本、视觉 | 文本 | 场景理解、物体定位、任务规划、具身推理 | | Generator 生成塔 | 文本、视觉、音频、动作 | 视觉、音频、动作 | 世界模拟、未来预测、合成数据、策略学习 |
这种设计的价值在于先“想明白”,再“生成出来”。一辆车准备驶入路口时,推理塔可以识别红绿灯、行人意图和车辆优先级,生成塔则根据这些中间知识与控制动作推演未来视频和轨迹。相比只在像素空间寻找统计连续性,这条路线更有机会减少明显违反常识的运动。
Cosmos 3 的生成部分还结合了自回归建模与扩散式建模。自回归路径保留语言和条件信息的因果顺序,扩散路径则允许待生成的视觉、音频或动作 token 进行更充分的双向交互;通过改变哪些 token 是条件、哪些 token 需要预测,同一套骨干可以覆盖文生图、图生视频、未来动力学、逆动力学和策略生成等任务。
这一统一方式并不等于所有任务已经被彻底解决。视频像素、声音波形和机器人动作的统计结构差异很大,因此 Cosmos 3 仍要使用视觉编码器、VAE 和动作投影层处理不同模态。所谓统一,主要发生在共享世界知识和 Transformer 骨干层面,而不是把所有原始数据不加处理地塞进相同输入框。
真正有用的不是“会做视频”,而是可以当作策略训练场
世界动作模型(World Action Model,WAM)是根据环境状态与候选动作预测未来结果,并可进一步生成动作策略的模型。 Cosmos 3 可以作为 WAM 的基础骨干,让开发者用自己的机器人录像、动作轨迹和传感器数据进行后训练,得到面向具体本体和任务的策略模型。
机器人团队过去常把感知、规划、动作和模拟拆成多套系统。视觉语言模型负责识别物体和生成计划,动作模型负责输出关节轨迹,物理引擎或视频模型负责预演结果;任何一环的数据格式或时间尺度不一致,都可能造成误差。Cosmos 3 的意义,是尝试用共享表征降低这些模块之间的翻译成本。
闭环模拟也可以降低真实设备测试的门槛。假设仓库团队要验证机器人在纸箱倒塌、人员突然进入通道或照明变化时的表现,全部使用真机采集既昂贵又危险;世界模型可以生成大量可控场景,让策略先在模拟环境中暴露问题,再进入真实测试。
自动驾驶会是这套方案最直接的落地场景之一。Cosmos3-Nano-Sim-Auto 同时面向多视角视频与 LiDAR,意味着它不仅要维持前视画面的连贯,还要让不同摄像头和深度信息描述同一个三维世界。多视角不一致是视频世界模型的常见短板:前摄像头中的车辆如果转瞬出现在侧视图错误位置,模拟结果就无法用于驾驶策略评估。
合成数据生成则可能比全自动策略学习更早产生商业价值。Cosmos3-Nano-Transfer-Auto 支持最多 11 路视角与 LiDAR,可用于扩大长尾驾驶数据;Cosmos3-Nano-Sim-Transfer 能把视频转换为深度、语义分割、边缘等监督信号,减少逐帧人工标注成本。对于缺少罕见事故、极端天气或复杂仓库故障样本的团队,这类能力比单纯提升视频美感更实用。
Cosmos、Omniverse 与传统视频模型不是同一种产品
Cosmos 是学习世界规律并生成未来状态的模型平台,Omniverse 则是依靠 3D 场景、渲染与仿真组件构建可控数字环境的平台。 前者更像一个从数据中学会预测的“神经模拟器”,后者更像拥有明确几何、材质和物理规则的“工程模拟器”。
两者并不是替代关系。开发者可以先在 Omniverse 中构建可精确控制的机器人或驾驶场景,再把渲染结果交给 Cosmos Transfer 转换为更接近真实摄像头的合成数据;也可以使用真实数据后训练 Cosmos,让模型快速生成传统 3D 仿真难以覆盖的复杂分布。
| 方案 | 核心机制 | 优势 | 主要局限 | 适合场景 | |---|---|---|---|---| | Cosmos 3 交互式世界模型 | 从数据中学习时空与动作规律 | 生成快、场景分布丰富、可适配真实数据 | 长时一致性和物理可靠性仍需验证 | 策略预训练、合成数据、候选动作推演 | | NVIDIA Omniverse | 3D 场景、RTX 渲染与显式仿真 | 参数可控、几何关系清晰、结果可复现 | 搭建资产和规则成本较高 | 工业数字孪生、确定性测试、仿真验证 | | 普通视频生成模型 | 根据文本或图像生成视频 | 视觉质量高、使用简单 | 通常缺少动作接口和传感器一致性 | 内容制作、概念演示 | | 传统机器人策略模型 | 从观测直接预测动作 | 推理路径短、容易针对任务优化 | 缺少显式未来模拟,数据依赖强 | 固定本体与单一任务控制 |
Cosmos 3 当前最值得肯定的地方是工程整合,而不是“已经理解现实世界”的宣传口号。它把理解、生成和动作统一到一个可后训练底座中,并公开了面向具体任务的检查点与训练方案,这比只展示几段精心挑选的视频更接近开发者真正需要的基础设施。
开放模型不等于低成本,也不等于可直接上线
开放权重是指开发者可以获取模型参数并自行部署或后训练,但它不代表计算、数据和验证成本为零。 Cosmos 3 虽然通过 Hugging Face、Diffusers 和官方 GitHub 降低了接入门槛,视频与多视角传感器生成仍然属于高计算负载,部署成本会明显高于普通视觉语言模型。
英伟达也在用不同规格覆盖硬件层级。4B 级 Cosmos3-Edge 面向 Jetson AGX Orin、Jetson Thor 和 RTX PRO 6000 等设备的实时或近实时任务;更高质量的 Nano、Super 及任务后训练版本,则更适合数据中心训练、批量合成数据和高保真模拟。对开发团队而言,实际选择标准不应只是画质,而是单步延迟、显存占用、可模拟时长和闭环稳定性。
模型许可同样需要在商用前逐项核对。英伟达将 Cosmos 3 定位为 fully open omni-model,并公开模型、工具和部分训练方案,但企业仍应查看具体检查点对应的模型许可、训练数据说明和可接受使用政策。“能下载”与“可在任意业务中无条件使用”不是同一个概念。
最大风险仍是长时误差累积
闭环世界模型的核心难题是滚动误差会反过来污染下一步输入。 单次预测中一个不明显的位置偏差,经过几十轮自回归推演后,可能变成车辆穿模、物体凭空消失或机械臂抓取点漂移。普通视频生成可以把这些问题视为画面瑕疵,物理 AI 却可能因此学到错误策略。
物理准确性也不能只靠视觉逼真度判断。一杯水洒落的视频即使光影自然,也不代表模型正确掌握液体、摩擦力和抓取力;一辆车平稳通过路口,也不代表其 LiDAR、摄像头和动作轨迹在毫米与毫秒尺度上保持一致。世界模型要进入安全关键系统,仍需与显式仿真、真实回放和封闭场地测试交叉验证。
官方所称的领先性能也需要更多第三方复现。Cosmos 3 在视觉生成、驾驶推理和策略任务上的结果证明统一架构具备竞争力,但交互式版本更关键的指标应该包括动作响应准确率、多视角一致性、长时漂移、碰撞预测、传感器同步和真实策略迁移收益。单一画质分数很难覆盖这些问题。
我们的判断:这是世界模型从演示走向工具的一步
Cosmos 3 交互式更新的价值高于又一次文生视频升级。它给开发者的不是单纯生成更漂亮的未来画面,而是一套能够接受动作、输出多模态未来状态并继续滚动推演的基础模型,这正是机器人和自动驾驶训练所缺少的中间层。
英伟达的优势也不只在模型本身。Cosmos 可以向下连接 Jetson、RTX PRO 和 GB200,横向连接 Omniverse、Isaac 与自动驾驶工具链,再通过 Hugging Face 和 Diffusers 接触开源开发者。对一家同时控制训练芯片、边缘计算、仿真平台和模型框架的公司来说,世界模型是把这些产品串成闭环的重要接口。
Cosmos 3 目前仍更适合作为策略预训练器、合成数据引擎和候选动作模拟器,而不是替代经过验证的物理引擎或直接控制安全关键设备。它能把训练与评估周期从按月迭代压缩到更短周期,但最终上线仍然离不开真实数据、规则约束和硬件测试。
世界模型的竞争标准也正在发生变化。下一阶段比拼的不再只是“能生成多长的视频”,而是谁能在数百次连续交互后仍保持世界状态稳定,谁能让模拟中学到的策略真正迁移到车辆和机器人上。Cosmos 3 已经把这场竞争从视频生成拉向了可执行的物理 AI 基础设施。
参考来源
- New NVIDIA Cosmos 3 Open Models for Interactive World Simulation:Hugging Face 发布的 Cosmos 3 交互式世界模拟更新说明,介绍新模型与任务场景。
- Welcome NVIDIA Cosmos 3: The First Open Omni-model for Physical AI Reasoning and Action:介绍 Cosmos 3 的全模态能力、物理 AI 用途及 Diffusers 集成。
- NVIDIA Cosmos GitHub 仓库:Cosmos 官方代码、模型家族说明、示例检查点、训练资源与版本更新记录。