淘宝把手机模型压到173MB
淘宝 MNN 团队开源 MNN-Pocket-0.3B,INT4 部署包仅 173MB,在 iPhone 18 Pro 上离线解码约 350 token/s,目标是让大模型真正成为手机应用的常驻模块。
淘宝旗下 MNN 团队于 11 月 6 日开源 MNN-Pocket-0.3B,一款约 3 亿参数、面向手机应用从零设计的中英双语语言模型。它没有继续追逐更大的参数规模,而是把目标锁定在三个直接影响移动端落地的数字上:峰值内存低于 300MB、解码吞吐超过 200 token/s、典型单次推理增量能耗不超过参考手机电池能量的万分之一。
这组指标比“端侧大模型”这个标签更值得关注。MNN-Pocket-0.3B 的 INT4 MNN 部署文件只有 173MB,在 iPhone 18 Pro 上完全离线运行时,平均解码速度约为 350 token/s;在 iPad Pro M5 的 Metal 后端上,解码速度进一步达到 466 token/s。对于一款需要与图片、视频、交易、地图等模块争夺资源的综合型手机应用,这比再做一个缩小版聊天机器人更实际。
**MNN-Pocket-0.3B 是一款围绕手机内存、速度和能耗预算协同设计的约 0.3B 参数轻量语言模型。**它的核心卖点不是在通用榜单上挑战 7B 或 8B 模型,而是在有限任务范围内,用不到 300MB 的推理内存完成指令理解、信息提取、文本生成和轻量推理。
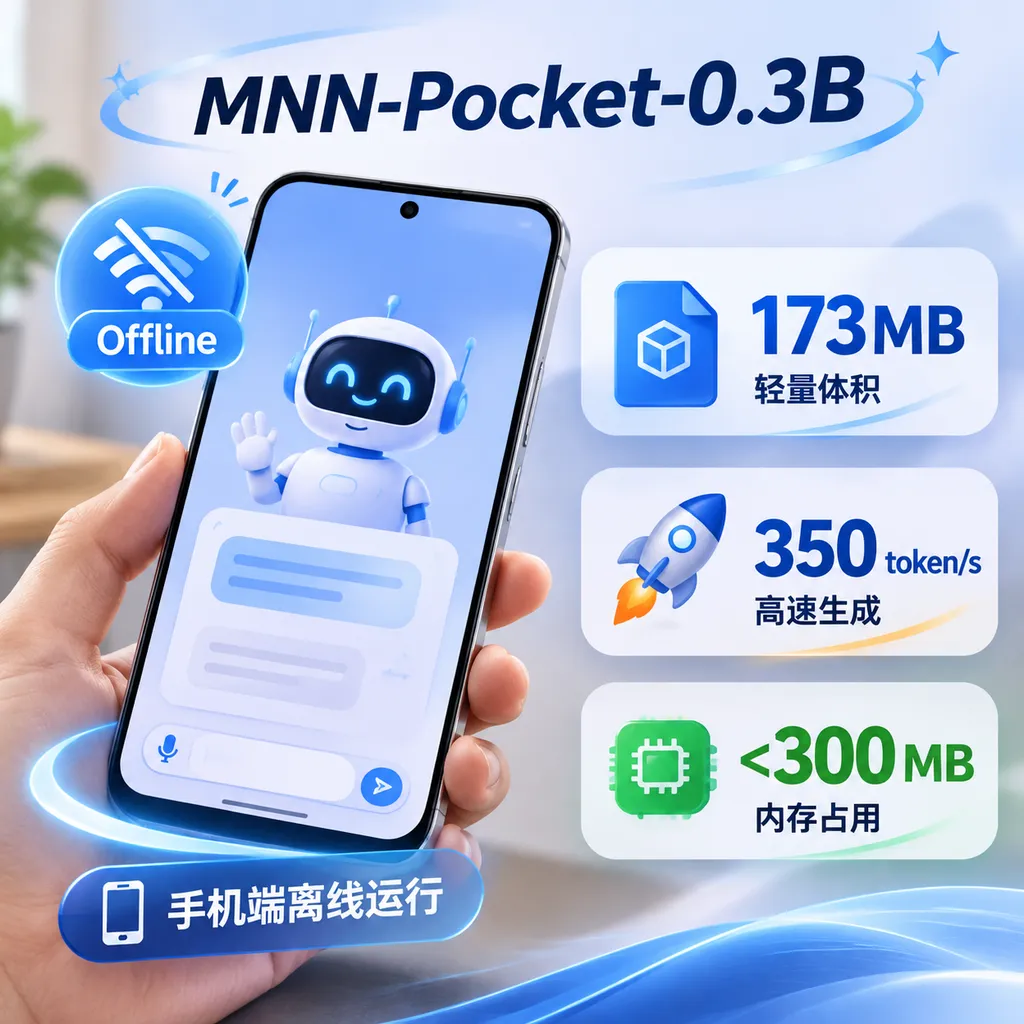
173MB 部署包,比 Qwen3-0.6B 小约一半
**173MB 的完整部署体积是 MNN-Pocket-0.3B 最有现实意义的指标。**这个 INT4 MNN 文件不只是裸权重,还包含模型权重、分词器、计算图和推理配置,因此更接近开发者真正需要放进安装包或按需下载的模块大小。
官方在 iPad Pro M5、Metal 后端和 512 token 上下文配置下进行了对照测试。MNN-Pocket-0.3B 从加载到推理的峰值 Metal 驻留内存,相对加载前基线增加 228MB;同一条件下,Qwen3-0.6B 的部署文件为 340MB,峰值内存增量为 427MB。
| 模型 | 参数规模 | 量化与部署格式 | 部署文件体积 | 峰值内存增量 | iPad Pro M5 Decode | 主要定位 | |---|---:|---|---:|---:|---:|---| | MNN-Pocket-0.3B | 约 3 亿 | INT4 / MNN | 173MB | 228MB | 466 token/s | 手机应用内嵌任务 | | Qwen3-0.6B | 约 6 亿 | 同条件端侧部署 | 340MB | 427MB | 286 token/s | 通用轻量语言模型 |
**MNN-Pocket-0.3B 相比 Qwen3-0.6B 的部署体积减少约 49%,峰值内存增量减少约 47%。**在相同 iPad 测试条件下,它的 466 token/s 解码吞吐则是 Qwen3-0.6B 的约 1.63 倍。
这里需要强调,228MB 是相对加载前基线增加的 Metal 驻留内存,并不等于应用的总内存占用。手机应用本身、运行时、KV Cache、输入长度以及其他业务模块都会继续占用内存,开发者不能简单地把 228MB 当成最终整包的运行预算。
**把模型推理峰值压到 300MB 以下,是为了给上下文和应用集成留下空间。**即使旗舰手机已经普遍拥有 8GB 至 16GB 内存,系统、前台应用、WebView、图片缓存和后台任务仍会共享这些资源。一个静态权重只有两三百兆、运行时却膨胀到 1GB 以上的模型,很难成为高频常驻能力。
350 token/s,快到生成速度不再是主要瓶颈
**解码吞吐是模型逐字输出阶段每秒生成的 token 数量。**它直接决定用户点击按钮后,答案是缓慢“挤出来”,还是近似瞬间铺满屏幕。
MNN-Pocket-0.3B 在 iPhone 18 Pro 上通过 MNN 推理引擎完全离线运行,平均 Decode 约为 350 token/s。按照一条回答生成 128 token 计算,仅看解码阶段,理论耗时约为 0.37 秒;实际端到端延迟还要叠加模型加载、输入处理、调度和界面渲染,因此不能把这个数字直接理解为完整响应时间。
**Prefill 是模型一次性处理用户输入的阶段,Decode 则是模型逐 token 生成输出的阶段。**前者影响长提示词和长文档的首字延迟,后者影响用户看到答案后的连续输出速度。
在 iPad Pro M5、Metal 后端、512 token 测试配置下,MNN-Pocket-0.3B 的 Prefill 吞吐达到 8,721 token/s,Decode 吞吐达到 466 token/s。测试采用 MNN 3.6.2、INT4 量化和统一运行设置,每组配置预热一次、测量五次并取吞吐中位数。
| 设备与后端 | 上下文配置 | Prefill 吞吐 | Decode 吞吐 | 说明 | |---|---:|---:|---:|---| | iPhone 18 Pro / MNN | 官方真机配置 | 未披露 | 约 350 token/s | 完全离线运行 | | iPad Pro M5 / Metal | 512 token | 8,721 token/s | 466 token/s | INT4,五次测试取中位数 | | Snapdragon 8 Gen 5 / CPU | 512 token | 未披露 | 251 token/s | 未依赖移动 GPU 后端 |
**Snapdragon 8 Gen 5 仅使用 CPU 后端也能达到 251 token/s,说明这套方案并非只为苹果 Metal 优化。**不过,不同手机的散热策略、内存带宽、线程调度和系统负载差异明显,短时跑分也不能代表连续运行十分钟后的稳定吞吐。
350 token/s 对普通聊天来说甚至有些“性能过剩”。人类阅读速度远低于这一水平,真正的价值是模型可以在界面展示结果前完成分类、改写、结构化提取或多候选生成,让本地 AI 从一个需要等待的功能变成应用内部近乎无感的基础模块。
0.3B 为什么还能做任务
**手机应用原生大模型是从应用任务和设备预算出发设计,而不是把云端模型直接缩小后塞进手机的模型。**这意味着模型结构、词表、训练数据、量化方式和推理引擎都要围绕同一组资源约束共同优化。
MNN 团队没有只对现成模型做 INT4 量化,而是从零设计并训练 MNN-Pocket-0.3B。官方技术报告将模型结构控制、词表设计、训练数据、预训练、后训练和 MNN 运行时放进同一个优化流程:参数规模控制总体计算量,词表影响嵌入层体积与输出层计算成本,推理引擎则决定这些理论优势能否转化为真机速度。
**词表并不是越大越好,而是要在分词效率和输出计算成本之间取平衡。**过大的词表会让嵌入层和最终分类头变重,过小的词表又会把中文句子切成更多 token,增加上下文长度和解码步数。对于只有 3 亿参数的模型,词表设计带来的占比远高于大模型,不能沿用云端模型的配置后再简单压缩。
**MOPD 是一种让多个领域教师共同指导同一个小模型的 On-Policy 蒸馏方法。**MNN-Pocket-0.3B 为数学、代码、知识和指令遵循构建不同教师路线,并根据样本所属领域选择教师,避免单一教师在所有任务上平均但不够专长。
On-Policy 的关键是先让学生模型生成,再由教师针对学生真正到达的生成状态提供 token 分布监督。与只学习标准答案相比,这种方式更像教师观察学生实际做题过程,再纠正它容易走错的步骤;对于容量有限的小模型,密集的概率分布信号通常比单个正确 token 提供的信息更多。
**SFT Loop Engine 是围绕失败案例持续补充监督微调数据的迭代机制。**它把模型在业务任务中的错误归类,生成或筛选对应训练样本,再通过回归评测检查新数据是否改善目标能力、是否导致其他能力退步。这类训练闭环比一次性堆积通用语料更适合需求快速变化的手机应用。
“达到 8B 效果”必须加上业务场景限定
**MNN 团队提出的是在指定业务场景达到 8B 级模型效果,而不是全面取代 8B 通用模型。**这是理解 MNN-Pocket-0.3B 能力边界的前提。
0.3B 与 8B 之间相差约 26 倍参数规模,小模型不可能凭借量化和推理优化凭空获得同等的世界知识容量。它更适合边界明确、输出格式稳定、上下文中已经提供关键信息的任务,例如商品信息归纳、站内意图识别、页面文本改写、表单补全、短摘要以及固定流程的工具选择。
**MNN-Pocket-0.3B 不适合被当作高可靠知识库或复杂推理代理。**开放域事实问答、长链数学证明、大型代码库理解和需要持续规划的多步骤任务,仍然更依赖参数规模、上下文能力以及外部检索系统。0.3B 模型即使能生成流畅答案,也不代表事实准确率与大模型相同。
官方目前强调中英文理解、世界知识、数学、代码和指令遵循,但此次材料中最突出的仍是系统指标,而不是覆盖所有主流基准的绝对成绩。因此,“8B 级效果”应被理解为特定任务经过训练、蒸馏和评测后的目标,不宜延伸成通用能力结论。
功耗目标比峰值跑分更难验证
**MNN-Pocket-0.3B 的功耗目标是典型单次推理增量能耗不超过参考手机电池能量的万分之一。**官方给出的典型负载为输入 512 至 1024 token、输出 128 token,换算后即 100 次推理消耗不超过电池总能量的 1%。
这个目标针对的是高频调用,而不是偶尔聊天。假设电商应用在搜索、商品详情、客服输入和订单页面都使用本地模型,一天触发几十次并不困难;如果每次调用都让芯片长时间满载,即使响应很快,也会带来发热、降频和明显续航损耗。
**功耗数据需要结合设备型号、屏幕状态、温度和测量基线才能比较。**目前披露的万分之一更接近设计目标,不能直接视为所有设备上的独立实测结论。尤其是持续推理时,系统可能从短时高性能状态转入热限制,速度和每 token 能耗都会变化。
DFlash2 用一次草稿生成 8 个 token
**DFlash2 是为 MNN-Pocket-0.3B 配套的推测解码草稿模型。**传统自回归解码每次前向计算只预测一个 token,而 DFlash2 可在一次草稿前向中提出一个包含 8 个 token 的候选块,再由目标模型一次性验证。
这套机制类似让轻量助手先写出一小段草稿,再由主模型批量审阅。候选 token 接受率越高,目标模型需要执行的串行步骤越少;如果草稿频繁猜错,验证开销就会抵消一部分加速收益。
官方在 Hugging Face 上提供的 MNN-Pocket-0.3B-DFlash2 草稿权重约为 130MB,采用 BF16 格式,并复用目标模型的分词器。官方说明数学和代码负载通常比聊天负载受益更多,但实际加速比例仍取决于设备、后端、任务和平均接受长度。
**DFlash2 不能和 173MB 的基础部署体积简单相加后仍宣称低于 300MB 峰值。**草稿模型会引入额外权重和运行时内存,是否值得启用取决于具体设备:高端手机可能用空间换更低延迟,内存紧张的中端设备则更适合直接运行目标模型。
MNN-Pocket 真正瞄准的是应用内部组件
**MNN 是阿里巴巴开源的跨平台轻量推理引擎,支持在移动设备上通过 Metal、OpenCL 和 CPU 等后端执行神经网络。**MNN-Pocket-0.3B 与 MNN 运行时共同设计,使它避开了“模型权重能下载,但真机跑不动”的常见端侧部署问题。
对开发者而言,这款模型最有吸引力的场景不是独立聊天应用,而是嵌入原有产品:
- 在输入框旁完成离线改写、纠错和摘要;
- 根据当前页面内容抽取商品参数或生成结构化字段;
- 在网络不稳定时完成意图分类和基础问答;
- 先由本地模型判断任务复杂度,再决定是否交给更大的云端模型;
- 对敏感文本先在设备上预处理,减少原始数据离开终端的需求。
**本地推理的优势是低网络延迟、弱网可用和数据不必默认离开设备。**但这并不自动等于绝对隐私,应用日志、崩溃报告、输入法、系统备份和后续网络请求仍可能传输数据,开发者需要从整个数据链路而不是单个模型位置判断隐私风险。
MNN-Pocket-0.3B 目前最强的竞争力,可以概括为“足够快、足够小,并且是按完整部署链路优化”。它未必是同参数档能力最强的模型,却比许多只给出权重大小、不披露运行时峰值的端侧项目更接近真实产品条件。
结论:这不是缩小的大模型,而是放大的应用组件
**MNN-Pocket-0.3B 的意义在于把端侧模型的讨论从参数量拉回系统预算。**173MB 部署文件、228MB Metal 内存增量、iPhone 18 Pro 约 350 token/s、iPad Pro M5 约 466 token/s,以及 Snapdragon 8 Gen 5 CPU 上 251 token/s,这些指标共同说明 0.3B 模型已经可以成为旗舰手机中的高频本地模块。
它的限制同样清楚:3 亿参数无法全面复刻 8B 模型的知识和推理能力,功耗目标仍需要更多设备上的长期测试,真机速度也会随上下文、后端和散热条件变化。开发者真正需要评估的,不是它能否回答所有问题,而是自己的任务是否足够明确,能否通过蒸馏、微调和上下文约束把问题压缩到 0.3B 模型可以稳定解决的范围。
**如果这一方向成立,手机 AI 的下一阶段不会是每个应用都塞进一个万能助手,而是大量原本依赖规则、网络请求和小型分类器的功能,被一个 200MB 左右的语言模型统一接管。**MNN-Pocket-0.3B 还不是这条路线的终点,但它给出了一个比“端侧运行成功”更严格的起点:模型不仅要跑起来,还要小到能集成、快到不用等、低功耗到可以每天调用上百次。
参考来源
- IT之家:淘宝 MNN 团队开源 0.3B 手机模型 —— 汇总 MNN-Pocket-0.3B 的发布时间、真机速度、部署体积和内存测试数据。
- Hugging Face:MNN-Pocket-0.3B-DFlash2 —— 官方草稿模型页面,介绍 DFlash2 的 8-token 候选块、权重格式和推测解码机制。
- GitHub:Alibaba MNN —— MNN 跨平台轻量推理引擎的官方开源仓库。