Pangram用热力图揪出AI修图
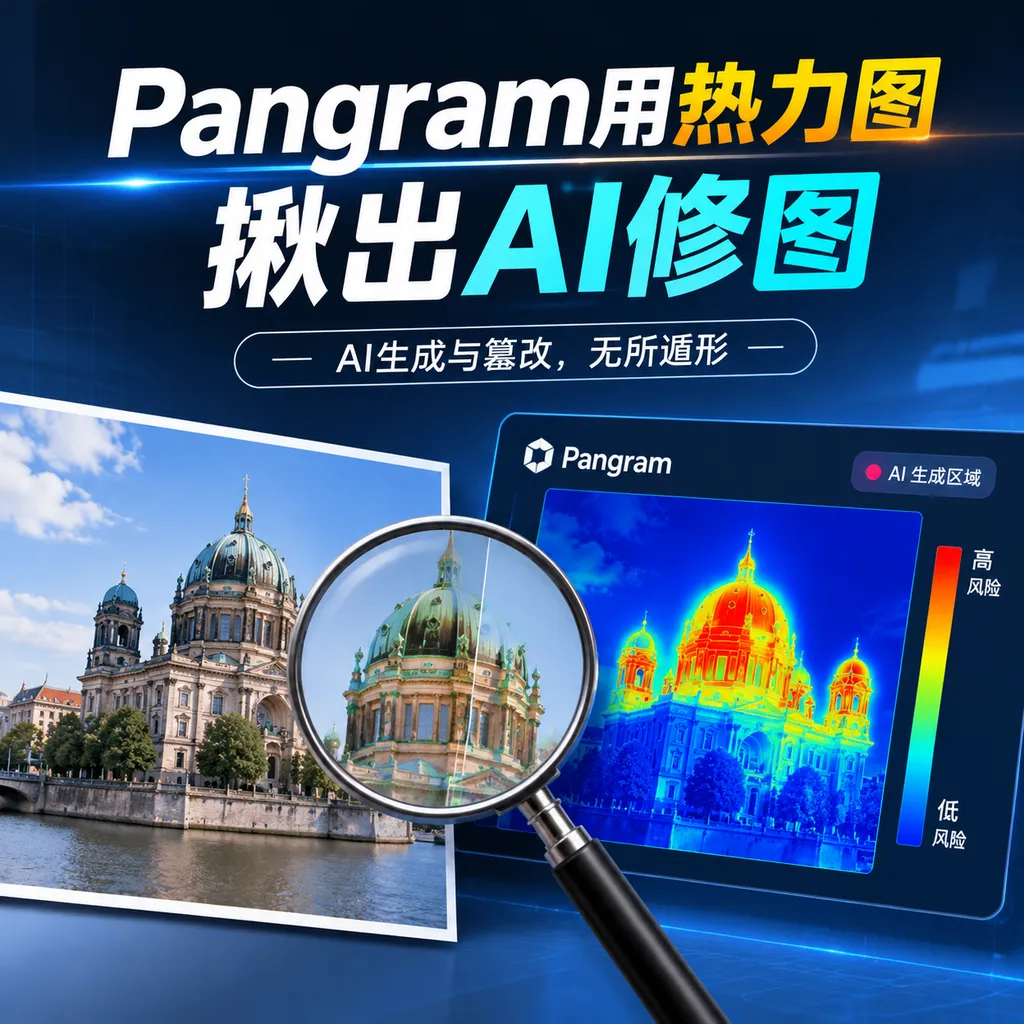
Pangram Image 1.0 于 11 月 4 日发布,可判断图片是否由 AI 生成,并用热力图定位局部生成痕迹。其自建配对测试准确率达 99.96%,但这一数字不能直接等同于开放互联网场景表现。
Pangram Image 1.0 正式发布
Pangram Labs 于 11 月 4 日正式发布 Pangram Image 1.0,核心升级不只是判断一张图片是否由 AI 生成,而是用热力图指出图片中哪些区域最可能包含生成痕迹。
截至 11 月 6 日,这款模型已经从几个月前的研究预览版转为 1.0 正式版本。与旗舰模型一起发布的还有体积更小、速度更快的 Pangram Image Flash 1.0,后者主要承担视频逐帧检测;Pangram 同时更新了浏览器扩展、原生视频上传和图像及视频检测接口。
**Pangram Image 1.0 是一款基于像素特征识别 AI 生成图像及局部合成内容的视觉检测模型。**它不要求图片保留水印,也不依赖 EXIF 元数据,而是尝试从图像本身寻找生成模型留下的统计特征。
这次发布最值得关注的并不是 99.96% 这个足够吸睛的数字,而是热力图和低分辨率鲁棒性。前者让检测结果从一个难以解释的概率,变成可供人工复核的区域提示;后者则决定了模型离开实验室之后,面对社交平台压缩图、聊天截图和二次编辑素材时还能不能工作。
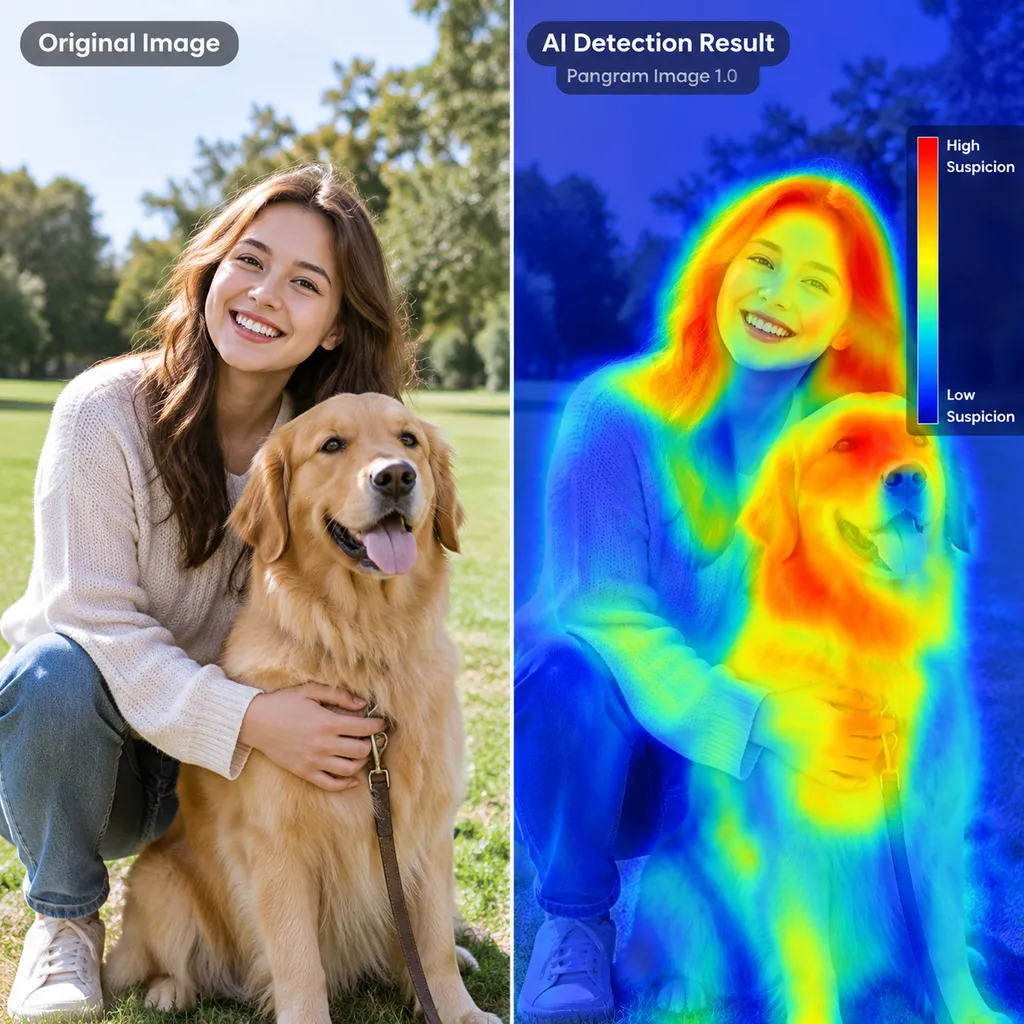
热力图比单一概率更有实际价值
**AI 图像检测热力图是将模型对生成痕迹的判断映射到图片不同区域的可视化结果。**如果一张真实街景照片里嵌入了一块 AI 生成的广告牌,普通分类器往往只能给出“整张图疑似 AI”的结论,而热力图可以进一步把注意力集中到广告牌附近。
Pangram 表示,热力图能力来自一种复合训练方法。训练过程中,团队将 AI 生成图像与人类拍摄图像分层组合,让模型同时学习全局生成特征和局部拼接特征,而不是只记住某一类图片的整体风格。
这种设计对现实世界尤其重要。当前大量争议图片并非完全由 AI 从零生成,而是经历了局部重绘、对象替换、扩图、换脸、背景生成或截图嵌套。例如,电商卖家可能只生成商品使用效果,房源发布者可能替换窗外景观,新闻图片也可能只有烟雾、标语或人物被修改。
传统的二分类结果很难处理这些混合图像。模型如果输出 70% 的 AI 概率,用户仍然不知道是整张图可疑,还是只有角落里的海报可疑;一旦检测器误把截图中的生成图片归因到整个页面,结论还可能产生误导。
热力图因此更像医学影像里的“疑似病灶标注”,而不是最终诊断。它能缩短人工核查路径,却不能单独证明某个区域一定由 AI 生成。新闻机构、内容平台和风控团队仍然需要结合原始文件、发布链路、内容凭证以及反向图像搜索进行判断。
99.96% 准确率,需要看清测试边界
**Pangram 报告的 99.96% 准确率来自公司自行构建的真实—合成配对评估集。**团队选取了 100 张真实照片,并使用 12 种前沿 AI 图像生成器制作与原图内容高度匹配的合成图片,共得到 1,200 张生成图像。
Pangram 的测试思路比随机收集网络图片更严格一些。每张合成图片使用与真实照片高度匹配的提示词,尽量让真实样本和生成样本具有相似的场景与主体,减少检测器通过“某种内容经常由 AI 生成”来投机判断的机会。
| 指标或能力 | Pangram Image 1.0 公布结果 | 应该如何理解 | |---|---:|---| | 自建配对图像测试准确率 | 99.96% | 来自 Pangram 自建数据集,不等于所有网络图片上的通用准确率 | | 覆盖的图像生成器 | 12 种 | 测试面向发布时的前沿生成器,但未公开所有分布细节 | | 256×256 图像准确率 | 96.4% | 分辨率下降后仍可检测,但比高分辨率场景更不稳定 | | 官方公告中的 AI 图像识别率 | 99.2% | 属于另一组产品口径,不能与 99.96% 直接混用 | | 官方公告中的误报率 | 0.27% | 表示少量真实图像仍可能被判为 AI,规模化使用时不能忽略 | | 商用检测器对比测试 | 99.5% | Pangram 产品页称测试集含 1,130 张图像,第二名为 98% | | Pangram Image Flash 1.0 在 DF26 的准确率 | 98.7% | 官方称领先第二名 29 个百分点,主要反映视频检测表现 |
99.96% 并不意味着每 10,000 张互联网图片只会错 4 张。准确率会受到真实与生成样本比例、生成器类型、压缩方式、图片内容以及判定阈值影响,而现实平台上的数据分布通常远比评测集复杂。
误报率在大规模平台上甚至比总准确率更关键。假设某内容平台每天扫描 1,000 万张真实图片,即便误报率保持在 0.27%,理论上也会产生约 2.7 万条误报;如果这些结果直接触发下架或账号处罚,运营成本和申诉压力都会非常高。
Pangram 的数字更适合被理解为“在受控配对测试中具有很强区分能力”,而不是“已经解决 AI 图像鉴定”。在没有完整公开测试集、模型阈值、类别比例和逐生成器结果之前,外界仍无法独立复现 99.96% 的结论。
压缩、缩放和二次编辑才是真正难点
**鲁棒性是检测器在图片被压缩、缩放、模糊、加噪或重新编辑后仍能维持判断能力的指标。**大多数图片从生成工具流向社交网络后,都会经历格式转换、分辨率调整和有损压缩,这些操作可能直接破坏检测器依赖的细微纹理。
Pangram 称 Image 1.0 专门针对压缩、缩小尺寸、模糊和噪声等变换进行了训练。这些变换既可能由社交平台自动引入,也可能是用户为了规避检测而主动添加。
低分辨率检测是本次正式版相较研究预览版的关键补强。Pangram 公布的结果显示,模型在 256×256 分辨率下仍有 96.4% 的准确率,但低于 512 像素的输入会得到置信度较低的提示。
这里需要区分模型能力与产品入口限制。模型可以在 256×256 的评测图片上运行,不代表当前公开网页上传工具一定接受这一尺寸;Pangram 产品页面仍可能要求上传图片至少达到 512×512 像素。对开发者和采购方来说,这意味着不能把基准测试中的最低分辨率直接当成产品规格。
二次编辑仍可能形成持续的攻防。检测模型可以在训练中加入 JPEG 压缩、裁剪和噪声,但攻击者也能使用截图重拍、局部重绘、多轮生成、风格迁移或神经网络去噪来改变特征。生成模型升级后,检测器还需要持续增加新样本,否则很容易在分布变化中失效。
覆盖 GPT Image、Nano Banana 和 Midjourney 等生成器
**跨生成器检测是指同一检测模型能够识别多个不同图像或视频生成系统的输出。**Pangram 此前披露的覆盖范围包括 OpenAI GPT Image、Google Gemini 的 Nano Banana、Midjourney、FLUX 和 Grok Imagine,也包括 Kling、Seedance、Veo 与 Wan 等视频生成器产生的画面。
跨生成器能力决定了产品能否真正用于内容审核。只针对单一模型训练的检测器,很容易把特定编码器、上采样器或水印机制当作捷径;一旦图片来自未见过的新模型,准确率就可能快速下滑。
Pangram 强调其模型不依赖 AI 水印或元数据,而是进行像素级分析。这个路线的优点是图片即使丢失原始文件信息仍可检测,缺点则是像素统计特征可能随模型架构、后处理方式和平台压缩而变化。
水印、内容凭证与像素检测并不是替代关系。C2PA 内容凭证可以记录创作工具和编辑链路,但凭证可能缺失;EXIF 可以提供设备和时间信息,但也容易在平台转码时被删除;像素检测能补上缺失信息,却只能输出概率性判断。
Pangram 目前也会在判定结果之外读取并展示 C2PA 清单和 EXIF 信息。更可靠的产品方案应当是三者结合:优先检查可信内容凭证,再核对元数据与传播链路,最后用视觉模型寻找异常,而不是让一个分类分数决定图片真假。
Flash 1.0 把检测扩展到视频逐帧分析
**Pangram Image Flash 1.0 是面向高速图像推理和视频逐帧分析的轻量模型。**它与旗舰版同时发布,目标不是给单张图片提供最细致的局部解释,而是用更低成本扫描视频中的大量帧。
Pangram 表示,Flash 1.0 在 DF26 视频数据集上取得 98.7% 的准确率,比第二名高出 29 个百分点。按这一差值计算,第二名约为 69.7%,但由于官方披露数字可能经过四舍五入,这一结果更适合视为近似差距。
视频测试比静态图像更难控制。Pangram 以 129 段真实社交媒体视频为起点,让 14 款视频生成器依据真实视频首帧和动作描述生成对应片段,最终获得 1,529 段合成视频。这种配对方式主要测试模型能否区分内容相似的真实和生成视频,而不是依赖题材识别。
逐帧分析对 AI 编辑视频尤其有用。视频可能只有少数帧出现换脸、物体替换或生成画面,如果只对整段视频抽取一个总体分数,短暂修改很容易被平均掉;逐帧时间线则能指出可疑片段从哪里开始、在哪里结束。
逐帧扫描也会带来计算成本和结果抖动。一个 30 秒、每秒 30 帧的视频包含 900 帧,如果逐帧完整推理,成本远高于单图检测;而相邻帧分数突然变化,也需要通过时间平滑、镜头切分和关键帧策略减少误报。
浏览器扩展让检测进入信息流,但也更容易被误用
**浏览器端 AI 内容检测是指在用户浏览网页和信息流时直接标记疑似生成图片。**Pangram 已将 Image 1.0 接入 Chrome 扩展,并提供 Firefox 扩展,可用于社交媒体、电商和房屋租赁等网站。
这种产品形态比单独上传文件更接近普通用户的真实需求。用户无需先保存图片再切换网站,浏览商品、房源或新闻时就能触发扫描;Pangram 公开网页工具目前提供每天最多 3 次免费检测,企业级批量使用则需要单独接入。
浏览器标签不能被当成事实核查结论。扩展程序拿到的往往是网页压缩后的缩略图,缺少原始分辨率、元数据和发布上下文,检测条件通常比上传原文件更差。如果产品只展示醒目的“AI”标签,却不展示置信度、热力图和限制说明,用户很容易把概率判断误解为确凿证据。
对内容平台而言,Pangram 更适合作为审核队列的排序器。模型可以把高风险图片送入人工复核,把热力图作为调查线索,并根据业务风险设置不同阈值;它不适合在没有人工介入和申诉机制的情况下直接执行封号、下架或新闻定性。
这是一款更可用的检测器,不是“AI 测谎仪”
Pangram Image 1.0 的进步在于把 AI 图像检测从单一分数推进到局部定位,并补齐压缩、低分辨率、视频和浏览器场景。相比只能回答“像不像 AI”的传统检测器,热力图至少告诉用户模型为什么产生怀疑,以及下一步应该检查哪里。
Pangram 最大的短板仍是关键结果主要来自官方自建评测。99.96% 的准确率足以证明模型在既定测试集上表现强劲,但在面对未知生成器、真实社交网络压缩链路、恶意规避和极低基准率场景时,效果仍需要第三方长期验证。
AI 图像检测的正确定位不是“真假裁判”,而是数字取证工具箱中的一个组件。未来更可信的鉴定流程会同时使用 C2PA、来源追踪、文件元数据、像素检测、反向搜索和人工调查,任何单一检测器都很难独立承担最终裁决。
对开发者和深度用户来说,Pangram Image 1.0 已经展示出一个更合理的产品方向:少强调一个看似绝对的概率,多提供可解释区域、原始证据和置信边界。热力图不能消灭误判,但它确实让误判更容易被发现,也让检测结果第一次更接近可复核的证据。
参考来源
- IT之家:Pangram 正式发布其 AI 图像检测模型,准确率达 99.96%——整理了 Pangram Image 1.0、低分辨率测试和 Flash 1.0 视频基准的核心数据。