Muir:25MB跑千万Token
Google Research 提出线性注意力架构 Muir,用固定 25MB 状态处理千万级 Token,在降低长上下文内存成本的同时改善召回、训练速度与模型困惑度。
Google Research 提出 Muir:25MB 固定状态跑完千万 Token
Google Research 在 11 月 5 日公开了新的线性注意力架构 Muir,试图用固定约 25MB 的循环状态,替代随上下文长度不断膨胀的 Transformer KV Cache。论文最激进的结果是:一个 13.4 亿参数的 Muir 模型只在 4K 长度上完成预训练,却能连续处理 1000 万 Token,外推长度达到训练窗口的 2560 倍,同时没有出现明显的困惑度漂移。(arxiv.org)
**Muir 是一种基于门控 Delta Rule 的线性注意力架构。**它不保存每一个历史 Token 的 Key 和 Value,而是把历史信息持续压缩进一个固定大小的二维状态矩阵,因此推理内存不会随着输入长度线性增长。
这不是又一次把上下文窗口数字从 100 万改成 1000 万的营销升级。Muir 真正想解决的是:当上下文达到千万级 Token 时,模型到底该如何保存历史,而不是单纯证明模型能够接收一个很长的输入张量。
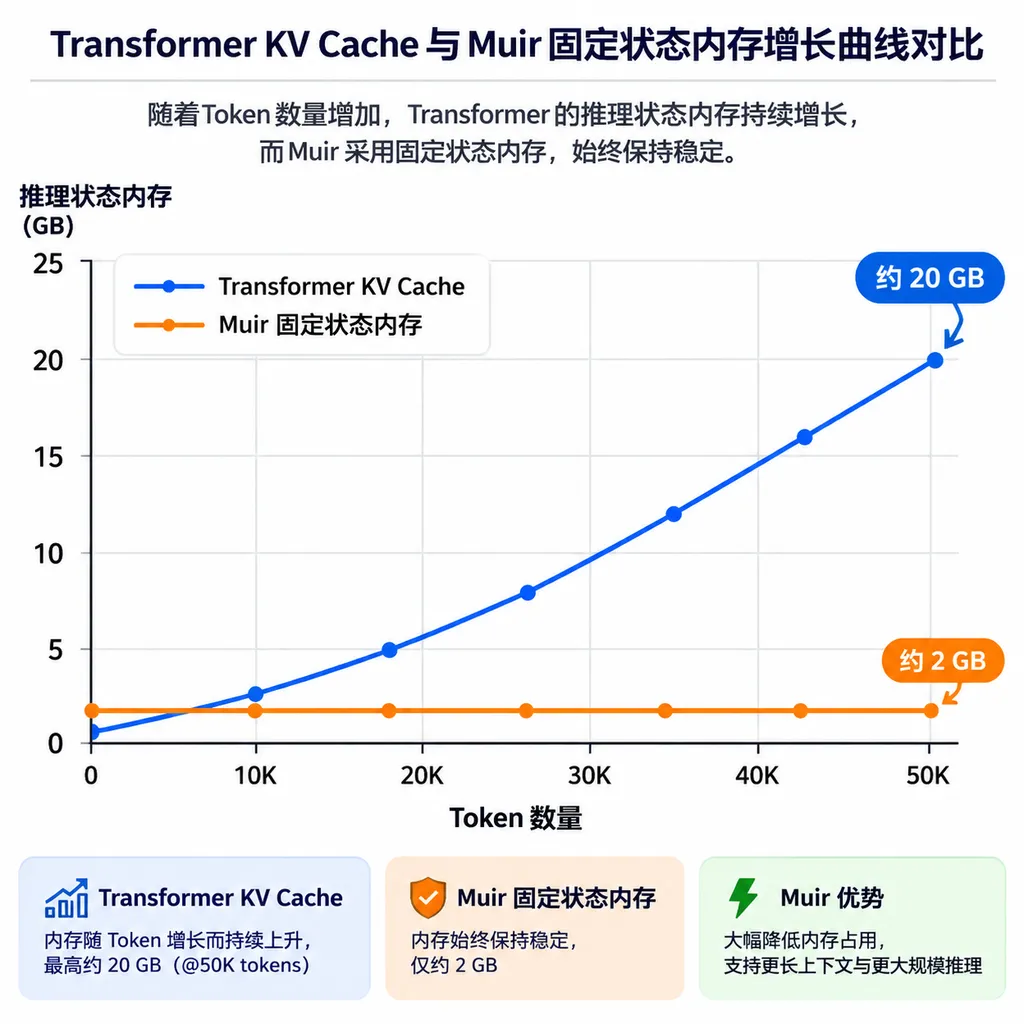
1000 万 Token,KV Cache 已经装不下了
**标准 Transformer 的长上下文瓶颈首先是内存,而不只是注意力计算量。**自回归生成时,模型通常需要保存此前所有 Token 的 Key 和 Value;上下文越长,KV Cache 就越大,即使使用 FlashAttention,也无法消除这部分持久化状态。
论文以 13.4 亿参数模型为例进行了估算:处理 1000 万 Token 时,Transformer 的 KV Cache 在 bfloat16 精度下需要约 2.1TB 内存;即使压缩到 2.5-bit,仍然需要约 0.32TB,也就是 320GB。相比之下,Muir 在全部 24 层中使用的 float32 循环状态总共约为 25MB。(arxiv.org)
换算下来,Muir 的状态内存比 bfloat16 KV Cache 小约 8.4 万倍,比 2.5-bit KV Cache 也小约 1.28 万倍。当然,这个数字并不意味着 Muir 的完整推理显存只有 25MB——模型权重、激活值和运行时缓冲区仍然需要内存——但它确实切断了推理状态与上下文长度之间的线性关系。
| 架构方案 | 1000万 Token 历史状态 | 是否随上下文增长 | 主要问题 | |---|---:|---|---| | Transformer,bfloat16 KV Cache | 约 2.1TB | 是,线性增长 | 长上下文推理内存不可承受 | | Transformer,2.5-bit KV Cache | 约 320GB | 是,线性增长 | 量化后依然庞大,且可能损失精度 | | Muir,float32 循环状态 | 约 25MB | 否,固定大小 | 历史信息会被压缩,存在记忆干扰 |
**固定状态并不是免费获得的无限记忆。**KV Cache 更像保存完整会议录音,需要时可以回到某一句;线性注意力则更像一边开会一边更新白板,白板大小不变,新信息会与旧信息叠加,模型必须决定什么应该保留、什么应该覆盖。
因此,Muir 的核心工作不是把状态矩阵做得更小,而是让这个只有 25MB 的白板更会记东西。
Muir 先解决了状态里的“强光干扰”
**Muir 的第一个关键改进是 matched-filter readout,即匹配滤波式读取。**在带有多时间尺度衰减的线性注意力中,一部分状态通道衰减得很快,主要保存最近内容;另一部分通道衰减得很慢,负责保存更早的信息。
问题在于,慢衰减通道会连续积累大量写入,其能量可能比快衰减通道高出 100 倍以上。模型读取状态时,如果直接用 Query 与所有状态行相乘,这些高能量的慢通道就像夜间迎面而来的远光灯,会压过其他通道中的有效信息。(arxiv.org)
此前的 Gated DeltaNet-2,简称 GDN-2,主要在写入阶段解决干扰:写入新信息前,先擦除状态中与当前 Key 对应的旧预测。然而,当慢通道过强时,模型只能增加擦除力度,结果是干扰虽然下降了,早期写入的事实也更容易被提前覆盖。
Muir 把一部分去噪工作从写入阶段移到了读取阶段。它先根据每一行状态的预期能量构造静态缩放,再根据当前 Token 动态调节 Query,让不同时间尺度的状态在读取时更加均衡。
**匹配滤波读取的价值是让模型少擦一点、读准一点。**论文报告,Muir 相比 GDN-2 将写入时的擦除强度降低了 17%,中位读取能量差距缩小了 35%;在五跳变量追踪任务中,最早一跳信息的保留率从 37% 提升到 45%,平均五跳保留率从 46% 提升到 52%。(arxiv.org)
这项设计也揭示了一个容易被忽视的事实:长上下文能力不只是能否保存信息,还取决于查询发生时,模型能否从不同时间尺度的混合状态中把正确信息读出来。
五套门控被压进一个低秩投影
**Muir 的第二个关键改进是 sensitivity-allocated gating,即按敏感度分配门控容量。**GDN-2 为衰减、擦除、写入和输出等操作设置了多个门,其中擦除门与写入门都使用较大的全秩投影,参数开销很高。
Google Research 的分析发现,这些门并不值得获得相同的参数预算。归一化后的 Key 能量集中在每个注意力头约 5%的通道中,而 Value 写入会影响几乎全部通道,因此状态对写入门变化的敏感度,大约是对擦除门变化的 13 倍。(arxiv.org)
换句话说,写入门需要精细控制,擦除门却不需要同样宽的投影。Muir 因此把衰减门、擦除门、输出门、写入门和 Query 读取门共五套门控,合并进一个总秩为 512 的低秩投影,再为不同门分配不同的秩。(arxiv.org)
| 门控组件 | Muir 投影秩 | 作用 | |---|---:|---| | 衰减门 | 64 | 决定不同状态通道遗忘速度 | | 擦除门 | 64 | 写入前清除冲突预测 | | 输出门 | 128 | 控制状态输出到网络的比例 | | 写入门 | 128 | 控制新 Value 写入强度 | | 动态读取门 | 128 | 根据当前查询调整状态行权重 | | 总秩 | 512 | 共享一次下投影,分别上投影 |
**低秩门控省下的参数没有被删除,而是重新投进了 FFN。**在 13.4 亿参数配置中,Muir 将每层门控相关参数从约 5033 万降至约 4299 万,随后把 FFN 中间维度从 5888 扩大到 7680,宽度增加 30.4%,同时维持接近相同的总参数量和计算预算。(arxiv.org)
这一步很务实。循环状态负责保存上下文,但语言知识、事实映射和 Token 级表征仍然大量依赖 FFN;如果为了增加更多门控而持续压缩 FFN,模型可能获得更复杂的记忆控制,却损失基础语言建模能力。
质量提升不只出现在超长上下文
**Muir 在普通语言建模上的提升,说明它并非只针对极端长度优化。**研究团队训练了 1.66 亿、4.06 亿、8.34 亿和 13.4 亿参数四档模型,每个模型均训练 1000 亿 Token,并与参数规模相近的 Transformer 和 GDN-2 比较。
在四个规模上,Muir 的困惑度相比 GDN-2 降低 1.8%至 2.0%,相比 Transformer 降低 2.5%至 3.6%;零样本常识推理准确率最高提升 1.9 个百分点。Muir 还只需要约 850 亿训练 Token,就能达到 GDN-2 训练 1000 亿 Token 后的验证损失,相当于 Token 效率提高约 1.2 倍。(huggingface.co)
| 指标 | Transformer | GDN-2 | Muir | Muir 的优势 | |---|---:|---:|---:|---| | 13.4亿参数验证 NLL | 2.0335 | 2.0177 | 1.9973 | 低于两类基线 | | WikiText 困惑度 | 17.17 | 16.80 | 16.41 | 优于 Transformer 与 GDN-2 | | LAMBADA 困惑度 | 10.30 | 10.38 | 10.00 | 三者最低 | | 8项常识任务平均准确率 | 52.05 | 52.46 | 53.84 | 比 GDN-2 高 1.38 点 | | Based 抽取式召回 | 45.92 | 32.08 | 34.60 | 高于 GDN-2,仍低于 Transformer | | 5-shot TriviaQA | 14.56 | 16.48 | 19.32 | 三者最高 |
表格里也能看到 Muir 的边界:它在 Based 抽取式召回上虽然超过 GDN-2,却仍未全面超过 Transformer。固定状态模型会把历史压缩到有限维度,同一个状态行中可能叠加多个相似 Key;当任务要求精准复制原文片段时,保留全部 KV 的 Transformer 仍然具有结构性优势。
千万 Token 稳定,不等于千万 Token 都能精确检索
**Muir 的 1000 万 Token 实验测量的是连续语言建模稳定性,而不是在 1000 万 Token 中任意定位一条事实。**论文将三个连续的 FineWeb-Edu 文本流扩展到 1000 万 Token,主要观察模型困惑度是否随着状态持续累积而恶化。
动态 matched-filter readout 在这一实验中保持了相对稳定的困惑度,避免了静态读取权重在 32K 之后逐渐漂移。这证明 Muir 的循环状态不会因为长时间运行而快速数值崩溃,也说明动态读取能适应查询与目标信息之间不断变化的距离。(arxiv.org)
**精确检索的最好结果目前停留在 100 万 Token。**在单一 Passkey 检索任务中,使用静态读取门的 Muir 在经过 64K 长上下文冷却训练后,100 万 Token 准确率达到 99.4%;零样本状态下则为 90.0%。(reddit.com)
这里出现了一个有意思的取舍。静态读取门更适合只有一个目标、一个查询距离的 Passkey 任务,因为它可以把更多秩留给写入门;动态读取门会牺牲一部分写入容量,但在多跳推理、多个目标和真实文档抽取中更擅长根据查询切换时间尺度。
因此,把 Muir 简化为“25MB 精确记住 1000 万 Token”并不准确。更严谨的说法是:Muir 能以 25MB 固定状态稳定处理 1000 万 Token 连续文本,并在特定配置下实现接近满分的 100 万 Token 单目标检索。
为 TPU 重写长序列并行算法
**Muir 的第三个改进是面向宽矩阵计算单元设计新的分块并行算法。**循环模型天然适合逐 Token 更新,但逐 Token 训练会失去现代加速器最擅长的大矩阵乘法吞吐,因此通常需要把序列切成 Chunk 并行处理。
传统 Gated Delta 类算法需要对累积衰减因子进行除法,并求解下三角系统。当 Chunk 扩大到适合 TPU 宽矩阵单元的尺寸时,快速衰减通道的累积值可能在 float32 中下溢,随后除法产生溢出或 NaN。
Muir 使用 boundary-pivoted chunkwise kernel,将跨边界衰减拆成始终位于 0 到 1 之间的乘法项,避免直接除以极小的累积衰减值;随后通过分块 Neumann 形式和递归矩阵乘法求解三角系统,把绝大部分计算交给矩阵单元。
**硬件适配让 Muir 在超长训练长度上获得了现实速度优势。**在 8 张 TPU7x、每步约 52.4 万 Token 的实验中,Muir 在 4K 长度下与 GDN-2 吞吐基本相当;相比 Transformer,在 16K 和 32K 长度下分别快 1.64 倍和 2.74 倍。(arxiv.org)
不过,Muir 并非所有长度都更快。论文明确指出,在约 11K 以下的短上下文中,经过高度融合优化的 Splash Attention 仍然更快,因为当前 Muir 采用纯 JAX 与 XLA 实现,部分临时结果需要写入 HBM。(arxiv.org)
Muir 不会直接淘汰 Transformer 和 RAG
**Muir 更可能成为混合架构组件,而不是立刻替代 Softmax Attention。**Transformer 的优势是信息保真度高,每个历史 Token 都保留独立 KV;Muir 的优势是状态成本固定,可以持续处理超长文本流,但必须接受有限状态中的信息碰撞。
实际产品最可能采用分层组合:局部窗口使用 Softmax Attention,保证最近内容与精确复制能力;长期历史进入 Muir 一类循环状态;更大范围的企业知识仍然通过 RAG 或数据库检索筛选。
| 技术 | 解决的问题 | 优势 | 不擅长的部分 | |---|---|---|---| | Softmax Attention | 精确建模 Token 间关系 | 召回和复制能力强 | KV Cache 随长度增长 | | Muir 固定状态 | 持续压缩超长历史 | 常量状态内存、线性训练 | 历史信息可能互相干扰 | | RAG | 从外部知识库筛选信息 | 可更新、可追踪、可控制来源 | 检索错误会导致遗漏 | | 混合架构 | 分层管理短期与长期信息 | 平衡精度、成本和长度 | 系统设计与训练更复杂 |
长上下文也不等于可以把所有数据无差别塞进模型。无关文档、冲突版本和低质量日志仍然会增加推理噪声;固定状态尤其需要谨慎,因为无关信息不只是占用窗口,还可能真实地改写有限状态。
真正重要的是“每个 Token 的记忆成本”
**Muir 把长上下文竞争从窗口长度,推进到了记忆效率。**过去厂商强调的是支持 128K、1M 还是 2M Token,接下来更重要的问题会是:每增加 100 万 Token,需要多少显存、多少计算、多少延迟,以及模型还能保留多少早期事实。
从这个角度看,Muir 是一项值得重视的研究。它没有依赖更激进的 KV Cache 量化,也没有通过缩小局部窗口回避问题,而是重新分析门控循环状态内部的信息写入、擦除和读取机制,并把算法设计延伸到 TPU 的矩阵单元利用率。
**Muir 目前仍是一种研究架构,而不是可直接替换 Gemini 或其他大模型的成品。**截至 2026 年 11 月 6 日,Hugging Face 论文页尚未关联可下载模型权重或数据集;实验最大规模为 13.4 亿参数,与今天的前沿商业模型仍有数量级差距。(huggingface.co)
更大的问题是,固定状态架构能否在百亿、千亿参数规模下继续保持训练稳定,并在代码生成、Agent 长期记忆和多模态视频理解中维持精确召回。Muir 已经证明 25MB 状态可以稳定跑过 1000 万 Token,但它还没有证明这 25MB 能像数 TB 的 KV Cache 一样,保留其中每一个细节。
这也是 Muir 最有价值的地方:它不是宣布长上下文问题已经解决,而是给出了一个更可能被工程系统采用的方向——不再无限保存历史,而是学习如何更有效地遗忘、写入和读取。
参考来源
- Hugging Face Papers:Muir 论文页面——包含论文摘要、作者信息、核心实验数据及 Hugging Face 社区讨论。
- Reddit r/MachineLearning:Muir 技术讨论——汇总 25MB 状态、千万 Token 外推、门控敏感度和长上下文召回结果。