Claude开始在空闲时“做梦”
Anthropic 将智能体记忆拆成四层,并用“做梦”机制在会话间整理日志、修正错误和构建知识库。实验显示,真正有效的记忆不是存得更多,而是留下经过验证、未来还能复用的规则。
Claude开始在空闲时“做梦”
Anthropic 在 11 月 6 日发布研究文章《The components of agent memory》,系统拆解了 Claude 智能体如何跨会话保存经验、判断信息价值、修正错误,并把零散记录整理成可复用的知识结构。研究最值得关注的部分不是“Claude 有记忆了”,而是 Anthropic 开始把智能体记忆从一个存储功能,改造成一套持续运行的知识维护系统。
这套机制被 Anthropic 称为 dreaming,也就是“做梦”。它不是让模型生成梦境,也不是在后台继续训练模型,而是让智能体利用两次交互之间的空闲计算,重新阅读会话日志、检查记忆笔记、合并重复信息、纠正错误结论,并更新 Wiki 等知识表征。
换句话说,Claude 在工作时负责经历事情,在空闲时负责理解自己经历过什么。
记忆不是聊天记录,而是对未来的预测
智能体记忆是模型从历史任务和用户交互中获得、能够跨会话保留,并在未来任务中重新读取的经验性知识。
这个定义排除了三种经常被混为一谈的能力:模型训练带来的权重变化、单次上下文窗口内的临时学习,以及为了节省上下文而生成的历史摘要。Agent 记忆的关键不在于“模型以前见过这些文字”,而在于它能否把一次任务中验证过的经验带到下一次任务。
Anthropic 给出了一个很有用的判断:写下一条记忆,本质上是在预测未来还会需要它。
例如,Agent 记录“某个数据库字段必须先按月份过滤,再计算去重用户数”,意味着它判断未来可能再次遇到同类查询,而且直接复用这条规则,比重新试错更划算。相反,记录“当前页面右上角显示 37 条结果”,通常没有长期价值,因为页面状态随时可能变化,下次也可以重新读取。
这正是当前不少 Agent 记忆系统的问题。很多实现把“存得下来”当成“记得住”,最后得到的不是长期记忆,而是一个不断膨胀、混有错误信息的日志垃圾场。
Anthropic把记忆拆成四层
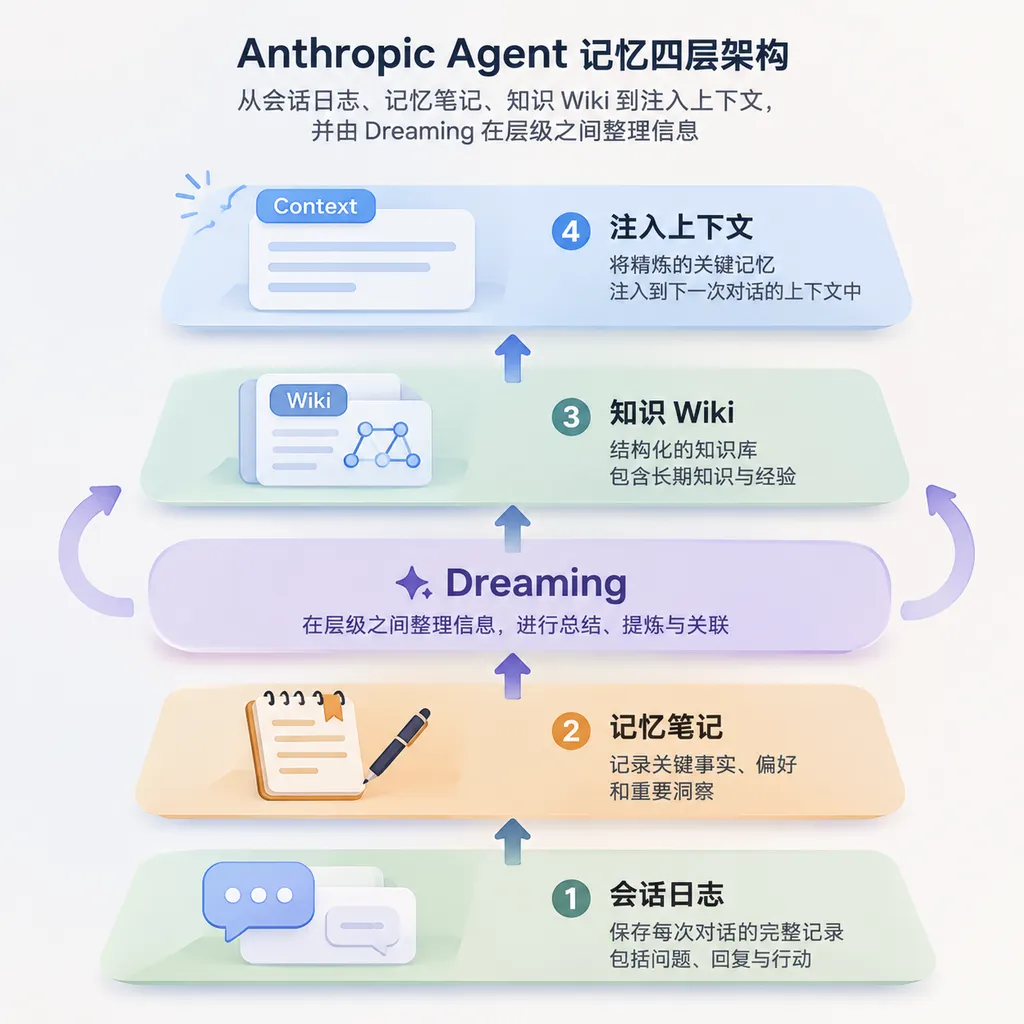
Anthropic 的记忆架构是一套从原始记录到主动加载知识的四层结构。
| 记忆层级 | 保存内容 | 主要作用 | 典型风险 | |---|---|---|---| | 会话日志(Transcripts) | 完整交互、工具调用和任务过程 | 提供可追溯的原始事实 | 数据量大,直接检索成本高 | | 记忆笔记(Memory Notes) | Agent 主动写下的规则、计划和经验 | 跨会话快速复用经验 | 可能写错,也可能随环境变化而过期 | | 知识表征(Representations) | Wiki、索引、主题页和关联网络 | 把零散记忆组织成结构化知识 | 维护成本高,可能比原始资料还臃肿 | | 注入上下文(Injected Context) | 每次会话启动时预先加载的核心信息 | 不经搜索即可影响模型行为 | 占用上下文,错误会被反复放大 |
会话日志相当于监控录像,内容最完整,但每次都从头回看并不现实。记忆笔记更像员工手册中的个人备注,能够快速调用,但可能包含误判。Wiki 则像团队知识库,负责把多个任务中的知识串联起来。最上层的注入上下文类似每天开工前必须阅读的值班提示,信息最少,却对行为影响最大。
Dreaming 的作用就是在这四层之间搬运、压缩和校验信息。
它可以从日志里提取新的记忆笔记,也可以拿日志去核对已有笔记;它可以把多份笔记合并成 Wiki 页面,也可以把最重要的结论提升到下一次会话自动加载的上下文中。与普通 RAG 在提问时临时搜索不同,Dreaming 会提前维护一份不断演化的知识结构。
有记忆后,Claude的数据库任务得分提高近三成
CL-Bench 实验表明,记忆对长周期任务的帮助可以被明确量化。
CL-Bench 是一个持续学习基准,其中一项任务要求 Agent 连续回答数据库问题。每道题都在新会话中开始,模型会在回答后获得正确结果,但只有具备记忆目录的 Agent 能把上一次的经验带到下一次。
| 模型 | 无记忆得分 | 使用记忆得分 | 相对提升 | |---|---:|---:|---:| | Claude Opus 5.5 | 0.655 | 0.838 | 27.9% | | Claude Sonnet 5.5 | 0.644 | 0.833 | 29.3% | | Claude Opus 5 | 0.564 | 0.828 | 46.8% | | Claude Opus 4.7 | 0.383 | 0.700 | 82.8% | | Claude Sonnet 5 | 0.306 | 0.610 | 99.3% | | Claude Sonnet 4.6 | 0.330 | 0.364 | 10.3% |
更强的模型并不只是多写几条笔记,而是能够形成“失败—提出假设—验证假设—总结规则”的闭环。Opus 5、Opus 5.5 和 Sonnet 5.5 会记录一条规则为什么成立、它经过了什么验证,以及未来应该避开什么陷阱。
较弱模型的问题则很典型。Sonnet 4.6 会写下多种未经验证的猜测,却不一定在下一轮读取这些文件,也没有主动测试猜测是否正确。当研究人员明确提醒它先阅读记忆、再验证理论后,其得分从 0.364 提升至 0.641,增幅达到 76.1%。
这说明记忆系统的上限不只取决于数据库、向量检索或文件格式,也取决于模型有没有能力管理自己的认识过程。存储层可以给 Agent 一本笔记本,但不能保证它会翻笔记,更不能保证它知道哪一页写错了。
记得少的Claude,反而多拿了三枚徽章
《宝可梦红》实验给出的结论很反直觉:高质量记忆的核心指标不是容量,而是信息密度。
在大约进行到 1 万个操作步骤时,Claude Sonnet 3.7 已经创建了 413 个记忆文件,分布在 225 个文件夹中,总计接近 98 万个字符。它详细记录每场战斗、遇到的角色、获得的物品和当前位置,最终只拿到 1 枚徽章。
Claude Fable 5 只维护了 10 个文件,总计约 4.3 万个字符,却拿到了 4 枚徽章。它的记忆规模只有 Sonnet 3.7 的约 4.4%,游戏进度却明显领先。
差距来自两种完全不同的记忆策略。
Sonnet 3.7 把屏幕上能够随时重新读取的状态也写进长期记忆,例如当前位置、金钱数量和单次战斗过程。这些信息变化很快,保存后很快过期。到后期,模型需要花费越来越多的时间阅读、整理和重写记忆,甚至连续创建和删除文件,却没有执行任何游戏操作。
Fable 5 主要保存三类信息:当前目标、下一步计划和经过测试的游戏规则。它使用一个 global.md 文件充当任务仪表盘,用位置目录保存路线策略,用玩法目录保存只有通过试错才能获得的经验。
这组实验揭示了 Agent 记忆最重要的工程原则:能从环境重新读取的信息,不要长期保存;需要推理和验证才能得到的信息,才值得沉淀。
对于编程 Agent 来说,当前终端输出、文件列表和即时错误日志属于可重新读取状态;仓库构建约束、用户明确偏好、经过验证的修复路径和容易踩坑的接口行为,才更接近长期记忆。
“做梦”真正有价值的地方,是能推翻旧记忆
Dreaming 不只是生成摘要,它必须具备纠错能力,否则记忆越强,错误传播得越远。
在《宝可梦红》的一次运行中,Claude 错误记录了宝可梦中心位于月见山东侧,并据此判断自己已经穿过洞穴。这个错误笔记在后续会话中被当成事实,导致 Claude 反复从单向台阶跌回旧路线。
没有经过整理的 Claude 连续三次走错,最后一路退回更早的城市,直到任务结束也没能抵达华蓝市。启动 Dreaming 后,系统重新读取原始会话日志,将错误位置与真实行动轨迹进行比对,发现笔记与记录冲突并重写了记忆。修正后的 Claude 重新进入洞穴,并在第 1935 个操作时抵达下一座城市。
这个案例比跑分更能说明问题。传统 RAG 通常默认知识库里的内容可信,检索系统只负责找出最相关的片段;Dreaming 则把知识库视为一份需要持续审计的工作副本,原始日志才是可以回溯的证据。
如果没有证据链,Agent 的长期记忆会形成一种危险的错误复利。一次不准确的推断被写入笔记,下一次任务又以它为前提产生新结论,几轮之后,系统可能已经无法区分事实、推断和基于错误推断生成的规则。
35万份文档里,Wiki与搜索不是二选一
企业知识任务的实验说明,结构化记忆与实时搜索的组合效果最好。
Anthropic 使用约 35 万份、合计约 4.2 亿 Token 的企业文档进行测试,并让 Opus 5 通过多轮 Dreaming 构建内部 Wiki。Agent 会持续创建页面、修正表述、合并重复内容、补充链接,并回到原始文件核对结论。
当 Dreaming 从 2 次会话扩展到 128 次会话后,仅依靠 Wiki 回答 25 个问题的达标率从 13%提升至48%,增加了35个百分点。将 Wiki 与搜索工具结合后,综合得分从54%提升至61%;只使用搜索工具的得分约为53%。
| 知识访问方式 | 结果 | 更适合的任务 | |---|---:|---| | 仅搜索原始文档 | 约53% | 单一事实、关键词明确的问题 | | 仅使用早期 Wiki | 13% | 知识结构尚未成熟时效果有限 | | 仅使用成熟 Wiki | 48% | 需要复用已有主题总结的问题 | | 搜索加持续维护的 Wiki | 61% | 跨文档推理、关系梳理和复杂问答 |
Wiki 的优势不是替代搜索,而是提前完成一部分跨文档整合。搜索负责找证据,Wiki 负责保留关系、结论和历史分析,两者组合类似“资料室加一位长期负责该项目的员工”。
不过,Wiki 并非越大越好。Anthropic 在另一项测试中得到了一份203 KB的Wiki,而原始文档只有115 KB,知识地图膨胀到原始资料的1.77倍。这种系统看似整理得很细,实际上没有完成抽象,只是换了一种格式复制资料。
如果一份 Agent Wiki 比源文件更难读、更难验证,它就不是知识表征,而是新的技术债。
这不是模型偷偷训练自己
Dreaming 是上下文工程和后台计算机制,不是模型权重层面的持续学习。
Claude 在“做梦”后并没有修改神经网络参数,也不会因为整理了一次项目日志,就把这段经验永久写进基础模型。它改变的是模型下一次能够读取的外部记忆,包括文件、索引、Wiki 和预加载上下文。
这种区别对开发者非常重要。权重更新通常需要训练基础设施、数据治理和安全评估,成本高且难以频繁执行;外部记忆可以按用户、项目或团队隔离,支持删除、回滚、版本控制和人工审计。
它也更像软件工程,而不是神经科学。所谓“睡眠巩固”只是便于理解的类比,实际系统仍然需要明确的数据结构、任务调度、访问权限、来源追踪、冲突处理和评估指标。
开发者真正该抄的,是记忆生命周期
Anthropic 这项研究最有价值的部分不是“Dreaming”这个名字,而是把 Agent 记忆做成了完整生命周期。
一个可用的长期记忆系统至少应该包含以下环节:
- 保留原始证据。 会话日志和工具执行结果需要可追溯,不能只留下模型总结。
- 区分事实与推断。 记忆条目应标记来源、验证状态和最后更新时间。
- 只保存高价值经验。 优先记录用户偏好、稳定规则、失败原因、计划和验证结果。
- 定期合并与删除。 重复、过时和相互矛盾的内容必须被主动处理。
- 按访问频率分层。 高频且关键的信息进入启动上下文,低频细节留在可搜索存储中。
- 允许回滚和人工审查。 Agent 修改共享知识库时,应该留下版本记录和变更原因。
- 单独评估记忆收益。 不只测试回答准确率,还要计算维护记忆消耗的 Token、延迟和存储成本。
这套方法尤其适合长周期编程、企业研究、客户支持、法律文档分析和个人助理场景。这些任务的共同点是:一次会话无法完成全部工作,历史经验确实有复用价值,而且错误记忆可能产生真实损失。
短任务则未必需要复杂的 Dreaming。一次性的格式转换、简单查询或能够直接搜索到答案的问题,构建 Wiki 可能比重新检索更贵。Anthropic 的实验同样表明,当答案集中在单一文档中时,Wiki 相比直接搜索未必有明显收益。
“会记住”正在成为Agent的新分水岭
未来 Agent 的差距不会只体现在单次推理能力,还会体现在它如何管理长期经验。
上下文窗口再长,也不能解决所有记忆问题。把几十万份文件、数百次会话和所有历史状态塞进上下文,既昂贵,也会稀释真正重要的信息。长上下文解决的是“放不放得下”,记忆系统解决的是“什么值得留下、什么时候读取、发现错误后怎么改”。
Anthropic 的实验也说明,模型能力和记忆架构存在乘数关系。较弱模型即使获得持久化目录,也可能不读、不验证或无差别记录;较强模型则能自主建立规则、维护索引并纠正旧结论。模型越擅长判断信息显著性,外部记忆的收益越高。
我的判断是,Dreaming 不会成为一个孤立的 Claude 功能,而会变成 Agent 基础设施中的常见后台任务。未来的智能体系统很可能像数据库一样拥有定期压缩、索引重建、冲突检测和数据清理流程,只不过维护对象从表和索引变成了模型的工作经验。
真正成熟的 Agent 不是永远记得更多,而是知道什么该记、什么该忘,以及什么时候应该承认自己记错了。
参考来源
- IT之家:Anthropic研究称Claude AI智能体可以靠“做梦”变得更聪明 —— 介绍 Anthropic 于2026年11月6日发布的Agent记忆研究及核心实验数据。 (ithome.com)
- Anthropic Claude Quickstarts:Knowledge Wiki —— Anthropic公开的知识Wiki示例项目,可用于理解结构化长期记忆的实现方式。
- Harvey LAB —— Anthropic研究中用于评估法律任务和跨文档知识组织能力的开源Agent基准。 (github.com)