中国模型吃下九成开源账单
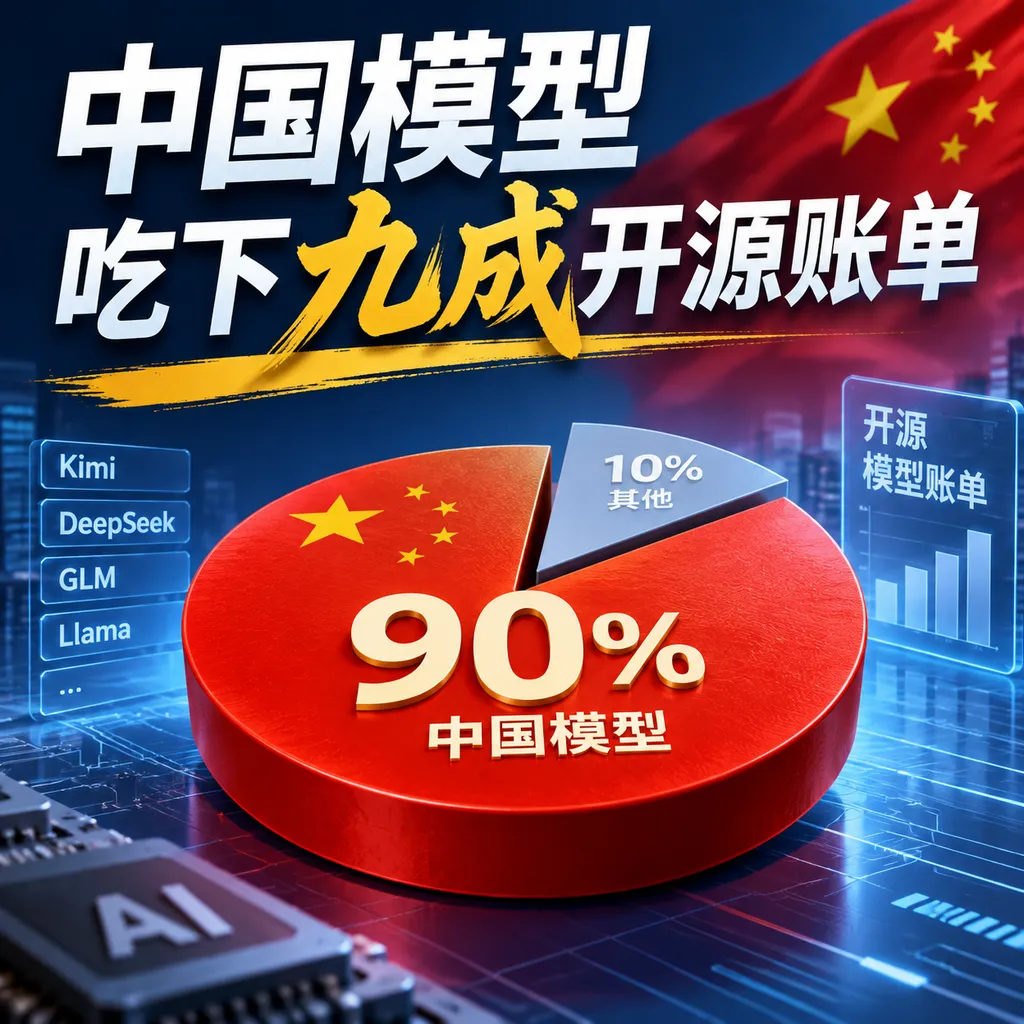
Menlo Ventures 最新调查显示,中国模型占企业开源模型支出89%,Kimi以61%居首。但这只是开源赛道内部的胜利,开源模型仅占企业模型支出4%。
Menlo Ventures 把企业开源模型市场的最新账单摊开了:中国模型拿走了其中 89% 的支出,月之暗面的 Kimi 以 61% 排名第一,DeepSeek 和智谱 GLM 分别占 15% 和 11%,Meta Llama 只剩 7%。
这组数据来自 Menlo Ventures 于 11 月 3 日发布的《2026 年企业 AI 现状报告》。据 IT之家 转引,报告调查了近 400 名美国企业 AI 业务负责人,因此更准确的说法是:中国模型在受访美国企业的开源模型支出中占 89%,而不是对全球所有企业账单进行完整统计后得出的市场份额。
这个口径差异很重要,但不影响核心结论:中国模型已经取得企业开放模型市场的定价权,至少在美国企业开发者愿意真正付费使用的部分,它们不再只是低价替代品,而是默认候选。
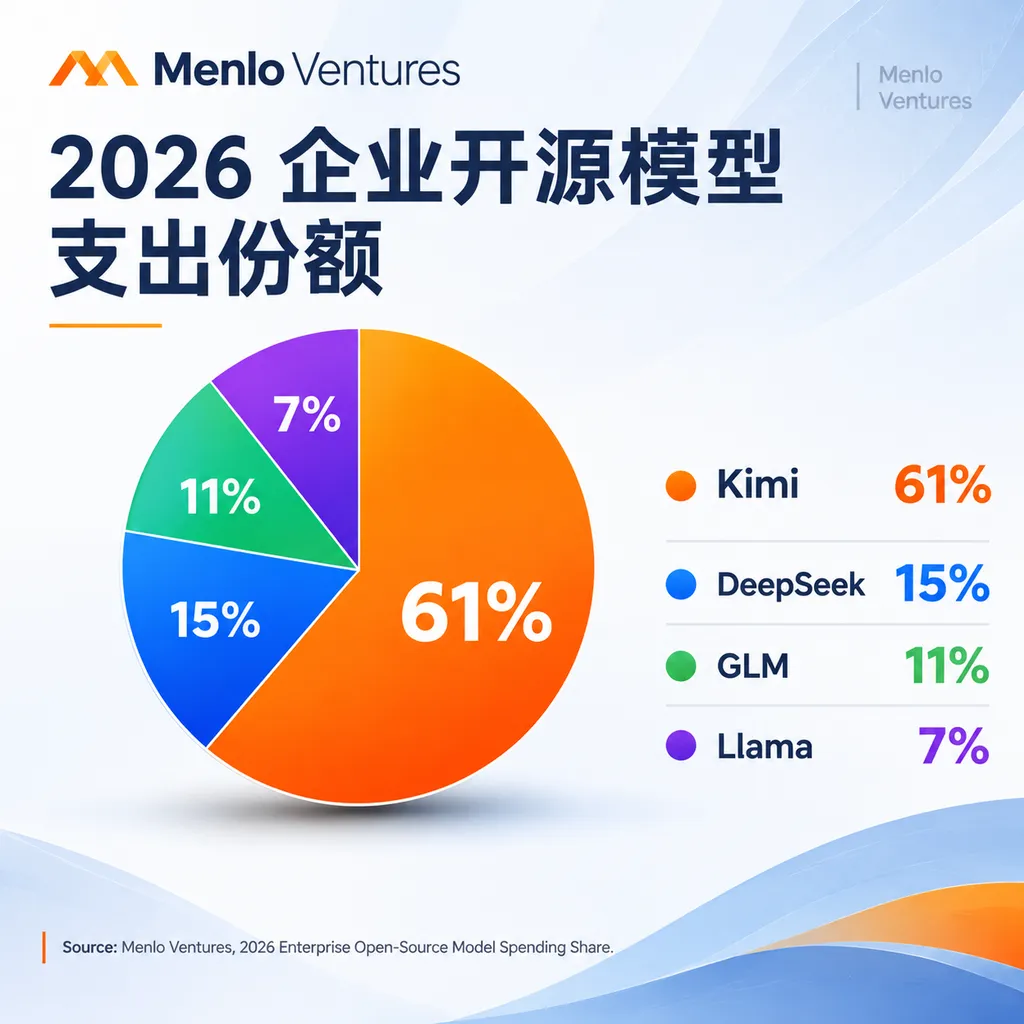
Kimi 一家拿走六成,Llama 退到 7%
企业开源模型支出,是企业为部署、托管和使用开放模型所支付的推理、算力及相关模型服务费用。它衡量的不是模型在社交媒体上的热度,也不是下载次数,而是企业实际把预算投给了谁。
Menlo Ventures 给出的份额如下:
| 模型系列 | 所属公司或组织 | 企业开源模型支出份额 | 排名 | 主要信号 | |---|---|---:|---:|---| | Kimi | 月之暗面 | 61% | 1 | 在企业付费维度形成明显领先 | | DeepSeek | 深度求索 | 15% | 2 | 开发者调用量和成本优势突出 | | GLM | 智谱 | 11% | 3 | 企业部署与智能体场景占据一席之地 | | Qwen | 阿里巴巴 | 3% | 4 | 模型生态广,但报告中的支出份额相对有限 | | Llama | Meta | 7% | 西方模型第 1 | 仍有生态基础,但商业使用份额被中国模型挤压 |
表中中国厂商的单项数据相加为 90%,与报告概括的 89% 存在 1 个百分点差异。这个偏差更可能来自四舍五入、统计分类或调查权重处理,不能据此判断报告自相矛盾,也不应把这些整数份额当成精确到个位数的财务审计结果。
Kimi 的 61% 是这份报告中最值得关注的数字。它意味着在受访企业每花 100 美元使用开放模型时,约有 61 美元对应 Kimi,金额超过 DeepSeek、GLM、Qwen 和 Llama 所列份额之和。
Llama 的 7% 则标志着开放模型竞争逻辑已经变化。Meta 曾凭借较早开放模型权重、完整尺寸梯度和庞大开发者生态,长期充当企业自部署大模型的默认起点;如今,企业采购者开始将注意力转向推理能力、长上下文、代码表现、智能体执行能力和单位 token 成本,而不再只看生态历史。
89%很高,但它不是整个企业AI市场的89%
中国模型拿下的是开源模型支出的 89%,不是企业全部 AI 支出的 89%。Menlo Ventures 预计,2026 年企业 AI 部署支出年化规模将达到 1768 亿美元,其中 AI 应用市场约为 773 亿美元,编程类 AI 应用支出约为 340 亿美元,企业 AI 聊天机器人支出约为 250 亿美元。
开放模型在相关平台上贡献了 19% 的 token 用量,却只占企业模型支出的 4%。换句话说,开放模型已经处理了接近五分之一的推理负载,但每处理一个 token 所创造的收入,仍显著低于闭源模型。
Token 是大模型处理文本、图像和其他输入时使用的基本计量单位。企业模型账单通常与输入 token、输出 token、缓存、推理时长及托管资源有关,因此 token 用量比单纯的用户数更接近真实工作负载,但不能直接等同于营收。
把 89% 直接乘以 4%,再声称中国模型获得企业全部 AI 支出的 3.56%,同样不够严谨。1768 亿美元包括应用、基础设施和模型等不同层级,而 4% 对应的是特定模型支出或平台口径,两者并不一定使用同一个分母。
这组数据真正说明的是,中国厂商已经赢下开放模型这个高调用量、低客单价的市场,但尚未赢下利润最厚的闭源模型和上层企业应用市场。Anthropic、OpenAI 和 Google 仍在企业模型预算中占据更强的商业位置,尤其是高可靠性代理、复杂代码任务、合规交付和完整企业服务协议等场景。
中国模型赢的不是“免费”,而是性能价格比
开放权重模型是允许开发者下载或获得模型参数,并在自有或第三方基础设施上运行的模型。它们经常被统称为开源模型,但开放权重不一定等同于符合 OSI 定义的完整开源软件,因为训练数据、训练代码和复现流程未必全部公开。
企业选择中国开放模型的直接原因,是能力与成本开始同时具备竞争力。过去一年,开放模型的平均价格从每百万 token 0.45 美元降至 0.13 美元,下降约 71.1%;同期使用量增长 22.5 倍,月度处理量达到约 2.9×10^15 token。
价格下降和用量暴增同时出现,说明企业不是只拿开放模型做测试。批量文档抽取、搜索结果重排、代码补全、客服摘要、数据清洗和多智能体后台任务,都需要大量推理调用,而这些任务通常没有必要全部交给最昂贵的前沿闭源模型。
中国模型在这类工作负载中的优势非常现实:如果一个企业每月处理 1000 亿 token,按每百万 token 0.45 美元计算,理论模型费用为 4.5 万美元;按 0.13 美元计算,则约为 1.3 万美元,每月相差 3.2 万美元,降幅同样约为 71%。当调用规模进入万亿 token,采购团队不会忽视这种差距。
低价本身却不足以解释 Kimi 的 61%。纯粹依靠降价通常会带来更高调用量,却未必能获得最高支出份额;Kimi 同时拿到最高付费份额,意味着企业可能在高复杂度推理、长上下文、代码或智能体任务中使用了价格更高、计算量更大的模型版本。
Kimi拿支出,DeepSeek拿流量
企业支出份额和开发者请求份额呈现出明显分化。Menlo Ventures 的调查中,Kimi 以 61% 的支出份额远超 DeepSeek 的 15%;而补充统计显示,在 10 月 26 日至 11 月 1 日的 OpenRouter 文本请求中,DeepSeek 以 29.8% 位居模型开发商第一,OpenAI 为 18.8%,智谱 Z.ai 为 11.9%,Qwen 为 5.6%。
支出排名衡量的是钱流向哪里,请求排名衡量的是调用发生在哪里。两者之间的差异,通常来自模型单价、平均输出长度、推理 token 消耗、免费流量、模型路由策略以及用户结构。
DeepSeek 更像一台被大规模接入生产管线的高吞吐发动机。开发者会把它用于代码生成、后台代理和批处理任务,在较低成本下发起海量请求,因此它更容易在 token 或请求量榜单上占优。
Kimi 更像一项企业愿意为复杂任务支付溢价的计算服务。即使请求次数少于 DeepSeek,只要单次任务更长、推理计算更多、使用的模型档位更高,最终支出仍可能明显领先。
这也解释了为什么不能只看模型排行榜判断商业表现。一个模型可以在评测榜单上领先,却没有稳定企业客户;也可以拥有极高调用量,却因为定价过低而收入有限;真正有价值的指标,是调用量、留存率、单位调用收入和生产环境占比能否同时增长。
Llama的问题不是模型不能用,而是默认地位丢了
Llama 仍是西方开放模型中份额最高的系列,但 7% 已不足以支撑其昔日的主导地位。Meta 的优势依然包括成熟工具链、广泛硬件优化、庞大衍生模型社区和企业熟悉度,但这些优势正在被更快的模型迭代速度抵消。
企业不会因为一套模型来自 Meta 就永久锁定它。模型替换成本正在被统一推理接口、容器化部署、模型路由和评测平台持续压低,开发团队可以先用较小流量做影子测试,再根据准确率、延迟和价格动态切换供应方。
Llama 面临的竞争也不只是参数规模竞争。中国模型正在把重点转向混合专家架构、长上下文、多模态理解、推理效率和智能体执行,这些能力更接近企业实际采购时填写的需求表,而不是单纯追求一个更大的稠密模型。
Meta 仍可能依靠下一代 Llama 扳回份额,但它需要回答一个更直接的问题:当中国模型能力相当、价格更低、更新更快时,企业为什么还要承担迁移回 Llama 的成本?
这是一场开放模型胜利,也是一张利润警告单
中国模型目前最强的市场位置,是高吞吐、成本敏感且允许多模型替换的企业工作负载。这类市场会产生庞大的 token 数量,也能快速建立开发者习惯,但毛利空间往往被持续压缩。
每百万 token 的平均价格从 0.45 美元降至 0.13 美元,意味着模型厂商必须用超过 3.46 倍的调用量,才能在不考虑成本变化的情况下维持相同收入。实际用量增长了 22.5 倍,因此整体市场仍在扩张,但推理基础设施、GPU 折旧、电力和网络成本不会同步归零。
Kimi 的 61% 因而不仅是一份成绩单,也是一项规模化交付测试。月之暗面需要证明这种支出集中可以转化为可持续收入,而不是依靠高计算消耗和激进价格换取短期份额;DeepSeek 和 GLM 则需要把调用量、开发者认知进一步转化为企业合同和稳定预算。
企业采购方获得了更明显的议价权。开放模型能力越接近闭源前沿,企业越有条件采用分层路由:敏感数据使用私有部署,日常批处理使用低成本开放模型,最高难度任务再交给闭源前沿模型。
这种混合架构可能成为 2027 年企业 AI 的主流形态。真正的赢家未必是单一模型,而是能够根据任务难度、延迟、数据边界和预算自动分配请求的平台与团队。
89%的真正含义:开放模型前沿已经向东移动
Menlo Ventures 的结论可以概括为一句话:中国模型正在定义开放模型的能力前沿。89% 不是全球 AI 产业已经重新洗牌的证明,却足以说明美国企业在做技术选型时,已经无法绕开 Kimi、DeepSeek、GLM 和 Qwen。
这场变化比排行榜名次更有意义。排行榜领先可能只持续数周,而企业把模型写进内部工作流、评测体系和成本预算后,迁移成本会逐步增加,模型厂商也就获得了继续销售工具链、托管服务和企业支持的入口。
中国模型下一阶段的挑战不是继续证明自己便宜,而是证明自己可靠。企业客户最终会追问服务可用性、版本稳定性、数据合规、模型可解释性、安全控制、长期支持和跨区域部署,这些能力决定了 89% 的开放模型份额能否进一步转化为整个企业 AI 市场的份额。
Menlo Ventures 的报告因此更像一个拐点,而不是终局:中国模型已经赢得开放模型的使用权和采购席位,但闭源高端市场、企业应用层以及长期利润仍然掌握在另一批公司手中。
参考来源
- IT之家:Menlo Ventures 报告称中国 AI 模型占企业开源模型支出 89%——整理了 Kimi、DeepSeek、GLM 与 Llama 的支出份额,并转述 Menlo Ventures 最新企业 AI 调查结论。