智能体记忆,也该有统一格式了
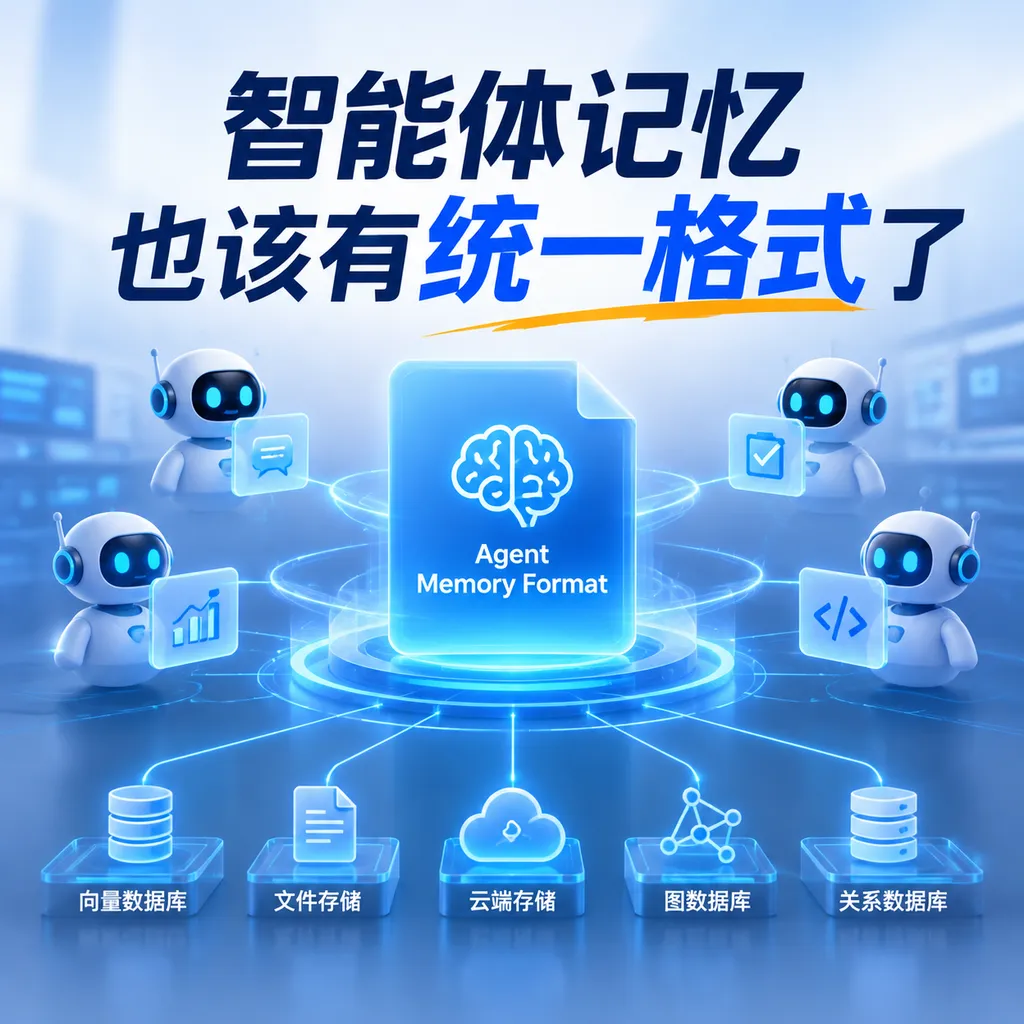
Lorekit 近日提出 Agent Memory Format 设想,希望用类似 OpenTelemetry 的开放标准解决智能体记忆无法迁移、共享和审计的问题。真正需要统一的不是数据库接口,而是记忆的语义、来源与生命周期。
智能体记忆正在重走可观测性的老路
**智能体记忆需要一个类似 OpenTelemetry 的开放标准。**近日,Lorekit 在《Agent memory needs its OpenTelemetry moment》一文中提出 Agent Memory Format 设想:不同智能体框架、模型和存储系统之间,应当使用一套开放、可移植、可审计的记忆格式,而不是继续让每个平台用自己的 JSON、数据库表和提示词模板保存用户状态。
**Agent Memory Format 是一种面向 AI 智能体的开放记忆数据规范。**它要描述的不只是“用户说过什么”,还包括一条记忆属于哪种类型、由谁生成、依据是什么、何时有效、可信度多高、是否可以共享,以及在什么条件下应被更新或删除。
截至 2026 年 11 月 8 日,这仍然是一项行业倡议,而不是已经获得主要厂商共同采纳的正式标准。它没有 OpenTelemetry 那样成熟的规范组织、跨语言 SDK、兼容性测试和供应商生态,也不能被理解成某个新数据库或新的向量检索协议。
但这个问题已经足够现实。
一个用户可能同时使用代码助手、办公智能体、浏览器智能体和个人知识库。代码助手知道项目使用 Rust,办公智能体知道用户每周一要交进度报告,浏览器智能体记得用户不希望打开自动播放的视频。这些信息如今通常被锁在各自产品内部,即使用户主动导出,也往往只得到聊天记录,而不是机器能够继续理解和使用的“记忆”。
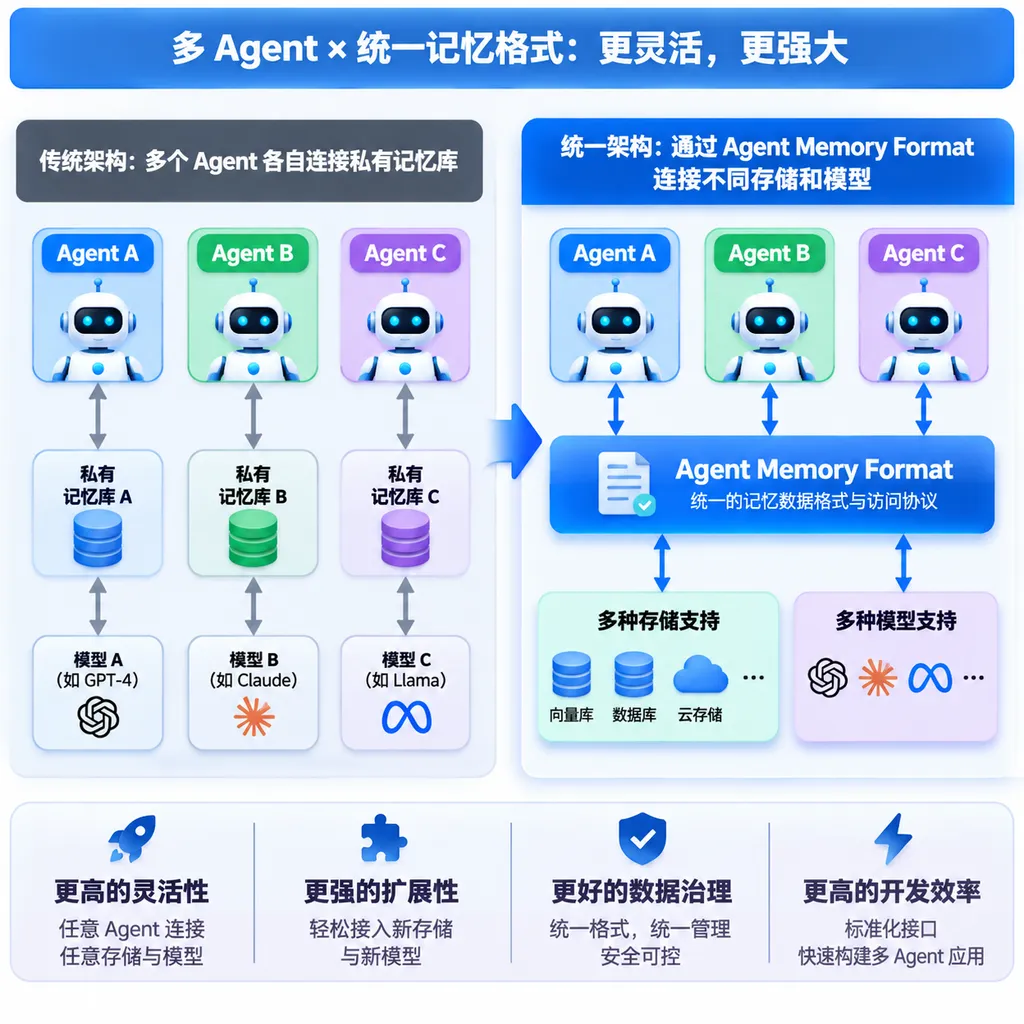
统一格式要解决的不是“怎么存”,而是“存的是什么”
**智能体记忆不是聊天记录、RAG 文档和数据库字段的简单集合。**聊天记录保存原始交互,RAG 从相对稳定的资料库中召回信息,而记忆系统需要对持续变化的用户、任务和环境建立可修改的长期状态。
举个例子,用户对代码助手说:“这个项目以后不要引入 GPL 依赖。”原始消息是一段对话,向量数据库可以把它变成 embedding,但真正可复用的记忆至少还应表达以下内容:
- 记忆主体是某个具体项目,而不是用户的所有项目;
- 记忆类型是约束或偏好,而不是普通事实;
- 约束内容是避免引入 GPL 许可证依赖;
- 信息来源是用户明确指令,而不是模型推断;
- 生效时间从当前版本开始,可能在未来被撤销;
- 冲突时应优先于从历史代码中归纳出的习惯;
- 该记忆可以用于依赖审查,但未必应暴露给其他智能体。
**向量只能回答“什么内容看起来相似”,不能完整回答“这条信息现在是否有效”。**如果系统只保存文本和 embedding,那么“用户喜欢深色模式”和“用户以前喜欢深色模式,但上周改回浅色模式”很可能同时被召回。两条记录在语义上都相关,时间和状态却彼此冲突。
这也是 Agent Memory Format 最值得讨论的地方:它试图把记忆从一段可检索文本,提升为带语义、时间、权限和来源的系统对象。
为什么要类比 OpenTelemetry
**OpenTelemetry 是一套用于生成、传输和描述 traces、metrics、logs 等遥测数据的开放标准与工具体系。**它没有规定企业必须使用哪一家监控平台,而是让应用先用相对统一的方式产生数据,再由不同后端负责存储、查询、告警和可视化。
智能体记忆眼下与早期可观测性市场很相似。每个框架都有自己的对象结构,每个记忆产品都有自己的写入、检索和更新方式,应用一旦深度依赖某套格式,迁移时就要重新编写数据转换、召回策略和提示词拼装逻辑。
OpenTelemetry 的经验说明,开放标准真正有价值的部分并不是“大家都用同一个后端”,而是三层解耦:
- **语义约定统一。**不同系统对字段含义形成最低限度的共识;
- **采集与存储解耦。**应用生成标准数据,后端自行竞争性能和功能;
- **处理链可组合。**数据可以经过过滤、脱敏、采样和路由,再进入目标系统。
**Agent Memory Format 如果成立,也应采用类似的分层思路。**应用和模型产生记忆候选,记忆处理器负责抽取、合并、冲突检测与权限判断,底层再选择关系数据库、向量数据库、图数据库或对象存储。
| 维度 | OpenTelemetry | Agent Memory Format 设想 | |---|---|---| | 标准化对象 | Trace、Span、Metric、Log | 事实、偏好、事件、技能、任务状态等记忆 | | 核心目标 | 遥测数据可跨工具流动 | 记忆可跨 Agent、模型和存储迁移 | | 不负责的部分 | 不规定必须使用哪家监控后端 | 不应规定必须使用哪种数据库或 embedding 模型 | | 关键元数据 | 时间、服务、资源、上下文、属性 | 主体、类型、来源、时间、置信度、权限、生命周期 | | 处理机制 | Collector、Processor、Exporter | 抽取器、合并器、冲突解析器、导入导出器 | | 主要风险 | 字段语义不一致、数据量过大 | 错误记忆传播、隐私泄露、过期信息持续生效 |
类比也不能走得太远。遥测数据主要描述“系统发生了什么”,智能体记忆却会进一步影响“系统接下来做什么”。一条错误日志最多导致误判故障,一条错误记忆可能让 Agent 长期使用错误地址、错误权限或错误业务规则。
一个可用的记忆格式至少要描述七件事
**可移植的记忆对象必须同时具备内容、语义和治理信息。**只统一一个 content 字段没有意义,因为各家系统仍会把真正重要的逻辑藏在元数据、提示词或应用代码里。
一个最低可用的开放格式,至少需要覆盖以下七类信息:
1. 记忆主体
**记忆主体决定一条信息究竟描述谁或什么。**主体可以是用户、团队、代码仓库、任务、设备、组织或某个环境实体,同一句“默认使用 TypeScript”在个人级、团队级和项目级的约束强度完全不同。
2. 记忆类型
**记忆类型决定系统应如何解释和检索信息。**事实记忆描述稳定知识,情景记忆记录具体经历,程序性记忆保存做事方法,偏好记忆表达用户倾向,工作记忆则承载当前任务的短期状态。
AgentGuide 汇总的 Agent Memory 论文与架构也展示了这种差异:现代智能体通常会同时处理上下文、长期外部存储、技能库和反思结果,而不是只有一份聊天历史。
3. 来源与证据
**来源信息决定记忆是否值得相信。**用户明确说出的偏好、工具读取到的系统状态、模型从多轮对话中推断出的结论,可信等级不应相同。
每条记忆最好能够回溯到原始消息、文件、工具结果或任务轨迹。没有 provenance,也就是来源链,一旦模型把“可能”错误压缩成“事实”,后续系统几乎无法定位错误从哪里产生。
4. 时间语义
记忆需要区分记录时间、事件时间和有效时间。“用户在 2025 年住在上海”不能自动推出用户在 2026 年仍住在上海;“下周使用测试环境”也不应永久保存为默认配置。
一个合格格式至少要支持创建时间、更新时间、有效区间、过期时间和最后验证时间。仅有 created_at 不能处理现实世界中的状态变化。
5. 置信度与重要性
**置信度描述系统有多相信一条记忆,重要性描述它在决策中有多大权重。**两者不能混为一谈:模型可以高度确信用户喝过一次拿铁,但这件事对后续任务几乎没有价值;用户明确设置的安全限制出现频率很低,却应拥有最高优先级。
6. 权限与可见范围
**记忆权限决定哪些智能体可以读取、修改和传播数据。**私人日程可以被个人助理使用,但不应自动传给代码助手;公司内部知识可以服务企业 Agent,但不能进入公共训练或跨租户索引。
权限模型还需要覆盖用途限制。允许某个 Agent 读取地址完成配送,不等于允许它据此推断用户的工作地点并生成新的长期记忆。
7. 版本、冲突与删除
**记忆是会变化的状态,而不是只能追加的日志。**开放格式必须表达更新、替代、否定、合并和删除,否则多个 Agent 共享数据之后,只会更快地传播过期信息。
删除尤其不能只删除主记录。原文、摘要、embedding、缓存、知识图谱边和下游副本都可能保留相同信息,标准需要为删除传播和派生关系留下机制。
这项标准最难的不是 Schema,而是语义共识
**设计一份 JSON Schema 很容易,统一“什么值得被记住”非常难。**同一句话可以被一个系统判断为长期偏好,被另一个系统视为当前会话临时要求,也可能被第三个系统因隐私风险而拒绝保存。
记忆写入本身就是模型决策。系统需要判断信息是否稳定、是否重复、是否敏感、是否与已有记录冲突,以及它应该属于用户、任务还是组织。不同模型对这些问题会给出不同答案,即使存储格式完全一致,最终形成的记忆质量也可能相差很大。
记忆读取同样不是普通搜索。成熟系统往往同时考虑新近性、重要性和相关性,并根据当前任务进行重排;有些系统还会把多条情景记忆压缩成更高层的反思结论。统一格式可以让这些策略读取相同数据,却不能保证策略本身一致。
**开放标准应当标准化交换语义,而不是冻结记忆算法。**embedding 模型、召回排序、摘要方法、图谱构建和冲突消解仍应允许各家竞争,否则标准会在快速变化的模型能力面前迅速过时。
Agent Memory Format 也不能等同于 MCP
**MCP 解决的是模型如何发现和调用外部上下文与工具,记忆格式解决的是长期状态如何被描述和迁移。**前者更接近连接协议,后者更接近数据语义规范,两者可以互补,但不能互相替代。
一个 Agent 可以通过工具协议访问某个记忆服务,却仍然只能拿到供应商私有格式;同样,一份符合开放格式的记忆文件,也不代表模型已经拥有查询、授权和更新它的通信机制。
| 技术 | 主要解决的问题 | 是否负责长期记忆语义 | 是否绑定存储 | |---|---|---:|---:| | MCP 类工具协议 | 模型如何连接工具与上下文源 | 否 | 否 | | RAG | 如何从外部资料中召回相关内容 | 通常不负责 | 通常不绑定 | | 向量数据库 | 如何保存和检索向量 | 否 | 是 | | Agent Memory 框架 | 如何抽取、更新和召回记忆 | 部分负责,各自定义 | 视实现而定 | | Agent Memory Format | 如何跨系统描述和交换记忆 | 是 | 不应绑定 |
真正的价值是可迁移、可评测和可审计
**开放记忆格式首先会降低应用对单一框架和供应商的依赖。**开发者更换模型、Agent 编排框架或存储后端时,不必把多年积累的用户状态全部重新抽取一遍,也不必用脆弱的脚本猜测私有字段含义。
**统一格式还会让记忆系统第一次具备可重复评测的基础。**今天比较两个记忆方案时,经常连“写入了什么”都不一致,很难判断差异来自抽取模型、数据结构、检索算法还是提示词。标准数据集如果能够携带来源、时间和变更历史,评测才可能覆盖事实准确率、冲突处理、删除完整性和跨会话召回等指标。
**可审计性可能比迁移能力更重要。**企业需要知道一条影响审批、推荐或自动操作的记忆来自哪里,用户也需要查看“系统记住了什么”、纠正错误并撤销授权。没有统一对象模型,这些能力只能由每个产品重复开发,而且往往只做到聊天记录导出。
OpenTelemetry 社区已经注意到 Agent 的非确定性使遥测数据不仅用于排障,还会进入评估和优化闭环。记忆标准与可观测性标准最终可能交叉:一次记忆写入应当对应可追踪事件,一次召回应记录使用了哪些记忆,一次错误决策也应能够反查当时的记忆版本。
最大风险是让错误和隐私泄露也实现“互操作”
**标准化会放大好处,也会放大记忆系统已有的问题。**如果一条未经验证的模型推断能够在多个 Agent 之间自由流动,错误就会从局部幻觉升级为长期共享状态。
安全风险至少包括四类:
- **记忆投毒:**攻击者通过网页、邮件或工具输出诱导 Agent 写入恶意长期指令;
- **权限扩散:**原本只对单一应用开放的信息被其他 Agent 读取;
- **过度推断:**系统从行为记录中推导敏感属性,并将推断结果当作事实保存;
- **删除失效:**用户删除原始内容后,摘要、向量和派生记忆仍然存在。
**记忆标准必须把信任边界放进基础设计,而不是事后增加一个权限字段。**来源签名、敏感级别、用途限制、派生关系、撤销状态和审计日志,都应成为规范的一等公民。
这也是 Agent Memory Format 比普通数据交换格式更难的原因。它不能只是“把数据搬出去”,还要确保接收方理解原有权限,不会因为导入导出而把仅限本地的记忆变成全局知识。
现在谈标准不算早,但谈胜负还太早
**Agent Memory Format 提出了一个方向正确、落地难度很高的问题。**智能体要从一次性聊天工具变成持续工作的个人或企业代理,就必须拥有跨会话状态;而跨会话状态一旦积累,就必然出现迁移、审计、删除和互操作需求。
现阶段最合理的路线不是立刻追求一个包办所有场景的庞大规范,而是先建立最小公分母:稳定的对象标识、主体与命名空间、记忆类型、来源链、有效时间、权限、版本和删除语义。向量、图谱、摘要和多模态附件可以作为扩展层逐步加入。
**行业最终需要的也不是“记忆领域的唯一数据库”,而是“记忆领域的共同语言”。**OpenTelemetry 的成功不在于消灭 Datadog、Prometheus 或 Jaeger,而在于让应用不必为每个后端重新发明遥测数据。Agent Memory Format 若想复制这条路径,也必须保持供应商中立,并允许不同模型、框架和存储系统在同一语义基础上竞争。
短期看,这项倡议不会让各家智能体立刻互相继承记忆。长期看,它点中了 Agent 基础设施里一个被低估的瓶颈:模型越来越强,工具协议越来越丰富,但用户仍无法真正拥有、迁移和治理自己的智能体记忆。
这件事值得做,而且应该在记忆数据被少数平台彻底固化之前开始做。
参考来源
- OpenTelemetry Specification:OpenTelemetry 官方规范仓库,可用于理解开放语义约定、数据模型和供应商中立设计。
- AgentGuide:Agent Memory 核心论文整理:汇总记忆流、反思、技能库及不同记忆形态的研究脉络。
- LangMem:LangChain 团队的长期记忆工具项目,展示记忆抽取、更新和命名空间管理的工程实现。
- Mem0:开源智能体记忆项目,可用于观察当前记忆层的存储、检索和个性化实践。
- Letta:围绕有状态智能体与长期记忆构建的开源项目,体现持久状态对 Agent 架构的影响。