64GB内存塞下284B模型?
llama-modchip 声称无需 GPU,即可在 64GB DDR5 内存中运行 284.33B 参数的 DeepSeek-V4-Flash,解码速度最高达 14.7 tokens/s。但极低比特量化的质量损失、256K 上下文实测和硬件配置仍待验证。
284B 模型被压进了 64GB 内存
llama-modchip 项目近日声称,它已经让一个总参数量为 284.33B 的 DeepSeek-V4-Flash 模型,在没有 GPU、只有 64GB DDR5 系统内存的机器上完成纯 CPU 推理。项目给出的进程内存占用为 57.61 GiB,解码速度为 9.1—14.7 tokens/s,提示词预填充速度则达到 44.36 tokens/s。
这项结果真正值得关注的地方,不是“CPU 也能跑大模型”,而是一个通常需要上百 GB 内存的 284B 模型,被压缩到了消费级主机勉强能够容纳的范围。按照项目公布的数据,优化后的模型文件占用为 56.56 GiB,相比此前的 76.87 GiB 减少了 20.31 GiB,降幅约为 26.4%。
不过,这仍然是一项由项目开发者自行公布的工程结果,而不是经过第三方复现的标准化评测。截至 2026 年 11 月 8 日,公开信息尚不足以证明它能在所有 64GB 电脑上稳定运行,也不能证明极低比特量化后的模型质量仍然接近高精度版本。
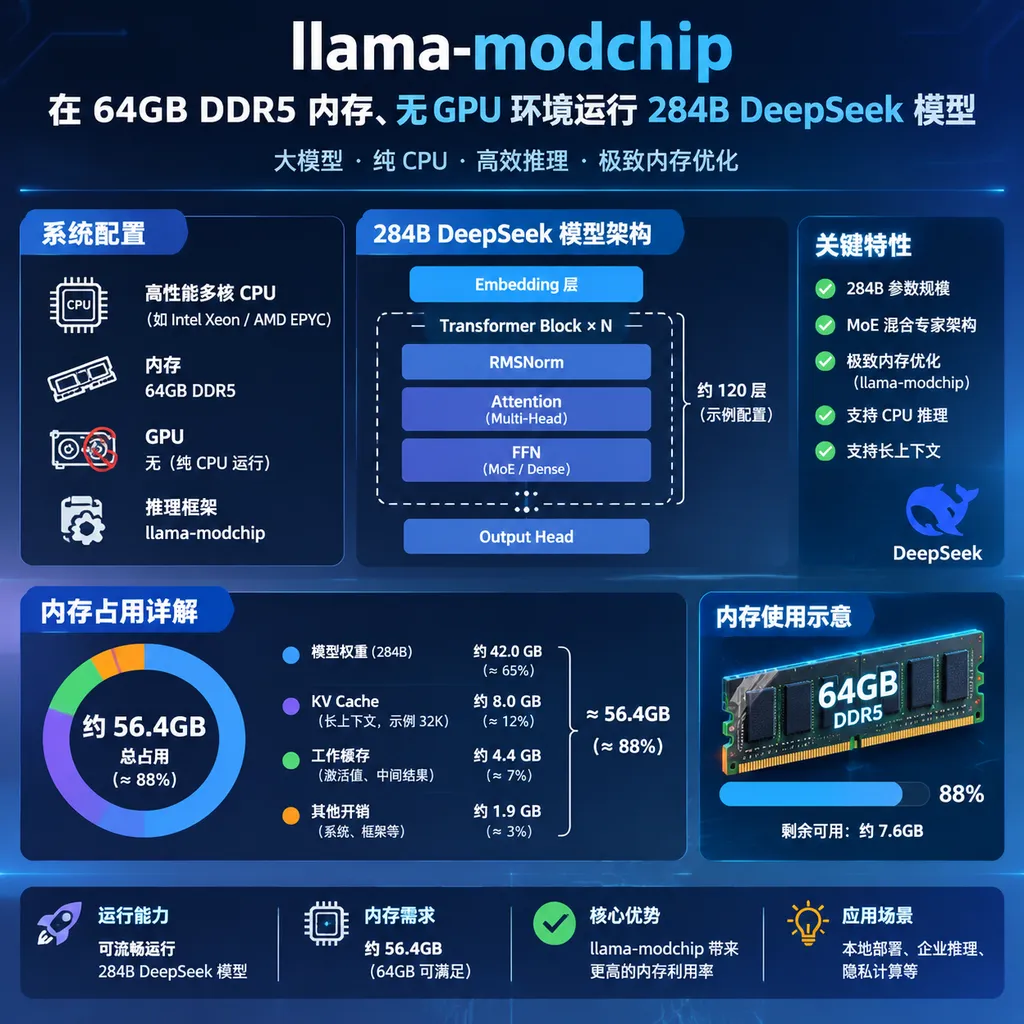
关键数据:57.61 GiB 内存,最高 14.7 tokens/s
llama-modchip 是一个基于 llama.cpp 思路修改的 CPU 推理项目,目标是通过定制量化格式、内存布局和 AVX2、AVX-512 CPU 内核,降低超大规模 MoE 模型的存储与运行门槛。项目代码已经在 GitHub 公开,但其模型量化产物、硬件环境和完整测试方法仍是判断结果能否复现的关键。
项目目前对外披露的核心参数如下:
| 项目 | llama-modchip 公布的数据 | 需要注意的问题 | |---|---:|---| | 模型名称 | DeepSeek-V4-Flash | 这是项目所使用的模型名称,需与模型权重来源和版本对应核验 | | 总参数量 | 284.33B | 总参数约 2843 亿 | | 单次推理激活参数 | 约 13B | 只降低每个 token 的计算量,不代表其余权重可以全部删除 | | 优化前模型占用 | 76.87 GiB | 已明显低于常规 INT4 的理论体积 | | 优化后模型占用 | 56.56 GiB | 比优化前减少 26.4% | | 实际进程内存 | 57.61 GiB | 距离 64 GiB 上限仅剩约 6.39 GiB | | GPU 数量 | 0 | 完全依靠 CPU 和系统内存 | | CPU 解码速度 | 9.1—14.7 tokens/s | 尚缺统一 CPU 型号、线程数和采样参数下的第三方结果 | | 提示词预填充 | 44.36 tokens/s | 优化前为 25.05 tokens/s,提升约 77.1% | | 配置上下文长度 | 256K | “配置为 256K”不等于已经完成 256K 满上下文压力测试 | | CPU 指令集 | AVX2、AVX-512 | 实际性能高度依赖处理器型号、内存通道与频率 |
这些数字如果能够独立复现,意味着普通工作站运行超大 MoE 模型的门槛会明显下降。9.1—14.7 tokens/s 已经不是只能证明“模型能启动”的实验速度,而是接近单用户聊天和代码辅助可以接受的区间;44.36 tokens/s 的预填充速度,也足以处理一段中等长度的文档输入。
但“可以运行”和“可以完整使用”仍然是两件事。模型能生成短回答,不代表它能在 256K 上下文、多个并发请求或长时间持续负载下维持相同速度,更不代表量化后的推理质量没有明显下降。
为什么 284B 参数不等于每次都计算 284B
MoE 是 Mixture of Experts 的缩写,即“混合专家模型”,它通过路由器为每个 token 选择少量专家参与计算,而不是每次调用全部参数。llama-modchip 所运行的模型总参数为 284.33B,但项目声称每个 token 只激活约 13B 参数,激活比例约为 4.57%。
这正是纯 CPU 推理仍可能达到两位数 tokens/s 的前提。若每生成一个 token 都要执行完整的 284B 参数计算,普通桌面 CPU 几乎不可能达到项目所公布的速度;当实际参与计算的参数下降到约 13B 后,算力需求更接近一个中小型稠密模型。
MoE 的限制在于,未激活参数虽然不参与当前 token 的主要矩阵计算,却通常仍需保存在内存中。因为下一个 token 可能被路由到另一组专家,系统不能简单地只加载固定的 13B 参数,这也是“13B 激活参数”此前仍需要上百 GB 内存的原因。
llama-modchip 的价值因此不只是利用了 MoE 稀疏激活,而是进一步降低了全部专家权重的常驻体积。换句话说,MoE 解决的是“每一步算多少”,极低比特量化解决的是“所有权重放在哪里”,两者缺一不可。
56.56 GiB 意味着接近 1.7 bit/参数
量化是把模型权重从 FP16、FP8 等高精度数值压缩为更低位宽整数或离散编码的技术,其目的在于减少模型体积、内存带宽消耗和推理成本。量化位数越低,压缩收益通常越大,但模型精度损失和解码复杂度也会随之增加。
按照 284.33B 参数和 56.56 GiB 文件体积粗略计算,模型平均每个参数占用约 1.7 bit。这个数字还可能包含量化比例因子、分组元数据和模型结构信息,因此实际权重编码可能采用混合位宽,而不是所有参数统一使用某一种整数格式。
不同精度下的理论体积差距非常直观:
| 权重格式 | 284.33B 参数的理论体积 | 与 56.56 GiB 的关系 | |---|---:|---| | FP16,16 bit/参数 | 约 568.7 GB | 约为项目文件的 9 倍以上 | | FP8,8 bit/参数 | 约 284.3 GB | 约为项目文件的 4.7 倍 | | INT4,4 bit/参数 | 约 142.2 GB | 仍明显超过 64GB 内存 | | INT3,3 bit/参数 | 约 106.6 GB | 仍无法装入 64GB | | llama-modchip 公布结果 | 56.56 GiB,约 60.7 GB | 平均约 1.7 bit/参数 |
这组对比说明,项目并不是靠常规 4 bit 量化把模型塞进内存。常规 INT4 即使不计算 KV Cache、运行时缓冲和系统开销,284.33B 参数也需要约 142GB;要把文件压到 60GB 左右,必须进入 2 bit 附近甚至采用非均匀混合量化。
极低比特量化也是目前最大的疑点。模型在 1.7 bit/参数附近能否保持推理、代码生成、数学和长上下文能力,不能通过几个聊天样例判断,至少需要与 FP8、INT4 版本进行同提示词、同采样设置的准确率和困惑度对比。
性能数字为何在工程上并非完全不可能
纯 CPU 推理的瓶颈通常不是峰值浮点算力,而是内存带宽和权重读取效率。对于大模型的单用户逐 token 解码,CPU 需要不断从内存读取权重;权重越小、布局越连续、缓存命中率越高,每秒能够生成的 token 就越多。
llama-modchip 声称使用了定制 AVX2 和 AVX-512 内核。AVX2 和 AVX-512 是 x86 CPU 的向量指令集,可以让处理器在一条指令中并行处理多组数据,但 AVX-512 是否可用、执行吞吐以及持续频率会因 CPU 型号而显著不同。
项目公布的 9.1—14.7 tokens/s 并不能脱离硬件配置单独理解。双通道消费级 DDR5、四通道工作站平台和八通道服务器平台的有效内存带宽可能相差数倍;即使内存容量同为 64GB,最终速度也可能完全不同。
预填充从 25.05 tokens/s 提升到 44.36 tokens/s,则更能体现内核优化的作用。预填充是模型一次性读取并处理输入提示词的阶段,通常具有更高的矩阵计算并行度;解码是逐个生成新 token 的阶段,通常更受内存带宽和单批次效率限制。
项目需要补充的并不是更多“能跑起来”的截图,而是一套可重复的测试矩阵。至少应公开 CPU 型号、核心数、内存通道、DDR5 频率、操作系统、编译器参数、线程数、NUMA 设置、模型文件校验值、提示词长度和采样配置,否则 14.7 tokens/s 很难成为可比较的性能结论。
64GB 这个说法比看上去更紧张
57.61 GiB 的进程内存占用并没有给操作系统留下多少空间。如果机器实际拥有 64 GiB 物理内存,理论余量约为 6.39 GiB;这部分空间还要容纳操作系统、文件缓存、终端服务和其他后台进程。
GB 与 GiB 的混用也可能导致误判。64GB 按十进制换算只有约 59.6 GiB,而内存条标称容量和操作系统显示方式又不完全一致,因此用户不能只看到“64GB”就认定自己的机器一定满足要求。
256K 上下文更不能只看启动参数。上下文长度越大,KV Cache 通常越大;即使模型使用了 KV 压缩、潜在注意力或其他节省缓存的结构,真正填满 256K token 后的内存占用也会高于短提示词测试。
“256K configured context”更准确的理解是推理程序允许设置这一最大窗口,而不是项目已经证明能在 57.61 GiB 内存占用下完整处理 256K 输入。要确认这一点,需要看到从短上下文到 32K、128K、256K 的峰值内存、首 token 延迟和解码速度曲线。
它比普通 70B 本地部署更实用吗
llama-modchip 的优势是模型容量上限,而不是部署体验。一个 70B 稠密模型采用 4 bit 量化后通常需要约 35GB 权重空间,在 64GB 内存机器上拥有更充裕的 KV Cache 和系统余量;284B MoE 虽然每次只激活约 13B 参数,但其专家权重仍几乎占满整台机器。
| 方案 | 典型权重占用 | 运行余量 | 潜在优势 | 主要代价 | |---|---:|---:|---|---| | 70B INT4 稠密模型 | 约 35GB | 较充足 | 部署成熟、兼容性较好 | 总模型容量较小 | | 284B 常规 INT4 MoE | 约 142GB | 64GB 无法容纳 | 总专家容量更大 | 需要工作站或服务器内存 | | 284B llama-modchip | 56.56 GiB 文件、57.61 GiB 进程 | 非常紧张 | 64GB 级别主机可能运行 | 极低比特质量、稳定性和兼容性待验证 | | GPU 本地推理 | 取决于显存与卸载策略 | 受显存限制 | 并行吞吐通常更高 | 硬件成本高,超大模型需多卡 |
对于普通个人用户,成熟的 32B 或 70B 量化模型仍然更均衡。它们更容易安装、速度更可预测,也能为长上下文和其他应用留下内存;llama-modchip 更像一项证明“284B 可以跨过 64GB 门槛”的工程实验,而不是已经取代主流本地部署方案的成品。
对于研究者和高隐私场景,这项工作仍然有直接价值。无 GPU 推理意味着模型可以运行在没有独立显卡的工作站、服务器或隔离网络环境中,模型权重和输入数据不必离开本机,同时也避开了多 GPU 通信和显存切分的复杂性。
真正需要验证的是质量,而不是参数量
参数量并不能替代模型质量评测。一个 284B 模型如果因为接近 2 bit 的量化而在代码、数学、工具调用和长上下文任务上明显退化,实际价值可能不如一个保真度更高的 70B INT4 模型。
后续最值得关注的验证项目包括:
- 使用相同提示词,对比原始精度、INT4 和 llama-modchip 版本的输出一致性;
- 公布 MMLU、GPQA、HumanEval、LiveCodeBench 等评测的量化前后分数;
- 测试 32K、128K 和 256K 实际上下文,而不是只展示配置值;
- 在多款 AVX2、AVX-512 CPU 上复现 9.1—14.7 tokens/s;
- 记录持续生成数千 token 时的速度、内存峰值和稳定性;
- 公布模型权重来源、量化流程、文件校验值及许可证兼容情况;
- 对比双通道、四通道和服务器多通道 DDR5 平台的内存带宽影响。
llama-modchip 目前最合理的定位,是一次针对 MoE 权重存储和 CPU 内核的激进优化。它证明了超大模型的本地部署边界不只由 GPU 显存决定,量化格式、内存布局、专家路由和 CPU 指令优化同样能够改变硬件门槛。
这项工作距离“普通电脑轻松运行 284B 模型”仍有明显距离。57.61 GiB 的进程占用几乎吃满 64GB 内存,256K 上下文尚需完整压力测试,1.7 bit/参数附近的质量损失也没有权威对比;在这些问题得到独立复现之前,14.7 tokens/s 是一个值得关注的开发者成绩,但还不是可以直接外推到所有用户的产品结论。
参考来源
- llama-modchip GitHub 项目:项目源代码、实现说明及开发者公布的运行数据。
- Reddit:本地运行 DeepSeek 的硬件与模型规模讨论:可用于对照不同参数规模模型在消费级设备上的部署体验。
- 知乎:无 GPU 服务器部署 DeepSeek 的 llama.cpp 实践:介绍 CPU 推理、模型量化和内存占用的基本关系。