AutoDNA把AI智能体送进湿实验室
上海交大AutoDNA登上Nature,可自主协调20余类仪器、执行超11000步操作。它真正重要的突破,不是让AI生成实验方案,而是打通了从设计到物理执行的闭环。
AI第一次真正接管复杂分子生物学实验流程
上海交通大学团队近日在《Nature》发表AutoDNA研究,让AI智能体从生成实验方案进一步走进了需要机械臂、移液器、热循环仪和测序设备协同工作的“湿实验室”。截至11月8日,这项成果已获《Nature》官网首页重点报道,同期News & Views栏目还刊发了斯坦福大学James Zou教授的专题评述。
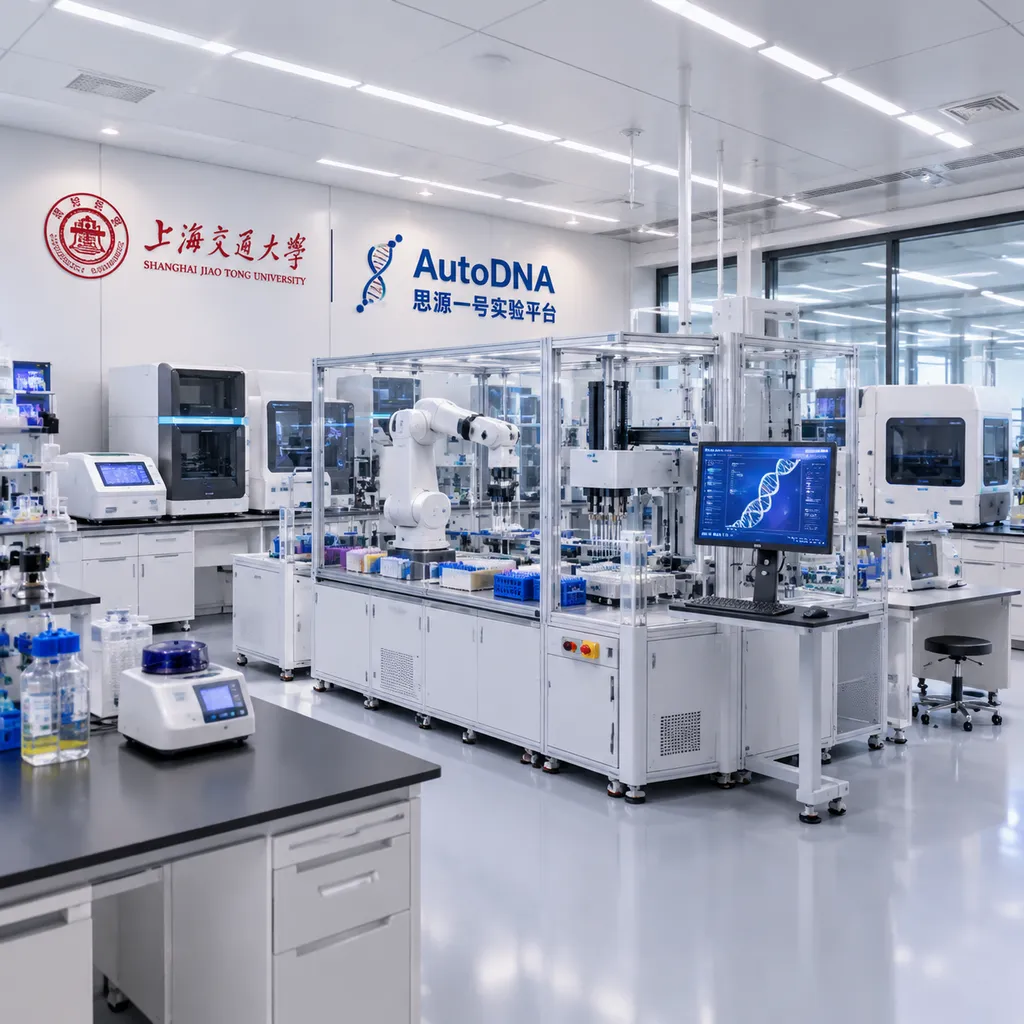
**AutoDNA是一套面向生物分子工程的AI原生自主实验平台。**它能够把研究人员提出的自然语言任务,转化为文献检索、试剂选择、实验设计、控制代码生成、硬件执行、结果分析和方案迭代等连续步骤,并自主协调20余类仪器完成核酸合成、转录、扩增和测序。
这项工作的意义,不是又造出了一套实验室自动化流水线,而是尝试把AI变成整个实验系统的“总调度员”。传统自动化设备往往只能重复人类预先写好的固定流程;AutoDNA则可以根据实验目标组织设备、检查执行结果,并依据反馈调整下一轮方案。
关键不是机械臂,而是“AI原生”
**AI原生实验室是从系统设计之初就让模型参与实验规划、资源调度和结果优化的自动化实验环境。**它与给现有仪器额外接入一个大模型的做法不同,后者通常只是让AI辅助查论文、写方案或分析数据,实验流程和设备配置仍由人类专家预先确定。
现有不少“自动驾驶实验室”已经能在材料、化学等领域完成闭环优化,但适用范围通常集中在目标单一、步骤明确、仪器相对简单的任务。分子生物学实验的难点在于,一次实验可能要同时处理液体转移、温度控制、样本搬运、扩增、测序和数据分析,任何一个环节出现污染、时序错误或试剂遗漏,都可能让数十小时的流程失效。
AutoDNA选择了一条更接近操作系统的路线:模型负责理解任务和生成计划,中间层把不同仪器包装成可调用的标准能力,底层执行系统则保证设备不会因为资源冲突、时序错乱或参数越界而失控。
| 实验室架构 | 谁决定实验流程 | 仪器如何协作 | 能否依据结果迭代 | 主要局限 | |---|---|---|---|---| | 传统人工实验室 | 人类研究人员 | 人工操作与记录 | 可以,但速度受人力限制 | 重复劳动多,难以长时间连续运行 | | 固定自动化流水线 | 人类预先编程 | 按固定脚本执行 | 通常不能自主调整 | 更换实验目标后需要重新配置 | | “外挂式”AI实验室 | 人类主导,AI辅助局部任务 | 专家预设设备与规则 | 可在局部环节优化 | AI缺少对实验全局的理解 | | AutoDNA式AI原生实验室 | 多智能体规划并动态调整 | 通过统一能力接口编排设备 | 支持“设计—实验—优化”闭环 | 仍受模型随机性、硬件通量和维护需求限制 |
**“AI原生”并不意味着完全抛弃人工,而是把人工从逐步操作转移到目标设定和硬件维护。**在论文展示的任务中,人类仍需定期补充试剂、耗材并清理实验废弃物,系统也没有解决所有异常情况,因此把AutoDNA称为“无人实验室”并不准确。
多智能体负责想,原子服务负责动
**多智能体架构是把一个复杂任务拆给多个具有不同职责的AI智能体协同完成的系统设计。**AutoDNA中的专业智能体分别处理文献、试剂、实验协议、代码、硬件和结果假设,规划智能体再根据任务进度组织这些角色工作。
这种拆分解决的是长链条实验难以由单次模型输出覆盖的问题。让一个大模型一次性生成上万步操作,不但容易出现遗漏,也很难在实验中途根据新结果改动局部流程;多智能体则更像实验室里的课题组,不同角色分别负责查资料、设计方案、操作设备和复核结果。
**原子服务是对单台仪器最小可调用能力的标准化抽象。**AutoDNA用自然语言描述和统一接口告诉模型,一台设备能够完成什么动作、需要哪些输入、有哪些约束,而不要求模型直接理解每个厂商的底层控制协议。
这层抽象类似计算系统中的设备驱动:上层应用不必知道不同硬盘或显卡的内部实现,只需要调用统一能力。对于实验室而言,它屏蔽了不同型号移液器、加热器和荧光检测仪之间的差异,也让代码智能体能够生成、检查并修正跨设备控制流程。
**高精度硬件仍是AutoDNA能落地的前提。**平台提供微米级定位和微升级液体处理能力,实验执行系统负责程序检查、设备状态跟踪、资源分配与时序约束;如果只有大模型而没有这套确定性执行层,模型的一次错误输出就可能直接污染样本或损坏设备。
超过11000步,不只是实验室Demo
**AutoDNA在四类代表性任务中验证了从方案设计到硬件执行的完整闭环。**这些任务包括核酸检测、酶促DNA合成优化、DNA数据存储与读取,以及肿瘤相关突变检测,覆盖了优化实验、长时间工作流和临床样本处理等不同场景。
| 测试任务 | 关键结果 | 执行规模 | 说明 | |---|---:|---:|---| | RPA核酸检测 | 荧光读数与人工对照无显著差异 | 三阶段流程、多设备协作 | 系统能推断封盖需求,并发现漏加试剂的控制缺陷 | | 酶促DNA合成优化 | 平均单步合成产率97.8% | 迭代9轮,单轮循环40分钟 | 产率达到已发表人工专家优化结果的水平 | | 并发实验调度 | 执行速度提升3.2倍 | 平均耗时由1433.7分钟降至454.0分钟 | 通过合并四组协议提高设备利用率 | | DNA数据存储闭环 | 精确恢复原始数字内容 | 78条DNA链、203.5小时、11382步硬件操作 | 覆盖编码、合成、保存、测序和解码 | | 肿瘤突变检测 | 识别并验证KRAS G13D突变 | 137.7小时、9551步硬件操作 | 结果与临床检测一致 |
**97.8%的单步合成产率说明AutoDNA不只是会执行,也能做多目标实验优化。**在TdT介导的酶促DNA合成任务中,系统需要同时考虑产率和反应时间,并在缓冲液、表面活性剂、试剂浓度和反应时长等变量之间寻找平衡。
系统经过9轮迭代后,将平均单步合成产率提升至97.8%,循环时间控制在40分钟。测序结果显示,缺失、插入和替换错误率分别为1.5%、0.6%和0.5%,整体达到人工专家优化基准。
**3.2倍的并发提速体现了AI调度比单纯机械自动化更有价值。**AutoDNA将四组合成协议合并执行后,平均探索时间从1433.7分钟降至454.0分钟,减少979.7分钟,降幅约68.3%;在三个用户动态提交任务的场景中,系统还能用空闲热循环仪替代被占用的加热设备,使平均完工时间减少115.1分钟。
这里的提升并不是仪器本身突然变快,而是系统减少了设备等待和重复操作。它更像云计算集群的任务调度:单台服务器性能没有变化,但合理安排任务后,整个集群的吞吐量会明显增加。
11382步DNA存储闭环,证明的是可靠性而非容量
**DNA数据存储是把数字信息编码为DNA碱基序列,并通过测序读取的存储方式。**它具有理论存储密度高、保存时间长和静态维护能耗低等特点,但现实应用一直受到合成成本、读写速度和全流程复杂度限制。
AutoDNA从用户的数据写入与读取需求出发,衔接数字编码、DNA合成、样本处理、保存、测序和解码,最终完成78条数据编码DNA链的合成与读取,并准确恢复原始数字内容。整个周期持续约203.5小时,累计执行11382步硬件操作。
**这项DNA存储实验最值得关注的指标不是78条DNA链,而是连续203.5小时的跨设备运行。**78条链离实用级大容量存储还有明显距离,但超过八天的持续任务证明,AI系统可以在有限人工介入下维持复杂流程,并处理设备资源、实验时序和中间结果。
因此,AutoDNA目前更像一套DNA存储产线的系统原型,而不是已经可以商业部署的DNA硬盘。它验证的是端到端编排与长期可靠性,尚未证明大规模写入吞吐量、单位数据成本以及不同批次之间的一致性。
临床样本测试把难度又推高了一层
**KRAS G13D是KRAS基因第13位密码子发生的特定突变,与部分肿瘤的分子诊断相关。**AutoDNA面对未知结直肠癌组织样本,自主完成测序、突变识别、引物设计、引物合成和实验验证,最终锁定KRAS G13D突变。
这一流程持续137.7小时,共执行9551次硬件操作,合成的引物首次验证即通过,PAGE与等位基因特异性PCR结果也与临床检测一致。相比在已知流程上重复操作,从未知样本中发现候选突变并设计后续验证实验,更接近科研人员真实的工作方式。
**一次成功的临床样本演示不能直接等同于医疗诊断能力。**临床应用还需要更大样本量、灵敏度和特异性评估、污染控制、设备校准、质量管理体系及监管认证,AutoDNA论文证明的是平台可以执行临床相关研究流程,而不是已经获得临床使用资格。
它不是“AI科学家”,但已经超过实验助手
**AutoDNA当前更准确的定位是自主实验操作系统,而不是能够独立提出重大科学问题的AI科学家。**它最强的能力集中在任务拆解、设备编排、实验执行和局部优化,实验的大方向、评价标准和可用仪器仍由人类确定。
这不妨碍它成为AI for Science领域的重要进展。过去的大模型主要生活在数字世界里,错误回答最多导致文本或代码不可用;进入湿实验室后,错误会消耗真实试剂、污染珍贵样本,甚至造成设备风险,因此系统必须在概率模型之外增加代码检查、状态追踪和确定性控制。
**AutoDNA真正建立的是模型与物理设备之间的可信执行链。**大模型负责处理语义模糊、信息不完整的上层任务,自动化系统负责保证下层动作精确可控,这种分层架构比让一个通用智能体直接控制所有设备更现实。
三个限制决定它离全面普及还有多远
**大模型输出的随机性仍然会影响实验可重复性。**相同任务在不同时间可能生成略有差异的方案,科研实验却要求过程可追溯、参数可复现,因此未来系统需要冻结关键流程、记录模型版本与推理轨迹,并通过检索增强和规则验证降低随机输出的影响。
**实验吞吐量仍受物理设备而不是模型算力限制。**DNA合成、扩增和测序都需要真实反应时间,升级大模型无法把40分钟的生化反应压缩成几秒;提高效率要依靠更高通量仪器、并行反应体系和更好的资源调度。
**耗材补充与异常维护仍然依赖人类。**目前人工参与主要包括补充试剂和耗材、清理废弃物及处理硬件问题,研究团队下一步计划引入可自主运输试剂的移动机器人、更高性能的实验设备,以及更完善的文献数据库和检索增强生成系统。
判断:价值不在替代科学家,而在复制高水平实验能力
**AutoDNA最可能率先改变的是标准化程度高、流程很长且重复次数多的实验。**DNA合成条件优化、核酸检测流程开发、样本批处理和DNA存储产线,都比高度依赖直觉和临场观察的探索性实验更适合率先自动化。
对于高校和企业实验室而言,这种平台的吸引力也不只是节省人力。它可以把实验协议、设备能力和历史结果沉淀为机器可执行资产,让同一套流程在不同时间稳定复现,并允许多个研究人员共享昂贵设备。
**AutoDNA提出的“科学即服务”更像实验能力的云化,而不是把科学研究变成聊天机器人。**研究人员未来可能只需描述目标、约束和评价指标,系统便能分配设备、排队执行、返回实验数据与完整日志;但决定问题是否值得研究、结果是否具有科学意义,仍然需要人类判断。
这项Nature成果最值得肯定的地方,是上海交大团队没有停留在让AI读论文、写实验方案的表层应用,而是啃下了跨设备协议、实时调度、微量液体控制和长时间稳定运行这些更难展示、却决定系统能否真正使用的工程问题。
AutoDNA还不是完全自主的AI科学家,但它已经让AI智能体跨过了从“会说实验”到“能做实验”的门槛。
参考来源
- IT之家:上海交大构建AI原生科学实验室AutoDNA装置 —— 汇总AutoDNA的Nature发表信息、系统架构、仪器协同方式及主要实验结果。