openJiuwen发布TTSE双轨自演进
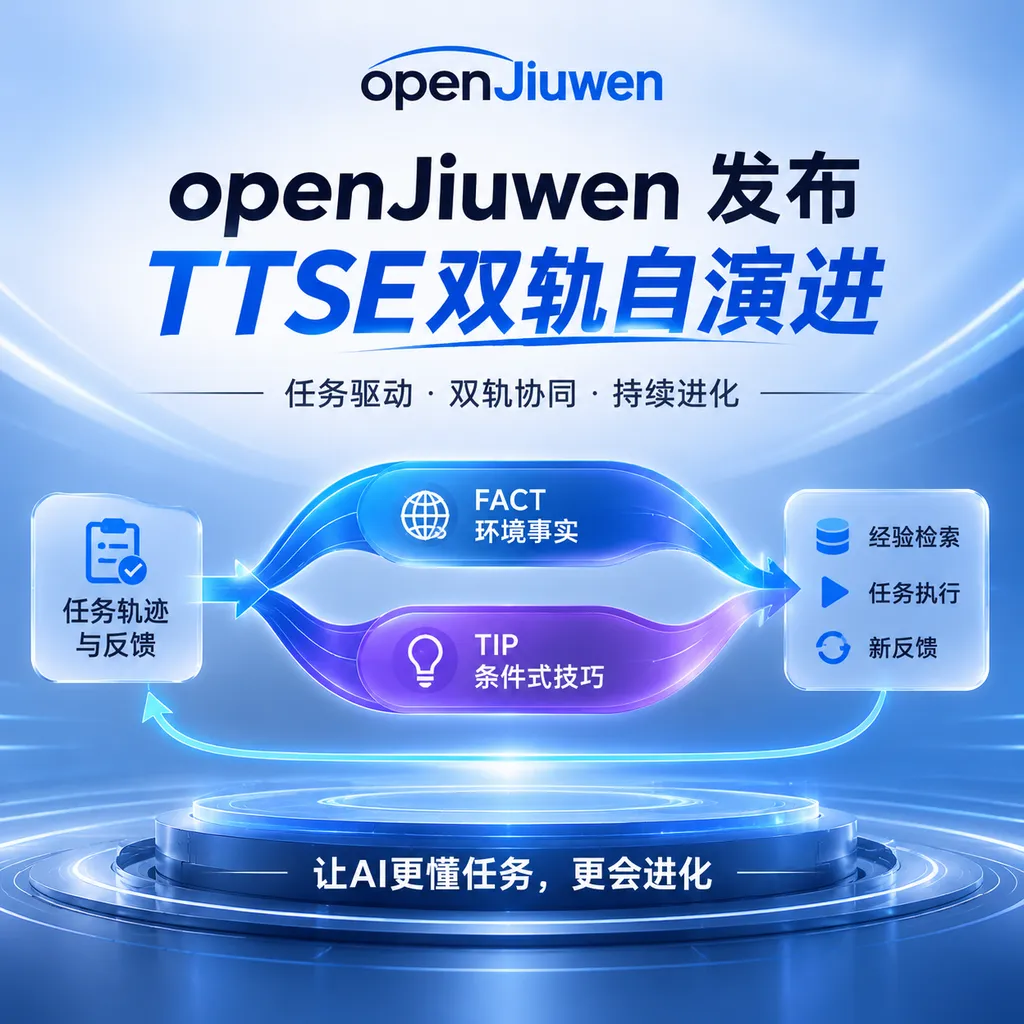
openJiuwen推出TTSE经验学习框架,将环境事实与执行技巧分轨演进,让Agent从真实任务中持续学习,同时减少Token消耗和无效工具调用。
openJiuwen发布TTSE双轨自演进:Agent开始真正积累经验
openJiuwen近日发布TTSE经验学习框架,试图解决Agent系统一个长期存在、却经常被“长期记忆”概念掩盖的问题:Agent完成了上百次任务,为什么第一百零一次仍然可能像第一次上班?
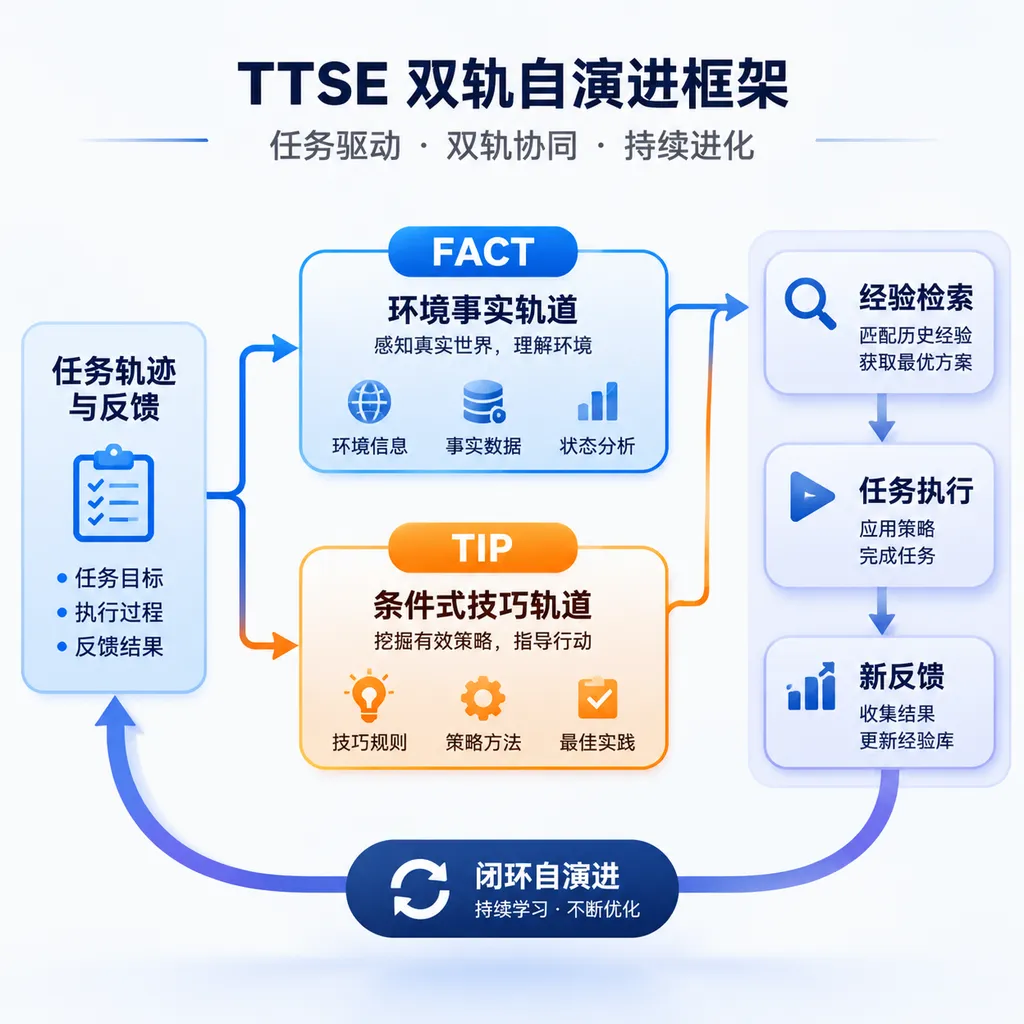
TTSE是一个面向LLM Agent的双轨在线自演进框架,全称为Two-Track Self-Evolution。 它不只保存Agent做过什么,而是把任务经验拆成环境事实FACT与条件式技巧TIP两类知识,并通过后续任务不断验证、修正和淘汰这些经验。
这不是给Agent加一个更大的聊天记录,也不是简单地把成功轨迹塞进向量数据库。TTSE真正想做的是建立一套经验管理制度:哪些信息是当前环境中的客观事实,哪些方法只在特定条件下有效,哪些旧经验已经过期,都需要分别管理。
这套思路已经进入openJiuwen的公开代码与WorkSwarm配置体系。官方GitHub文档显示,TTSE由独立的react.ttse配置控制,可以从任务轨迹归纳经验、将相关经验注入系统提示,并定期整理经验库。
Agent缺的不是记忆,而是可信的经验
当前多数Agent记忆系统解决的是“能否找回过去”,TTSE关注的则是“找回的内容是否仍然正确”。 两者听起来接近,工程难度却完全不同。
传统记忆系统通常会从对话、工具调用或任务轨迹中提取摘要,再使用关键词或向量相似度进行检索。用户第二次提出相似需求时,Agent可以看到上次的操作过程,从而减少重复探索。
问题在于,过去成功的操作并不等于现在仍然有效。
例如,一个办公Agent曾经发现,某个表格应用的导出入口位于页面右上角。它把这一经验保存下来,下次就可以直接点击。但应用升级后,按钮可能被移动到文件菜单中。如果Agent把“右上角存在导出按钮”与“导出时优先寻找显眼按钮”混成一条经验,它可能连续点击错误位置,甚至把偶然成功当成稳定规律。
经验失效的根源,是环境知识与行动策略具有不同的生命周期。 环境事实会随着软件版本、权限、网页结构和文件内容发生变化;执行技巧则可能在某些条件下长期有效,但换一个场景就不成立。
TTSE因此借鉴认知科学中陈述性知识与程序性知识的区分,把经验拆成两条轨道:
- FACT是环境事实,描述“当前世界是什么样的”,例如按钮位置、文件结构、工具能力、权限状态和页面元素。
- TIP是条件式技巧,描述“在什么条件下应该怎么做”,例如遇到弹窗时先关闭遮罩层,再定位目标控件。
FACT需要持续核对真实性,TIP需要持续评估适用条件。分开管理后,环境变化不必导致整套执行方法作废,而技巧有效也不能反过来证明环境认知永远正确。
双轨机制具体怎么运转
TTSE的核心不是一次性总结经验,而是让经验在真实任务中接受持续审查。 一条经验被写入系统后,并不会自动成为永久规则,而是进入后续任务的验证闭环。
按照openJiuwen披露的机制,TTSE主要包括双轨知识表示、冷启动、在线增量演进以及最终输出与评估四个环节。
第一步是从历史轨迹或初始化材料中建立经验库。Agent会分析任务中的观察结果、工具反馈、失败原因和最终交付,把可验证的环境信息归入FACT,把带有适用条件的执行方法归入TIP。
第二步是在新任务开始前检索相关经验。当前WorkSwarm文档显示,TTSE可通过经验注入为Agent提供系统级指引;在Embedding配置完整时使用混合召回,否则回退至BM25关键词检索。
第三步是把执行结果重新转化为证据。Agent调用工具后得到的新页面、新错误或新结果,不只是当前任务的Observation,也是检验旧经验是否可靠的新样本。
第四步是更新经验状态。得到支持的经验可以增强置信度,出现冲突的FACT需要修正,适用范围过宽的TIP需要补充条件,长期无效或已经过时的内容则应被退役。
这套设计更像代码仓库的持续集成,而不是笔记软件的自动收藏。 每一条经验都相当于一个等待测试的假设,新任务就是新的测试环境;只有持续通过验证的经验,才值得在后续执行中被优先采用。
TTSE与常见Agent学习方案有什么不同
TTSE位于普通记忆与模型训练之间,主打低成本、可追溯的在线适应。 它不会直接修改基础模型参数,因此更新速度通常快于强化学习;同时又比原样保存执行轨迹多了一层验证与治理机制。
| 方案 | 保存或更新的对象 | 更新速度 | 是否区分环境与技巧 | 可追溯性 | 主要问题 | |---|---|---:|---:|---:|---| | 对话历史 | 原始消息与上下文 | 实时 | 否 | 高 | 上下文越来越长,噪声持续累积 | | 向量记忆 | 任务摘要或知识片段 | 较快 | 通常不区分 | 中等 | 相似不等于正确,旧知识可能污染决策 | | Skill自演进 | 工具说明、流程和技能文档 | 较快 | 部分区分 | 高 | 容易把环境变化写进通用流程 | | 在线强化学习 | 模型策略或附加参数 | 较慢 | 隐式学习 | 较低 | 训练成本高,更新结果不易解释 | | TTSE双轨经验 | FACT环境事实与TIP条件式技巧 | 较快 | 是 | 高 | 依赖高质量轨迹、评估与冲突处理 |
TTSE与openJiuwen此前的Harness和Artifacts双维度RSI并不是替代关系。Harness关注Agent的工作方式与运行机制,Artifacts关注报告、代码、文档等交付成果,TTSE则进一步处理执行过程中产生的经验。
三者分别回答了“系统怎么工作”“成果怎么改进”和“经验怎么沉淀”。 这意味着Agent自演进正在从模糊的“自动变聪明”,走向不同层级分别优化的工程体系。
五类基准给出了什么结果
TTSE的实验结果表明,双轨经验管理的收益不只体现在成功率,也体现在执行步数和稳定性。 团队在ALFWorld、ScienceWorld、GDPevo、SOPBench及PinchBench等基准中测试了该框架,并对关键实验进行了三次独立重复。
| 评测场景 | 关键结果 | TTSE体现的价值 | |---|---:|---| | ALFWorld | GLM-5成功率最高98.51%;DeepSeek-V3.2达到97.8% | 减少环境探索错误,提高具身任务完成率 | | ScienceWorld | Native Success从53.08%升至73.46% | 成功率提高20.38个百分点 | | GDPevo | FACT+TIP平均得分0.2616,约为零样本0.0947的2.8倍 | 双轨完整方案优于仅使用单一经验类型 | | SOPBench | 总体成功率从79.15%提升至94.58% | 与技能管理机制组合后仍有增益 | | PinchBench | 平均得分从0.7439升至0.7822 | 147个真实端到端任务中保持稳定提升 |
其中最值得注意的并不是某个单项跑分,而是消融实验显示FACT与TIP需要同时存在。在GDPevo中,仅积累执行技巧或者仅更新环境事实,表现都没有达到完整双轨方案。
这说明Agent犯错往往不是单纯“不会做”,而是“在错误的世界模型里做了看似合理的事”。 如果Agent误判了页面状态、文件格式或工具能力,再优秀的操作策略也可能产生错误;反过来,如果环境识别正确但缺乏执行技巧,它仍然需要重复试错。
真实任务测试也给出了更直接的成本数字。在公开办公案例中,Agent第二次执行相似任务时,耗时从约1分49秒缩短至1分26秒,降幅约21.1%;工具调用从27次降至18次,减少33.3%;失败调用由2次降至1次,减少50%。
在WorkBuddy Office Bench测试中,WorkSwarm接入TTSE后,任务表现相较原生方案提升3.81%,输入Token消耗下降1.70%,输出Token消耗下降30.09%,平均工具调用次数减少2次。
输出Token下降30.09%可能比3.81%的任务增益更有商业意义。 企业Agent的成本并不只来自模型推理,还来自浏览器操作、搜索、文件读写和外部工具等待;如果经验复用能够减少解释、复盘和重复规划,整体吞吐量可能比单纯提高模型跑分更快改善。
它比“记住上次怎么做”多走了一步
TTSE最实用的部分,是把经验写成带条件、可否定的规则。 一条好的TIP不应该是“导出文件时点击右上角”,而应该是“当页面存在可见导出按钮且没有遮罩层时,优先使用直接导出入口;否则检查文件菜单”。
这个差异看似只是增加了条件描述,实际上决定了经验能否跨任务复用。
在Agent工程中,最危险的知识通常不是完全错误的知识,而是曾经正确、后来失效,或者只在局部场景成立的知识。传统检索系统可能因为它与当前任务高度相似,反而将其排在最前面。
TTSE试图把经验库从静态检索索引变成具有生命周期的决策资产。 当环境证据变化时,FACT可以被覆盖或降权;当TIP持续失败时,系统可以收窄其适用条件,而不是让错误经验无限参与召回。
公开配置还显示,TTSE提供Auto-dream机制,用于静默整理经验库。这里的“整理”不是继续生成更多文本,而是处理经验冗余、冲突与时效性,否则经验越积越多后,检索质量仍然会下降。
现阶段仍有三个问题没有解决
TTSE降低了经验复用风险,但没有消除Agent自演进中的反馈污染。 如果任务评估本身不准确,系统可能把一次偶然成功归纳为有效技巧,也可能把工具临时故障误判为稳定环境事实。
第一个挑战是证据质量。Agent不仅需要记录操作轨迹,还需要知道最终结果是否正确、用户修改了什么、失败发生在哪一步,以及成功是否来自偶然因素。
第二个挑战是经验冲突。不同用户、不同权限和不同软件版本可能产生互相矛盾的FACT,系统必须知道这些事实属于哪个工作空间、账号或时间范围,而不能粗暴地全局共享。
第三个挑战是评估成本。每次任务都进行完整复盘会消耗额外模型调用,因此自演进机制必须证明节省的执行成本高于经验归纳和整理成本。
TTSE当前更适合高频、结构相近且工具环境相对稳定的任务。 例如报表生成、资料整理、网页录入、项目巡检和代码仓库维护,这些场景具有重复步骤,也能提供明确的成功或失败信号。
对于一次性创意任务、评价标准模糊的战略分析或环境高度随机的开放式研究,TTSE仍可能积累大量难以验证的TIP。此时,人工确认、权限隔离和经验审计仍然不可省略。
版本上线情况需要注意
开发者在部署前应区分新闻稿中的产品版本与GitHub当前可核查的公开版本。 openJiuwen披露TTSE双轨演进Rail已进入WorkSwarm 0.2.8,但截至2026年11月10日,GitHub Releases页面可见的对应公开版本标记为v0.2.8.beta1。
与此同时,WorkSwarm的develop分支配置文档已经列出完整TTSE开关,包括轨迹归纳、经验注入、Auto-dream和Embedding配置。这表明功能已经进入公开工程体系,但生产环境用户仍应检查具体Release、依赖的agent-core版本及升级说明,而不是只依据版本号判断稳定性。
公开文档显示,TTSE默认关闭,仅在Agent模式下挂载;启用时还会自动拉起可观测组件采集轨迹。如果agent-core缺少相关能力,Host会降级跳过。这种默认策略是合理的,因为自演进本质上会改变后续任务行为,不应该在缺乏审计的情况下自动开启。
OpenAI Hub观点:Agent竞争正在从模型能力转向经验复利
TTSE真正指向的趋势,是Agent产品开始竞争“使用一百次之后会变成什么样”。 当基础模型能力逐渐接近时,Agent能否积累组织流程、工具特性、失败模式和用户偏好,将成为实际体验的重要分水岭。
过去的Agent演示强调第一次执行有多惊艳,生产系统则更关心第十次执行是否更稳定、第一百次执行是否更便宜。一个每次都重新搜索按钮、重新试探文件格式的Agent,即使背后模型很强,也很难成为可靠的数字员工。
TTSE的价值不在于让Agent凭空产生新能力,而在于减少重复犯错。 它没有解决所有自演进问题,也无法替代更强的模型、完善的权限系统和可靠的任务评估,但它把环境事实与执行技巧分开管理,是一个符合工程直觉的方向。
更重要的是,这套机制是可验证、可追溯和可回退的。相比直接训练模型参数,显式FACT和TIP更容易被开发者查看、修改和删除,也更适合对安全与审计有要求的企业场景。
Agent从一次性工具走向长期协作者,靠的不会只是更大的上下文窗口。真正能够形成复利的,是一套知道什么值得记、什么需要怀疑、什么已经过期的经验系统。
TTSE至少让这件事从一句产品口号,变成了可以运行、可以测试,也可以被质疑的工程框架。
参考来源
- openJiuwen agent-core GitHub仓库:包含Agent开发、运行、优化和自演进相关核心实现,仓库已出现TTSE模块目录。
- WorkSwarm中文配置文档:列出TTSE开关、轨迹归纳、经验注入、Auto-dream及混合召回配置。
- WorkSwarm GitHub Releases:用于核查WorkSwarm公开版本、发布日期及版本状态。
- JiuwenSwarm自演进机制介绍:介绍Skill演进、轨迹采集、在线强化学习与自演进闭环的工程设计。
- openJiuwen GitHub组织主页:展示AgentOS各模块定位及openJiuwen整体开源项目结构。