H3-Image开源:10秒出4K
MiniMax 发布并开放 H3-Image 权重,主打约10秒直出16MP图像、统一生成与编辑,并支持最多16张参考图。真正的亮点不是“4K”,而是用6步采样把高分辨率、多图控制和可部署权重放进同一个模型。([ithome.com](https://www.ithome.com/1/025/191.htm))
MiniMax H3-Image开源:10秒直出16MP,生图模型开始拼“生产力”
MiniMax 在 11 月 10 日深夜正式发布 H3-Image,并同步开放模型权重。这是一款从 MiniMax H3 全模态架构衍生出的图像生成与编辑模型,可以在同一个检查点内完成文生图、多参考图生成和指令式图像编辑,最多接收 16 张参考图片。(ithome.com)
**MiniMax H3-Image 是一款统一图像生成与编辑能力的开放权重模型。**它不再把文生图、角色参考、风格迁移和局部修改拆成几套互不兼容的模型,而是把文字提示和参考图像编码到同一条多模态序列中,再由一个 331 亿参数的扩散 Transformer 生成目标图像。
MiniMax 给出的核心数字很激进:H3-Image 可以在约 10 秒内生成一张 4096×4096 像素的图像,像素总量约为 1678 万,官方将其归入 16MP 或“4K”规格;相比常见的 1MP 和 4MP 生图结果,像素量分别提高约 16 倍和 4 倍。MiniMax 还称,其生成速度可以达到市场主流水平的 5 倍。(ithome.com)
不过,这个“10 秒”目前更适合被理解为官方公布的最优部署指标,而不是所有用户下载权重后都能复现的固定延迟。MiniMax 尚未在模型卡中同时披露该成绩对应的 GPU 型号、并行卡数、显存配置和完整端到端计时口径,因此它能证明 H3-Image 的性能目标,但还不能直接用于计算自建服务的吞吐量和成本。
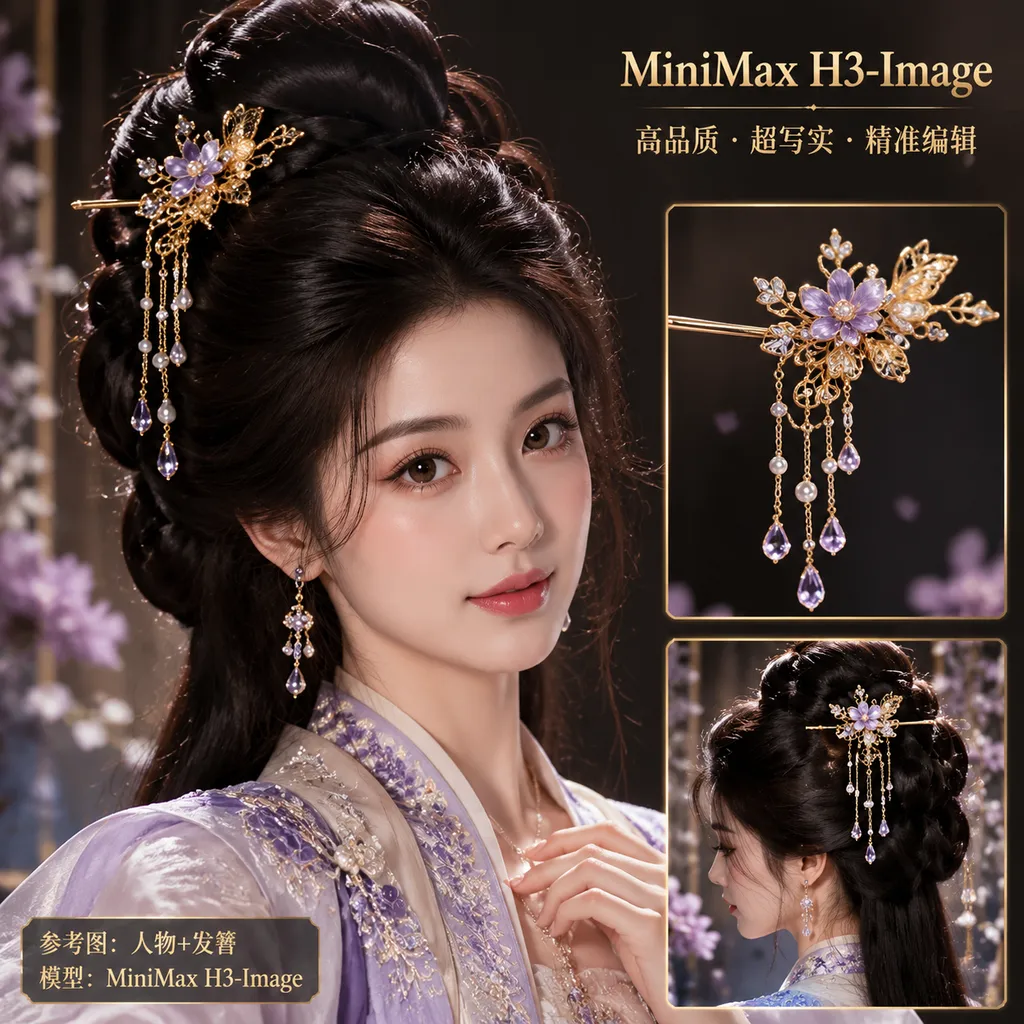
“4K”只是表面,16MP直出才是关键
**16MP 直出是指模型直接在约 1600 万像素的画布上完成生成,而不是先生成低分辨率图片再使用超分辨率工具放大。**官方模型卡列出的推荐尺寸包括 4096×4096、4736×3552、5472×3072 和 6272×2688,覆盖 1:1、4:3、16:9 和 21:9 等常见比例,实际工作区间约为 4MP 至 20MP,最佳效果集中在 16MP 左右。(huggingface.co)
严格来说,4096×4096 并不是影视行业通常所说的 3840×2160 UHD 4K,也不是 4096×2160 DCI 4K。它是一张长宽均为 4096 像素、总计 1678 万像素的方形图片,像素量接近普通 UHD 4K 画面的两倍。
这个区别对实际使用很重要。过去不少生图产品标注支持 4K,实际流程是先在 1024×1024 或 2048×2048 上完成扩散采样,再通过超分模型补充纹理。这样的结果尺寸确实变大了,但头发、服装、商品材质和远景建筑中的信息,可能只是超分模型依据邻近像素“猜”出来的。
H3-Image 的路线更直接:生成阶段就让模型处理高分辨率潜变量。它的图像 VAE 使用 16 倍空间下采样,潜变量包含 24 个通道;DiT 再以 2×2 的方式切分潜变量,因此每个 Transformer token 对应原图约 32×32 像素的区域。(huggingface.co)
这套设计的价值不是让图片在手机屏幕上看起来更“高清”,而是让生成结果有机会进入海报、电商主图、游戏概念设计、包装设计和大尺寸裁切等工作流。一张 4096×4096 图片裁掉一半后,剩余区域依然可能保留足够的输出尺寸;一张 1024×1024 图片做同样的裁切,通常很快就会暴露出纹理模糊和边缘涂抹。
6步采样,是10秒生成的技术基础
**采样步数是扩散模型从噪声逐步还原图像时执行的迭代次数。**传统高质量扩散模型经常需要 20 至 50 步,而 H3-Image 被蒸馏到固定 6 步,即 6 次 NFE,并且不使用 classifier-free guidance。模型的 num_inference_steps 只能设置为 6,guidance_scale 固定为 1,也不支持 negative prompt。(huggingface.co)
模型的核心数据可以概括为:
输入:文本提示 + 0至16张参考图片
文本编码:MiniMax H3使用的完整Qwen3-VL文本编码器
生成骨干:33.1B参数单流DiT
网络深度:50层
隐藏维度:5376
注意力头:56
采样次数:6步
推荐输出:约16MP
能力:文生图、多图参考、图像编辑
少步数模型的优势非常直接:每张图片需要执行的 Transformer 前向计算更少,高分辨率生成才有可能从“离线等几分钟”变成可交互的产品功能。
但 6 步也意味着模型没有给使用者留下太多传统扩散参数的调节空间。过去 Stable Diffusion 用户会反复调整采样器、步数、CFG 和负面提示词,H3-Image 则把这些选择收进了后训练和蒸馏过程。它更像一台参数固定、出片速度快的专业相机,而不是一套可以随意拆镜头、换传感器的实验装置。
这是一种更偏产品化的取舍。对于普通创作者,减少玄学参数是好事;对于依赖自定义采样器、ControlNet、LoRA 和底层工作流的高级用户,H3-Image 当前的可塑性仍需要社区后续验证。
16张参考图,把“生图”变成“组装场景”
**多参考图生成是指模型同时理解多张输入图片中的人物、物体、风格和空间信息,再按文字指令合成新图像。**H3-Image 最多支持 16 张参考图片,参考图上传顺序会对应提示词中的不同图片编号。官方展示的案例包括把空房间和 9 件独立家具作为 10 张参考图输入,最终将所有家具组合进同一个客厅。(huggingface.co)
这比传统的“参考某张图的风格”复杂得多。多参考图模型至少需要解决三类问题:
- **身份绑定:**知道哪张图中的脸、服装或商品应该被保留。
- **关系理解:**知道物体之间应该如何摆放,而不是简单复制粘贴。
- **冲突消解:**当不同参考图的光线、视角和比例不一致时,生成统一的画面。
H3-Image 的单流 Transformer 会把文本 token、参考图 token 和目标图像潜变量放入一条 packed sequence 中统一处理。相比先用一个模型识别参考图、再把识别结果交给另一个模型生成,这种架构更有机会保留参考图之间的细粒度关系。
在产品场景里,16 张参考图意味着用户可以同时提交人物正脸、侧脸、服装、鞋子、产品、场景、构图草图和视觉风格,让模型完成一次相对复杂的视觉合成。对于游戏美术和电商设计,这比单纯追求一张“好看但不可控”的图片更有价值。
它与FLUX、Qwen-Image有什么不同
**开放权重图像模型的竞争正在从单张图片质量转向编辑一致性、多图控制和部署效率。**H3-Image 的优势集中在高分辨率直出、6 步生成和最多 16 张参考图,但它并不意味着在所有任务上都自动超过已有模型。
| 模型 | 主要定位 | 参数或采样信息 | 多参考图 | 高分辨率策略 | 开放许可特点 | |---|---|---:|---:|---|---| | MiniMax H3-Image | 文生图与图像编辑统一模型 | 33.1B DiT、固定6步 | 最多16张 | 约16MP直接生成 | MiniMax社区许可证 | | Qwen-Image-Edit-2509 | 中文文字与多图编辑 | 官方建议约40步工作流 | 1至3张效果最佳 | 依具体推理配置 | Apache 2.0 | | FLUX.1 Kontext dev | 指令式编辑与连续修改 | 12B、常见流程约28步 | 强调人物和风格参考 | 依输入尺寸和部署配置 | 非商业开发许可证 | | Stable Diffusion 3.5 Large | 通用文生图 | MMDiT、多文本编码器 | 非核心卖点 | 常见为较低分辨率生成后扩展 | 社区许可证 |
Qwen-Image-Edit-2509 的强项是文字编辑、人物与产品一致性,并原生支持深度图、边缘图和关键点图等 ControlNet 输入;其官方模型卡表示,多图编辑在 1 至 3 张输入时效果最佳。(huggingface.co)
FLUX.1 Kontext dev 是一个 120 亿参数的图像编辑模型,优势是连续编辑过程中的视觉一致性,以及无需微调即可参考角色、物体和风格;但其开发版采用非商业许可证,在商业产品中的使用限制更明显。(huggingface.co)
H3-Image 的差异在于,它试图把多参考图、高像素和低步数同时做到一个模型里。这个组合比单项指标更值得关注:如果只有 16MP,但生成一张需要几分钟,它很难成为交互式工具;如果只有 6 步,但人物和商品在多图合成中频繁变形,它也很难进入生产流程。
开放权重不等于个人电脑随便跑
**开放权重是指开发者可以下载并自行部署模型参数,但不代表模型体积小、硬件要求低或许可证没有限制。**H3-Image 仓库中的模型主体约为 68.65GB,其中 DiT 权重约 66.28GB、VAE 约 2.34GB;它还需要额外加载 MiniMax H3 的文本编码器,大小约 66.7GB。两者合计下载量约 135.35GB,如果再部署 17.9GB 的提示词扩展模型,总体积将达到约 153.25GB。(huggingface.co)
这意味着 H3-Image 不是面向普通 8GB 或 12GB 显卡的轻量模型。官方已经给出 vLLM-Omni、SGLang、Diffusers 和 ComfyUI 等部署路线,并支持将请求通过 Ulysses 序列并行拆分到 4 张 GPU 上;但能否在消费级显卡上通过量化、CPU offload 或分层加载运行,还要等待社区方案成熟。(huggingface.co)
另一个容易被忽略的细节是,模型本体更偏好完整、详细的英文画面描述。MiniMax 在线服务会先通过 H3-Image-Context-IR 把中文或简短提示扩写为详细描述,本地部署则可以选择额外下载 H3-Image-PE 提示词扩展模型。(huggingface.co)
因此,直接下载主模型、输入一句简短中文提示,得到的结果未必与官方在线演示完全一致。对于准备做本地评测的开发者,公平的测试方式应该至少分成两组:一组使用原始短提示,一组使用官方提示词扩展模型生成的详细描述。
真正需要观察的是稳定性,而不是样片
**官方样片能够证明模型能力上限,但不能证明批量生产时的稳定性。**H3-Image 展示了写实摄影、概念设计、中英文文字、逻辑题、游戏地图转第一人称场景,以及多件家具组合等案例,这些任务覆盖面很广。(huggingface.co)
接下来更值得测试的问题包括:
- 输入 10 至 16 张参考图时,模型能否稳定保留每件物体,而不是遗漏或重复。
- 人物经过连续多轮编辑后,脸型、年龄和服装细节会不会逐渐漂移。
- 4096×4096 输出中的文字是否真正可用,还是只在精选案例中正确。
- 10 秒生成成绩在单卡、多卡和并发请求下分别对应怎样的成本。
- 在产品图、建筑图等需要严格几何关系的场景中,模型能否保持结构准确。
MiniMax 将首周 16MP 及以上规格请求的官方价格降至五折,显然是在鼓励用户集中测试高分辨率能力。(ithome.com) 但在正式价格和硬件成本都没有被放进统一比较框架前,暂时还不能仅凭“10 秒”判断它比其他方案便宜。
H3-Image的意义:国产开源生图开始抢工作流
**H3-Image 最值得肯定的地方,是它不再只围绕审美跑分和精选样片竞争,而是直接瞄准可编辑、可组合和可交付的生产流程。**16MP 直出解决的是最终交付尺寸,多参考图解决的是视觉资产控制,统一编辑模型解决的是反复修改,而 6 步采样解决的是等待时间。
它的短板同样明确:模型和文本编码器合计超过 135GB,部署门槛远高于多数个人开发者能够接受的范围;10 秒指标缺少硬件口径;“开源模型中最强指令遵循”和“速度达到主流5倍”仍属于厂商表述,尚缺少第三方盲测和统一基准支持;MiniMax 社区许可证也不是 Apache 2.0 或 MIT,企业在上线商业服务前需要逐条审阅使用范围和附加条件。
但如果 H3-Image 的多参考图稳定性能够经受社区测试,它会是一款比“又一个文生图模型”更有实际价值的产品。对于开发者而言,H3-Image 最合适的评估方式不是问它能不能生成一张漂亮图片,而是给它一整套人物、商品和场景素材,看它能否在 10 秒级等待时间内,交付一张可以继续修改、裁切和发布的 16MP 成品。
这才是 H3-Image 真正想赢下的战场。
参考来源
- MiniMax H3-Image官方模型卡与权重:模型架构、文件体积、输出尺寸、采样参数、多参考图能力和部署方式。
- IT之家:MiniMax开源H3-Image生图模型:发布时间、10秒生成指标、首周优惠和MiniMax官方能力表述。
- Qwen-Image-Edit-2509模型卡:多图编辑、文字编辑、ControlNet能力与Apache 2.0许可信息。
- FLUX.1 Kontext dev模型卡:模型参数、连续编辑能力和开发版许可证信息。
- Stable Diffusion 3.5 Large模型卡:MMDiT架构、文本编码器和社区许可证信息。