ChatGPT旧语音12月退场
OpenAI 将于 12 月 11 日停用 ChatGPT 标准与高级语音模式,全面迁移至可同时听说、并行处理复杂任务的 GPT-Live。
ChatGPT 旧版语音模式 12 月退场,OpenAI 全面押注 GPT-Live
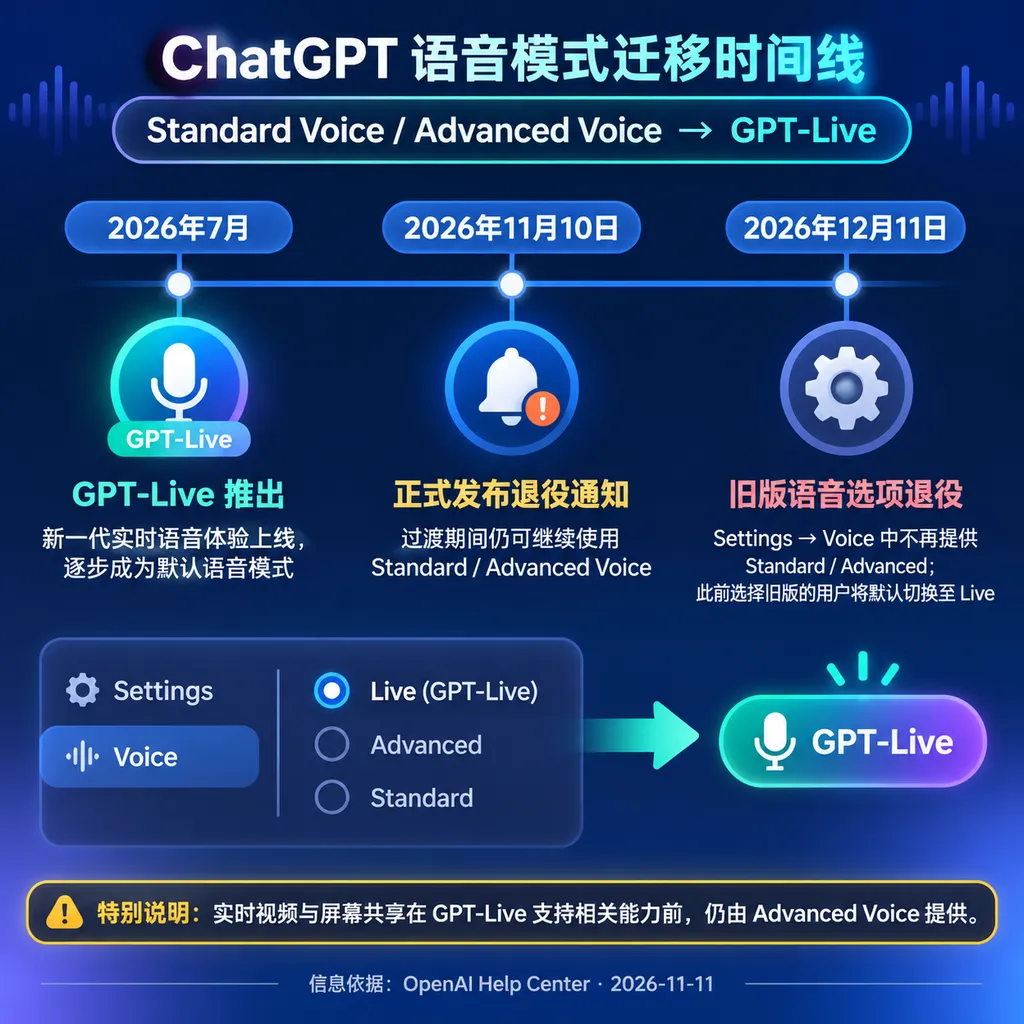
OpenAI 将于 2026 年 12 月 11 日正式停用 ChatGPT 的 Standard Voice Mode 和 Advanced Voice Mode,并把此前选择旧模式的用户自动迁移至 GPT-Live。旧语音对话不会被删除,用户仍可在历史记录中查看,并通过文字或 GPT-Live 继续对话。
这不是一次普通的模型下线,而是 ChatGPT 语音交互架构的一次彻底换代。OpenAI 正在放弃以“用户说完、模型再回答”为核心的轮流对话机制,把语音入口统一到能够同时听、同时说,并在后台并行处理任务的 GPT-Live。
OpenAI 已于 11 月 10 日开始向用户发送停用通知,旧模式还将保留一个月过渡期。12 月 11 日之后,Standard Voice 和 Advanced Voice 将从 ChatGPT 的“设置—语音”选项中移除,原有用户无需手动设置,系统会直接切换至 Live Voice。(help.openai.com)
三代语音模式,差别不只是响应速度
**Standard Voice Mode 是由语音识别、语言模型和语音合成三个环节串联而成的传统语音方案。**用户说话后,系统先把音频转换为文字,再让语言模型生成文字答案,最后由文字转语音模型把答案念出来。
这种方案像一条需要三次交接的流水线,每一步都会增加延迟,也会损失信息。语速、重音、犹豫和情绪首先被压缩成文字,语言模型看到的往往只是转录结果,而不是用户原始的声音表达。
**Advanced Voice Mode 是能够直接处理和生成音频的端到端语音模型。**它跳过了显式的“语音转文字—生成答案—文字转语音”链路,因此比 Standard Voice 更快,也更容易理解语气、停顿和情绪。
Advanced Voice 的问题在于,它依然遵守严格的轮次机制。系统通常需要通过静音判断用户是否已经说完,一旦用户停下来思考,或者环境噪声突然变小,模型就可能误以为发言结束,在不合适的时机开始回答。
**GPT-Live 是 OpenAI 面向持续语音交互设计的全双工语音模型。**全双工意味着模型可以在输出语音的同时继续接收和理解用户的声音,而不是必须等一方彻底结束后,另一方才能开口。
这一区别类似于对讲机和电话。旧版语音更像对讲机,一方按住按钮说完,另一方才能回答;GPT-Live 更像正常电话,双方可以插话、停顿、补充信息,也可以用简短的“嗯”“明白”表示自己仍在倾听。
| 对比项目 | Standard Voice | Advanced Voice | GPT-Live | |---|---|---|---| | 核心架构 | 语音识别、文本模型、语音合成串联 | 端到端音频模型 | 全双工持续交互模型 | | 是否直接处理音频 | 否 | 是 | 是 | | 是否需要等待用户说完 | 是 | 是 | 否 | | 用户能否自然插话 | 能力有限 | 支持但仍受轮次限制 | 原生支持持续插话 | | 能否边听边说 | 否 | 否 | 是 | | 复杂任务处理 | 由中间文本模型完成 | 语音模型直接回答 | 可异步委派给前沿文本模型 | | 主要问题 | 延迟高、语音信息损失 | 停顿容易被误判为结束 | 视频与屏幕共享尚未迁移 | | 12 月 11 日后状态 | 停用 | 大部分场景停用 | ChatGPT 默认语音体验 |
GPT-Live 真正重要的是“持续决策”
GPT-Live 的关键进步不是声音更像真人,而是模型能在一秒内多次判断自己应该做什么。它需要持续决定是继续听、立即回答、暂停、让出发言权、发出简短反馈,还是调用工具处理用户提出的任务。
旧语音模型面对的是一条条已经切分好的消息,GPT-Live 面对的则是一条持续流动的音频时间线。这意味着“什么时候说话”不再由独立的静音检测器决定,而成为模型理解上下文后作出的行为选择。
这种改变对真实场景很重要。用户练习外语时,可以在说错后立即自我纠正;开车问路线时,可以在 ChatGPT 回答过程中补充目的地;进行头脑风暴时,也不必等模型念完整段内容,随时可以说“停一下,换个方向”。
OpenAI 在 GPT-Live 的 API 发布资料中披露,语言学习产品 Speak 的早期评估显示,GPT-Live 给学习者留下了更多思考时间,与此前基于轮次的系统相比,错误打断减少了接近 80%。这个数字比“声音更自然”更能说明全双工架构的价值:语音 AI 开始理解对话节奏,而不只是生成质量更高的音频。(openai.com)
语音模型负责交流,文本模型负责干活
**任务委派是指 GPT-Live 在维持语音对话的同时,把搜索、深度推理或智能体任务交给后台模型处理。**语音层负责保持交流自然,后台模型负责需要更长时间和更多计算的工作,两条路径可以并行运行。
这个设计解决了语音助手长期存在的矛盾:模型如果追求快速回答,就很难完成复杂任务;模型如果先搜索、推理和调用工具,用户又要在沉默中等待十几秒甚至更久。
GPT-Live 把“陪用户说话”和“完成任务”拆成两套职责。例如,用户可以让 ChatGPT 查找一组航班,并在后台搜索期间继续补充“不要红眼航班”“最好能托运行李”。GPT-Live 不需要终止原来的任务再重新开始,而是可以把新条件持续加入上下文,在结果准备好后带回当前对话。
OpenAI 将这一架构描述为语音前端与推理后端的解耦。GPT-Live 负责倾听、回应、处理插话并决定何时委派,后台则可以连接不同的文本模型、工具或智能体系统,而不必随着语音模型一起更换。(developers.openai.com)
这也是 OpenAI 全面迁移 GPT-Live 的真正原因。旧版 Advanced Voice 虽然已经是端到端音频模型,但它仍然更接近“会说话的聊天模型”;GPT-Live 则开始成为一个实时交互层,可以站在用户和多个后台智能体之间协调任务。
使用量翻倍,让旧模式失去继续维护的理由
OpenAI 表示,自 2026 年 7 月推出 GPT-Live 以来,ChatGPT 语音功能的使用量已经接近翻倍,当前几乎所有使用 ChatGPT Voice 的用户都已转向 GPT-Live。对一家需要维持大规模实时推理基础设施的公司来说,同时维护三套语音体验已经没有太大意义。(help.openai.com)
GPT-Live 的增长也说明,用户对语音 AI 的需求正在从“把文字答案念出来”转向“持续陪我完成任务”。前者是一个音频输出功能,后者则要求模型能够处理打断、上下文变化、工具调用、视觉结果和长时间连接。
OpenAI 在 10 月还开始向 ChatGPT Voice 推送 GPT-Live-1.1 和轻量版本 GPT-Live-1.1 Quip,并增加不同语言和地区的声音选项。这意味着本次旧模式退场并不是把用户迁移到一个静止的产品,而是把研发资源集中到仍在快速迭代的统一语音平台。(help.openai.com)
视频和屏幕共享暂时仍依赖 Advanced Voice
GPT-Live 目前尚未接管 ChatGPT 的实时视频与屏幕共享功能,这两项能力仍将继续由 Advanced Voice 提供。OpenAI 没有给出它们迁移至 GPT-Live 的具体时间,只表示在 GPT-Live 具备相应能力前,Advanced Voice 会继续支撑这些场景。(help.openai.com)
这也意味着 12 月 11 日的“停用”并非从基础设施层面彻底删除 Advanced Voice。普通语音聊天入口会完成迁移,但当用户打开摄像头或共享屏幕时,底层仍可能调用旧版模型。
这一例外暴露了 GPT-Live 当前最明显的短板。全双工语音解决了时间维度上的连续交互,却还没有完全覆盖摄像头画面、屏幕内容和语音之间的实时多模态同步。对于普通聊天影响不大,但在远程指导、设备排障和视觉辅助等场景中,Advanced Voice 暂时仍不可替代。
对用户而言,升级也可能意味着重新适应
GPT-Live 的交互效率明显高于旧版模式,但“更先进”不等于每个人都会立即觉得更好。长期使用 Advanced Voice 的用户已经习惯了它的声音、回答长度和轮流发言方式,全双工模型更频繁的简短回应、主动插话和语气反馈,可能会让部分用户觉得过于积极。
全双工模型也更容易放大交互策略上的问题。如果模型对停顿判断过于敏感,它会频繁打断用户;如果判断过于保守,它又可能长时间不回应。OpenAI 可以通过训练和提示词改善整体表现,但很难找到适合所有文化、语言和使用场景的统一节奏。
GPT-Live 的另一个挑战是复杂系统带来的不确定性。一次语音回答可能同时涉及实时音频模型、后台推理模型、网页搜索、工具调用和网络传输,任何一环出现延迟,都可能破坏对话的连贯感。
OpenAI 为此重构了底层媒体链路,并开发 WARP 等协议优化,把部分 WebRTC 媒体和数据连接过程从六次网络往返压缩到一次。工程团队还通过生产环境中的影子测试观察真实会话,发现语音服务的容量不能只看 GPU 每秒处理多少请求,还要看系统能否让每一帧音频按时通过 CPU 流处理、队列和网络路径。(openai.com)
这次迁移标志着语音入口开始取代输入框
OpenAI 停用旧版语音模式的意义,不是 ChatGPT 少了两个设置选项,而是语音正在从附加功能变成核心交互界面。GPT-Live 不再只是让模型开口说话,而是在尝试把搜索、推理、工具和智能体能力放入一场不会中断的实时对话中。
对开发者而言,全双工架构会重新定义语音产品的评测标准。文字答案是否正确只是基础指标,模型会不会抢话、能否理解纠正、是否在后台真正执行了任务,以及中断后能不能恢复上下文,都将成为产品质量的一部分。
对普通用户而言,12 月 11 日之后最直观的变化可能只是设置菜单里少了两个选项。但从产品演进看,OpenAI 实际上关闭了 ChatGPT 语音的“对讲机时代”,并把未来押在一种更接近电话、又能调度后台智能体的新交互方式上。
GPT-Live 目前还不是完整答案,尤其是视频和屏幕共享尚未迁移,复杂任务的延迟与可靠性也仍需验证。但在语音 AI 这条赛道上,同时听说、持续理解和异步委派已经不再是锦上添花,而是下一代产品的入场券。
迁移时间表
- **2026 年 11 月 10 日:**OpenAI 开始向用户发送旧版语音模式停用通知。
- **2026 年 11 月 11 日至 12 月 10 日:**Standard Voice 和 Advanced Voice 仍可继续使用。
- **2026 年 12 月 11 日:**两个旧模式从“设置—语音”中移除,原用户自动切换到 GPT-Live。
- **历史记录:**旧语音对话继续保留,可通过文字或 GPT-Live 接续。
- **视频与屏幕共享:**在 GPT-Live 支持相关能力前,继续由 Advanced Voice 提供。
参考来源
- IT之家:OpenAI 宣布 12 月 11 日停用 ChatGPT 旧版语音模式——整理了停用时间、用户迁移方式及视频和屏幕共享的例外安排。