48个AI Agent找出疑似玛雅遗址
一名AI研究者调度48个Agent审阅约1200平方公里NASA激光雷达数据,72小时内锁定一处未登记的疑似玛雅遗址。但这仍是待现场验证的候选点,而非已获考古界确认的“新金字塔”。
48个AI Agent找出疑似玛雅遗址
48个AI Agent审阅了约1200平方公里的NASA激光雷达数据,在不到72小时内锁定一处未被墨西哥官方档案收录的疑似玛雅遗址。
这件事在11月10日被AI研究者Pietro Miotti公开,随后迅速登上技术社区讨论区。传播最广的标题把它概括为“Google软件工程师用48个Agent发现玛雅金字塔”,但这个说法并不严谨:Miotti的个人公开页面自称AI研究者,原始文章也没有把Google列为项目参与方,更没有说明这48个Agent由某个Google内部系统驱动。
更准确的表述是:一名非考古专业的AI研究者,用通用多模态Agent批量检查公开LiDAR影像,发现了一个值得由专业团队实地调查的候选地点。
这已经足够重要,不需要再给它套上“大厂发现失落文明”的戏剧化包装。
72小时,从旅行中的问题到政府回信
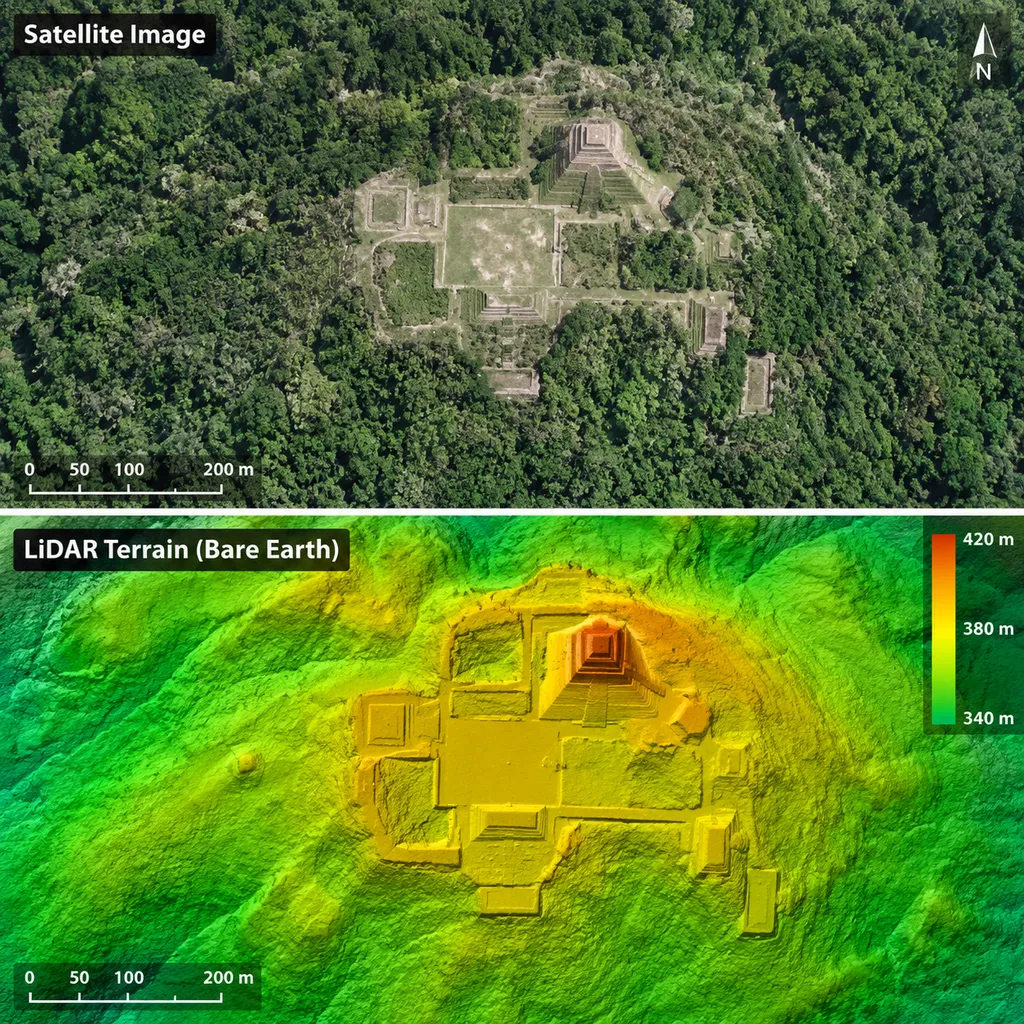
**LiDAR是通过发射激光脉冲并测量反射时间,重建地表三维高程的遥感技术。**在热带雨林里,普通卫星照片看到的主要是树冠;LiDAR的部分脉冲能穿过树叶之间的空隙,记录下方地面的高度,从而生成移除植被后的“裸地模型”。
Miotti给出的时间线从2026年10月18日开始,当时他正在秘鲁旅行,并向Gemini、ChatGPT、Claude和Grok询问:如果发现马丘比丘的探险者海勒姆·宾厄姆拥有今天的工具,他会怎么寻找古代遗址?几个模型给出了相同方向——寻找LiDAR数据。
秘鲁的公开覆盖并不理想,自行组织航空测绘又涉及成本、许可与行政程序。Miotti随后把目标转向公开LiDAR数据更丰富的玛雅文化区域,并让Agent在夜间开始处理数据。
| 时间 | Agent与人工完成的工作 | 结果 | |---|---|---| | 10月18日 | 搜索公开LiDAR数据,将数据条带转换为可供视觉模型审阅的地形图 | 获得约1200平方公里的丛林地形影像 | | 10月19日 | 48个Agent按统一指南寻找金字塔、平台、广场等规则结构 | 标记出多处可能存在人工地貌的候选点 | | 10月19日至20日 | 检索论文与档案,并检查原始点云 | 将范围收敛到一个未找到登记记录的山顶地点 | | 10月20日 | Agent协助起草报告、翻译为西班牙语,Miotti人工修改后提交 | 坐标作为保密附件发送给墨西哥国家文物机构INAH | | 10月21日 | INAH查询记录并回复 | 官方档案中没有该坐标对应的已登记考古遗址 |
从最初产生想法,到收到墨西哥国家人类学与历史研究所INAH的回复,整个过程不到72小时。Miotti在11月10日公开经历后,相关帖子在Reddit等社区获得大量讨论。(pietromiotti.com)
Agent找到的究竟是什么
**考古候选点是遥感数据中呈现出人工建造特征、但尚未经过地面调查确认的地点。**这次识别出的并不是一座从照片中清晰可见的石质神庙,而是一组藏在10至17米高森林下方的地形异常。
按照Miotti公布的LiDAR渲染图,这座山丘位于悬崖边缘,地表出现了自然地貌中不常见的直线、锐角和规则平台。进一步放大后,可以辨认出几组可能的结构:
- 一块经过平整的广场;
- 一座估计高8至12米的椭圆形金字塔状地形;
- 与其相连的抬高庭院;
- 三处可能属于住宅或附属建筑的平台;
- 一个底部较平、可能用于储存雨水的凹地。
Agent还回到原始点云检查垂直剖面,试图区分树冠反射与真实地面起伏。点云中,植被与地面回波形成不同层次,而广场、隆起结构和庭院轮廓持续存在,这降低了“渲染算法把树木误处理成建筑”的可能性。(pietromiotti.com)
但必须强调:INAH只确认该地点没有出现在其登记记录中,并没有确认那里存在玛雅金字塔。“未登记”与“新发现的古代遗址”之间,还隔着现场踏查、测绘、年代判断、材料分析,以及对自然地貌和近现代活动痕迹的排除。
Miotti本人也明确写道,这不是正式发现。目前更合适的称呼是“疑似玛雅公共建筑群”或“未登记考古候选点”。
真正的新东西不是LiDAR,而是调度方式
**多Agent系统是让多个模型实例并行执行分工任务,再由协调流程汇总、验证和筛选结果的软件架构。**这次实验有价值的地方,不是AI第一次被用于玛雅考古,也不是LiDAR第一次穿透森林,而是通用Agent把一套过去需要专业团队搭建的分析流水线压缩成了个人可以启动的任务。
LiDAR在玛雅考古中的应用已经相当成熟。2024年,研究人员重新分析一批原本用于研究森林的2013年LiDAR数据,在墨西哥南部约122平方公里范围内识别出6479处结构,并提出那里可能存在规模可观的玛雅城市Valeriana。该研究同样说明,历史数据的“第二次使用”可能比重新采集更有价值。(apnews.com)
机器学习自动识别也并不新鲜。研究团队已经使用YOLO、Mask R-CNN和其他卷积神经网络,从LiDAR衍生图像中分割平台、建筑与蓄水池。2024年的一项研究在同分布测试集上,对平台分割取得0.842的IoU、0.902的精确率和0.926的召回率;但换到地形不同的Huntichmul区域后,平台IoU下降到0.604,环形结构IoU降至0.537。(arxiv.org)
这组数字揭示了专用考古模型的核心问题:在训练区域表现很好,不代表换一片地形仍然可靠。山丘、塌陷、道路和喀斯特地貌都可能与人造结构相似,而玛雅建筑本身又经常利用自然地形,跨区域泛化并不容易。
| 方法 | 输入与准备 | 优势 | 主要限制 | |---|---|---|---| | 人工逐图判读 | 专家查看LiDAR地形图和点云 | 能结合考古背景与地形经验 | 面对大面积数据时耗时可达数周或数月 | | 专用CNN/分割模型 | 需要专家标注、训练集和模型调优 | 速度快,可输出结构边界和置信度 | 跨区域泛化下降,小型结构容易漏检或误检 | | 48个通用视觉Agent | 将LiDAR转成图片,提供明确判读指南 | 无须训练专用分类器,部署快,适合并行初筛 | 缺乏统一评测,成本和误报率未公开 | | Agent加专家复核 | Agent筛候选点,专家检查点云、档案并安排现场调查 | 兼顾规模与可信度 | 仍依赖专业人员和合法的现场验证 |
Miotti没有训练新的遥感模型。48个Agent所做的事情更接近“让48名速度不稳定、知识来源复杂但不用休息的初级分析员,按照同一份图例逐张看片”。它们寻找广场、平台、金字塔状隆起,同时排除道路、天然山丘和落水洞,随后再检索文献、准备报告和处理沟通流程。
这种方法未必比专用模型精确,却把启动门槛压得很低。用户不需要先收集数千个带标注样本,也不需要完成一次漫长训练,只需要把数据转换成模型能理解的视觉格式,再编写足够明确的检查规则。
48个Agent,不等于48位独立专家
**Agent数量是并行任务实例的规模指标,不是科学结论可信度的直接指标。**48个Agent可能只是相同或相近模型的多个会话,它们会共享相似的视觉偏差、知识盲区和推理模式。
如果所有Agent都把某种喀斯特地貌误认为平台,增加实例数量只会更快地产生相同错误。真正能提高可靠性的不是“再开48个”,而是引入不同的数据表示、不同模型、盲测流程和专业人员复核。
这次项目尚未公开几个关键数据:
- 1200平方公里数据被切分成多少张图片;
- 每个Agent审阅了多少图块,是否存在重复检查;
- 初始候选点总数和最终淘汰比例;
- 不同Agent之间的一致率;
- 推理消耗、实际费用和失败重试次数;
- 与已知遗址进行盲测时的精确率和召回率。
缺少这些数据,外界无法判断48是否是必要的并发规模,也无法复现实验的成本收益。72小时很吸引眼球,但它衡量的是“从提出问题到收到机构回信”的墙钟时间,不是模型发现遗址的准确率。
这比又一个编程Agent更值得关注
**科学Agent的价值是把公开数据转化为可验证假设,而不是直接替代科学结论。**过去两年,Agent产品主要围绕写代码、浏览网页、整理文档和操作办公软件展开,这些任务容易展示,但也越来越同质化。
遥感、气候、天文、材料和生物数据则是更大的机会。NASA等科研机构积累了数十年的观测与任务数据,其中大量数据公开可得,却分散在不同数据库、格式和研究项目中。NASA管理人员近期也提到,机构面临的难题已经不是缺少数据,而是难以找到、连接并及时理解数据;未来Agent甚至可能进入任务控制中心的后台支持流程。(news.microsoft.com)
Miotti的实验展示了一种更现实的Agent产品形态:
- Agent寻找合适的数据集;
- 工具程序完成格式转换与渲染;
- 多模态模型大规模初筛;
- 检索Agent核对论文和档案;
- 人类检查高价值候选点;
- Agent协助生成符合机构要求的报告;
- 政府或专业团队完成最终验证。
这里没有一个无所不能的“AI科学家”。真正起作用的是一条由多个普通能力拼成的工作流,而且每个阶段都有可检查的中间产物。
现在还不能叫“发现玛雅金字塔”
**截至2026年11月11日,这处地点仍未经过考古团队现场确认。**坐标没有公开,既是为了遵守文物保护要求,也是为了避免盗掘和无许可进入。墨西哥的考古遗址受联邦法律保护,任何实地工作都需要INAH授权。
下一步如果获得批准,考古人员需要确认规则地形是否由人类建造,采集陶片或其他年代材料,并判断各结构是否属于同一时期。LiDAR只能回答“地表是什么形状”,不能直接回答“谁建造、何时建造、用途是什么”。
所以,这件事最值得肯定的不是AI已经完成了一次考古发现,而是它把一次原本很难启动的调查推进到了专业机构可以接手的位置。
它也暴露了Agent时代的一个新现实:模型的能力未必已经强到可以独立做科学,但数据获取、视觉理解、文献检索、自动化处理和行政沟通一旦被串起来,一个外行提出好问题的杠杆正在迅速变大。
过去,发现异常只是工作的开始;现在,AI也能帮助完成从异常识别到报告提交之间那段繁琐但关键的路。
如果现场调查最终证明这只是一处天然山丘,这套流程仍然有意义,因为它提供了一个可以被验证和改进的失败样本。如果那里确实存在玛雅建筑群,真正的突破也不是“48个AI取代了考古学家”,而是48个Agent帮助考古学家把有限的时间,集中到最值得去的那座山上。