AlphaGenome 2直达疾病细胞
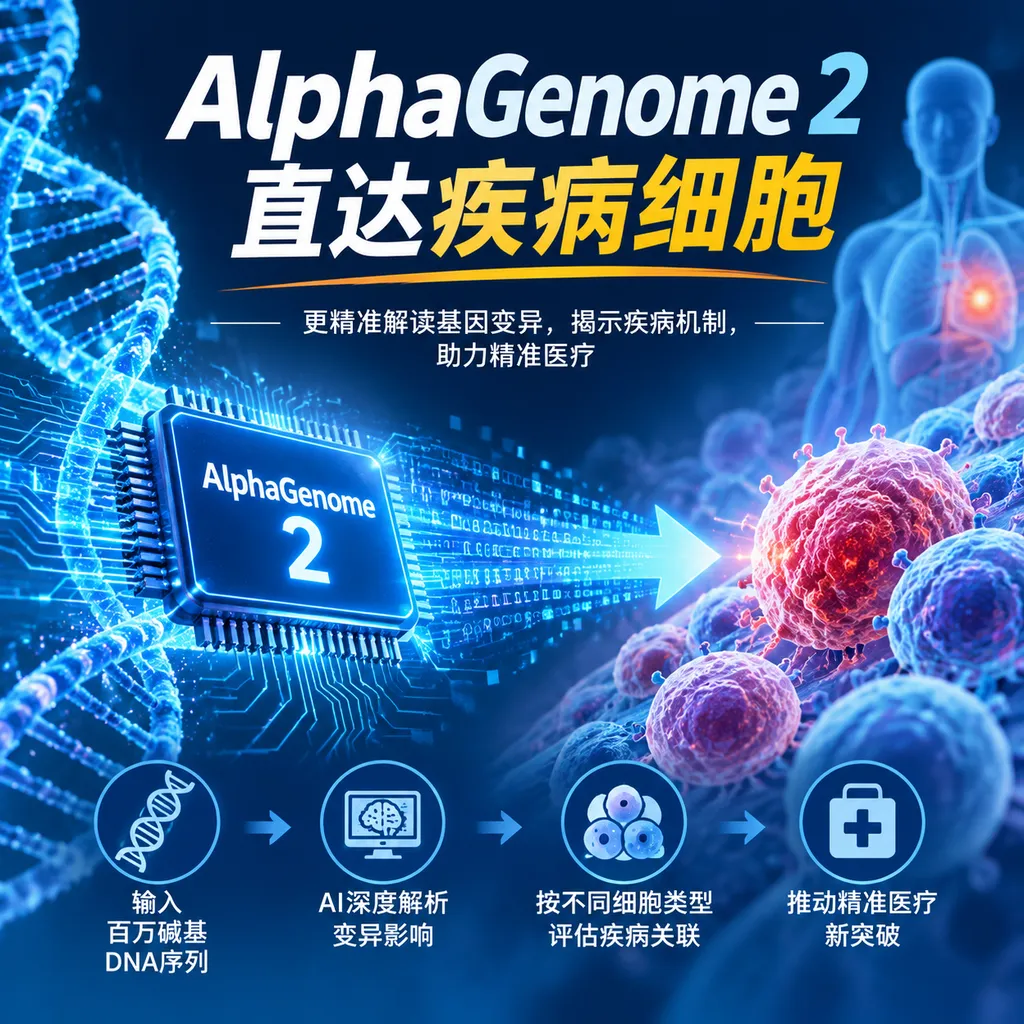
DeepMind 发布 AlphaGenome 2,将 DNA 变异预测从组织平均值细化到特定细胞类型,因果变异识别率由 16% 提升至 30%。
AlphaGenome 2直达疾病细胞
Google DeepMind 在 11 月 11 日发布 AlphaGenome 2,新模型不再只回答“这段 DNA 在肝脏或血液组织中有什么影响”,而是进一步判断“它在某一种免疫细胞、心肌细胞,甚至疾病激活状态下会造成什么变化”。这是 AlphaGenome 发布一年多以来最关键的一次架构升级,也是基因组 AI 从组织级预测走向细胞级预测的重要节点。(ithome.com)
**AlphaGenome 2 是一个面向特定细胞类型和细胞状态的 DNA 序列模型,用于预测遗传变异如何改变基因表达、染色质可及性、DNA 甲基化等分子活动。**DeepMind 称,它在单细胞测试中识别出的因果变异数量接近上一代的两倍,并且可以处理训练阶段未见过的细胞状态。
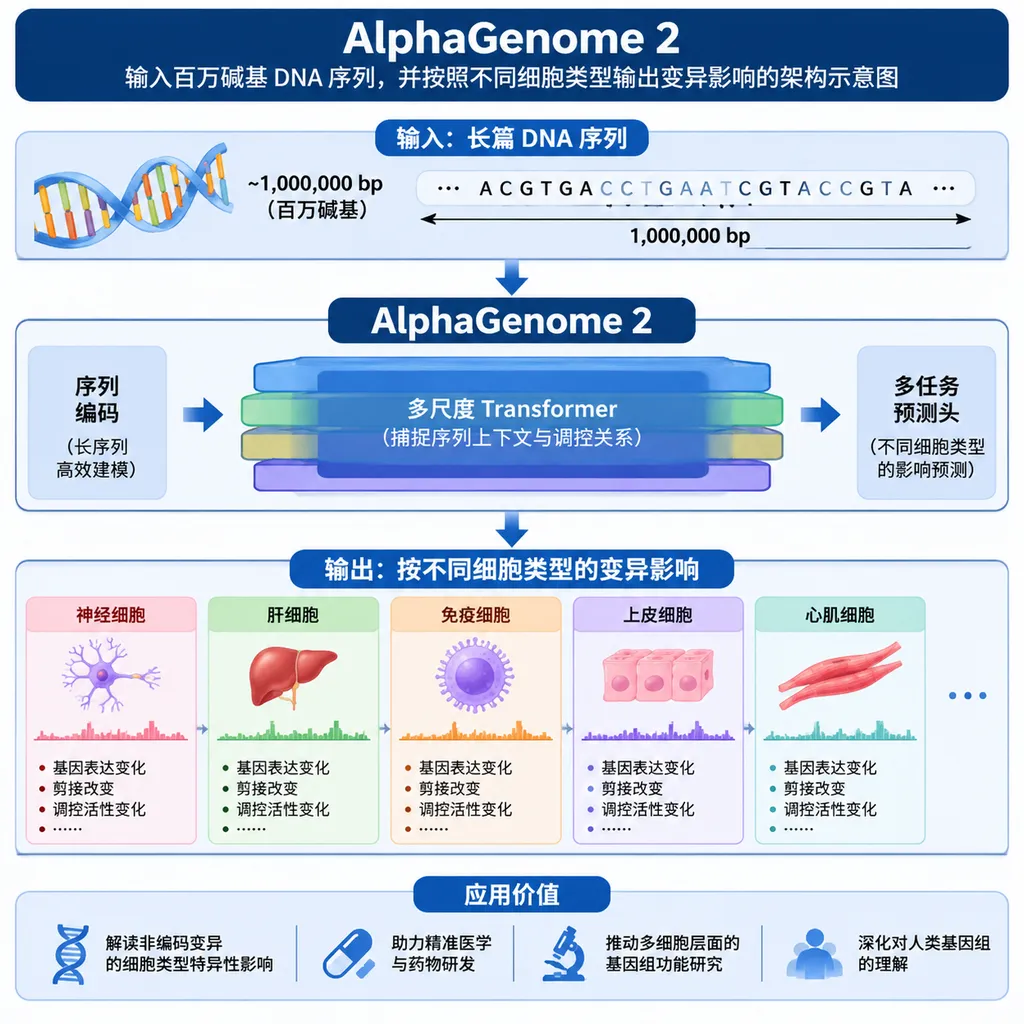
真正的升级不是“模型更大”,而是观察尺度变了
**AlphaGenome 2 的核心变化,是把预测单位从宽泛组织缩小到了具体细胞。**人体几乎所有细胞都携带相同的 DNA,但心肌细胞、神经元和免疫细胞会读取完全不同的基因片段;即便同一种免疫细胞,在静息、感染或接种疫苗后的激活状态下,读取 DNA 的方式也可能不同。
**组织平均值会掩盖疾病真正发生的细胞环境。**一份肠道组织样本可能同时包含上皮细胞、巨噬细胞、T 细胞和成纤维细胞,如果某个变异只在巨噬细胞中增强一个炎症基因,那么把所有细胞信号混在一起求平均,结果很可能看不出异常。
**初代 AlphaGenome 更像一台同时监控数千个频道的总控台。**它可以一次读取最长约 100 万个 DNA 字母,也就是约 100 万碱基对,并行预测多个组织、细胞系和实验指标。这种设计覆盖面很广,适合快速建立全局图谱,但模型容量需要分配给大量固定输出,很难分辨两个高度相似的免疫细胞亚型。
**AlphaGenome 2 则更像拿着聚光灯逐个检查目标细胞。**模型每次针对一个生物条件进行预测,这个条件可以是某种组织、细胞类型或细胞状态。目标条件并非只在模型末端作为标签出现,而是会进入架构的各个阶段,持续影响模型对 DNA 序列的解释。
| 对比项目 | AlphaGenome | AlphaGenome 2 | |---|---|---| | 主要预测尺度 | 宽泛组织与固定细胞系 | 特定细胞类型和细胞状态 | | 处理方式 | 同时并行输出大量组织和实验结果 | 每次针对一个目标条件进行预测 | | DNA 输入长度 | 最长约 100 万碱基 | 保留约 100 万碱基长序列能力 | | 条件输入 | 预先固定的组织和实验轨道 | 组织、细胞类型或细胞状态贯穿模型架构 | | 未见细胞泛化 | 能力有限 | 可通过单细胞数据生成新的条件表示 | | 预测模态 | 基因表达、剪接、染色质等 | 增加 DNA 甲基化,并支持跨模态补全 | | 非商业研究 | 通过 AlphaGenome API 提供 | 已通过 AlphaGenome API 开放 | | 商业使用 | 另行申请 | 目前处于私密预览阶段 |
1.07 亿个细胞图谱,训练的不是“细胞百科”
**AlphaGenome 2 使用了来自人类和小鼠、覆盖 68 类组织的超过 1.07 亿个单细胞图谱。**这里的重点不是让模型背下每一个细胞,而是学习细胞状态与 DNA 调控结果之间的可迁移关系。
**单细胞图谱是对单个细胞分子状态的测量集合。**过去的组织测序往往把数十万乃至数百万个细胞混合后读取,单细胞测序则可以分别记录每个细胞中哪些基因被开启、哪些调控区域处于开放状态,从而区分组织内部的不同细胞群体。
**DeepMind 为 AlphaGenome 2 加入了类似“细胞编码器”的机制。**研究人员可以输入一批新的单细胞 RNA 测序结果,模型再把这些基因活动压缩成一个细胞状态表示,用它来控制 DNA 序列模型的预测方向。这意味着模型不必为每一种新细胞重新完整训练。
**这种设计把单细胞数据从静态地图变成了查询条件。**过去,细胞图谱主要告诉研究人员“样本里有哪些细胞、它们正在表达哪些基因”;AlphaGenome 2 试图进一步回答“如果某个 DNA 位点发生变化,这些细胞的分子活动会如何改变”。
两个关键数字:30% 和 43%
**AlphaGenome 2 最直接的性能提升,来自对因果变异及其作用方向的识别。**在覆盖 28 类原代免疫细胞的 TenK10K 单细胞数据集上,新模型识别出的因果变异比例达到 30%,初代 AlphaGenome 微调版本为 16%。
**30% 对 16% 意味着识别率提高了 14 个百分点,相对增幅为 87.5%。**这不是“所有致病变异都能被找到”,而是在给定测试集和评估流程中,模型能够召回更多已经具有证据支持、会改变基因表达的变异。
**AlphaGenome 2 对基因效应方向的判断准确率达到 43%,初代模型为 23%。**所谓方向判断,是确定某个变异会让目标基因表达上升还是下降;这一指标提高 20 个百分点,相对提升约 87%。
| TenK10K 测试指标 | AlphaGenome | AlphaGenome 2 | 变化 | |---|---:|---:|---:| | 因果变异识别比例 | 16% | 30% | 增加 14 个百分点,约提升 87.5% | | 基因效应方向判断 | 23% | 43% | 增加 20 个百分点,约提升 87.0% |
**这组数字的重要性在于缩小实验候选范围,而不是替代实验。**如果研究团队面对数千个可能有关的变异,召回率接近翻倍可以显著改变后续验证顺序;但 30% 的识别比例也说明,多数复杂变异仍未被模型可靠捕捉。
它能处理没见过的细胞状态
**AlphaGenome 2 最有潜力的能力,是无需重新训练即可适应新的单细胞实验。**研究人员只需提供几十个细胞的基因活动快照,模型就能建立新的状态表示,并预测该状态下的基因调控和变异效应。
**DeepMind 用新冠 mRNA 疫苗研究展示了这种泛化能力。**模型能够区分疫苗激活后的 T 细胞和静息 T 细胞,并判断一个与重症新冠相关的遗传变异在激活状态下对基因活动的干扰更强。如果只分析未激活细胞,这一差异可能被直接忽略。
**疾病往往不是某个基因永久损坏,而是在特定时间和细胞环境下出现错误响应。**自身免疫疾病可能只在免疫细胞受到刺激后显现调控异常,癌症变异也可能依赖肿瘤微环境才发挥作用,因此“细胞状态”比传统的组织标签更接近真实病理过程。
从 GWAS 的相关性,走向具体作用机制
**全基因组关联研究是寻找遗传变异与疾病或性状统计关系的方法。**GWAS 可以告诉研究人员某段基因组区域与 2 型糖尿病、身高或炎症性肠病有关,但通常无法直接指出究竟是哪个碱基变化、影响了哪个基因、又在哪种细胞中发挥作用。
**AlphaGenome 2 试图补上 GWAS 到生物机制之间最昂贵的一段路。**模型已经针对数百种人体细胞和组织条件,预计算了一批性状相关变异的影响分数,研究人员可以先按细胞类型和调控效应筛选候选项,再决定开展哪些 CRISPR 或单细胞实验。
**增强子是能够远距离调节基因开关的非编码 DNA 区域。**许多疾病相关变异并不位于蛋白质编码基因内部,而是藏在增强子等调控区域;这些区域可能与数万甚至数十万碱基之外的基因发生联系,因此很难仅凭位置判断靶基因。
**DeepMind 展示的炎症性肠病案例说明了细胞级预测的价值。**已有研究发现,一个远端调控变异会在肠道巨噬细胞中过度激活 ETS2 基因。AlphaGenome 2 在计算预测中定位到了这一变异,并判断它主要增强巨噬细胞中的 ETS2,而不是普遍改变其他细胞和基因。
**这一能力比单纯给变异打“危险分”更接近药物研发需求。**药物团队需要知道的不只是某个变异是否相关,还要知道目标基因应该被抑制还是增强、作用发生在哪种细胞、干预该通路是否可能影响其他组织。
跨模态补全可能比跑分更实用
**AlphaGenome 2 的条件式架构还支持跨模态数据补全。**如果研究人员只有单细胞基因表达数据,模型可以进一步预测同一细胞状态下未测量的染色质可及性、组蛋白修饰或 DNA 甲基化等属性。
**跨模态补全是根据一种生物测量推断另一种测量的能力。**单细胞多组学实验成本高、流程复杂,并非每个样本都能同时获得 RNA 表达、染色质开放和甲基化数据,因此模型预测可以用于决定下一轮最值得做的实验。
**这项能力不能把低成本测序直接变成完整实验,但能优化研究预算。**它更像医学影像中的预筛查:模型先指出最可能异常的区域,实验人员再用高成本、高精度的方法确认,而不是把所有组合全部测一遍。
它还不是临床诊断模型
**AlphaGenome 2 目前仅面向研究用途,没有通过临床或诊断用途验证。**模型预测的是 DNA 变异的分子效应,不是一个人是否会患病,更不能直接给出治疗方案。
**复杂疾病并不只由 DNA 序列决定。**年龄、发育阶段、环境暴露、生活方式、感染史和不同细胞之间的相互作用,都会改变最终表型;即便模型准确预测某个变异会提高基因表达,也不能直接推导出疾病风险增加多少。
**30% 的因果变异识别比例同样提醒研究者不要高估模型。**AlphaGenome 2 比上一代明显更强,但距离覆盖全部调控机制仍然很远,尤其是稀有细胞、动态发育过程、长期疾病演化和跨组织信号等场景。
**模型使用人类和小鼠数据训练也带来了物种边界。**它对其他物种的泛化能力尚未得到同等程度的证明,研究人员不能把人类细胞上的性能直接外推到农业、生态或其他模式生物研究。
DeepMind 正在拼一套“生命科学模型栈”
**AlphaGenome 2 的意义不在于复制 AlphaFold 的成功,而在于补齐生命科学预测链条。**AlphaFold 主要解决蛋白质结构问题,AlphaMissense 判断蛋白质编码区错义变异的潜在影响,AlphaGenome 则深入占人类基因组约 98% 的非编码区域和基因调控机制。
**这套模型栈正在形成从 DNA 变异到分子功能的计算工作流。**研究人员可以先在海量变异中排序,再判断变异影响哪个调控过程、哪个细胞和哪个基因,最后结合蛋白质结构、实验数据和疾病队列继续验证。
**AlphaGenome Atlas 已经为人类基因组约 90 亿种可能的单字母变化生成预测。**AlphaGenome 2 进一步增加细胞条件后,问题从“这个变异总体上有什么影响”变成“它在什么细胞、什么状态下影响最大”。前者解决规模,后者补上上下文。
**DeepMind 接下来还计划把 AlphaGenome 2 Skills 接入 Google Antigravity 科学智能体平台。**如果这一组合能够稳定工作,研究人员未来可能用自然语言组织变异筛选、细胞条件比较和实验优先级排序,但自动生成的假设仍需要生物学证据和实验验证。
我们的判断:这是更有用的模型,不是更接近“AI 医生”的模型
**AlphaGenome 2 是一次方向正确且实用价值明确的升级。**相比扩大参数量或刷新通用跑分,它把算力集中在研究人员真正需要的变量上:细胞类型、细胞状态和变异作用方向。
**条件式架构是这次发布最值得关注的技术决定。**初代模型追求一次输出尽可能多的实验轨道,二代模型则接受单次预测范围变窄,用更聚焦的计算换取细胞分辨率,这与图像生成模型通过文本条件控制输出的思路相似,只是这里的条件变成了生物状态。
**AlphaGenome 2 短期内最现实的价值是候选排序和实验设计。**它可以帮助罕见病研究团队筛选非编码变异,帮助药物团队从 GWAS 信号追踪到细胞和靶基因,也可以帮助单细胞实验室判断下一种组学测量是否值得投入。
**AlphaGenome 2 不会让湿实验消失,反而可能让实验验证变得更重要。**模型把研究人员从百万级候选压缩到更小范围,但真正决定一个预测能否进入论文、药物项目或临床流程的,仍然是可重复的实验与人群证据。
**截至 2026 年 11 月 11 日,AlphaGenome 2 已通过 AlphaGenome API 向非商业研究开放,商业研究处于私密预览阶段。**DeepMind 尚未公布公开的商业价格、标准配额和临床部署时间表,因此现在把它视为科研基础设施,比把它包装成医疗产品更准确。
参考来源
- IT之家:谷歌 DeepMind 发布 AlphaGenome 2 基因序列模型——整理了模型架构、训练数据、评测结果、开放方式及官方研究限制。