UMAP 0.6发布:百万级降维提速
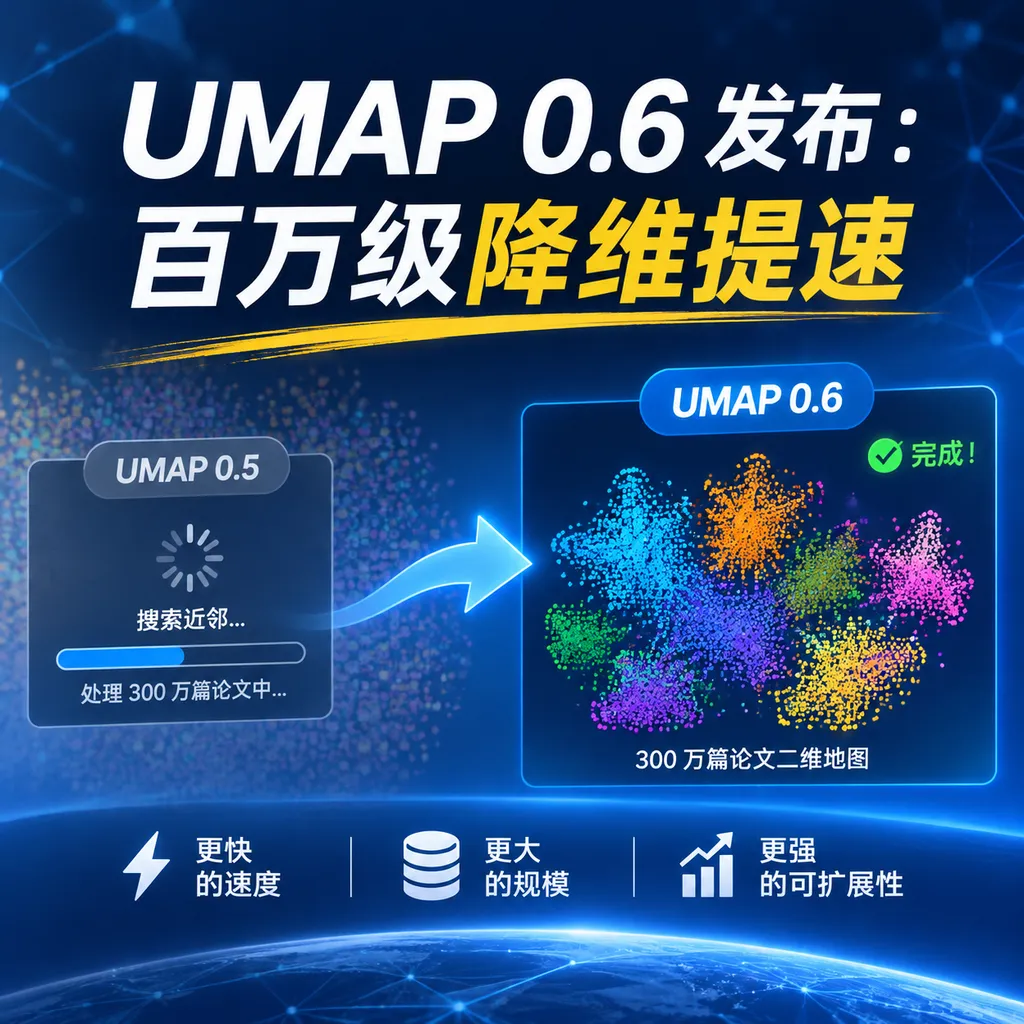
UMAP 0.6引入递归初始化、Adam与Momentum优化器,并重做近邻搜索流程。官方测试显示,300万篇arXiv论文可在5分钟内完成降维,同时解决固定随机种子导致的单线程瓶颈。
UMAP 0.6发布:300万数据点,5分钟内完成降维
UMAP 0.6于11月12日正式发布,这次更新没有增加一个花哨的可视化选项,而是重写了决定大规模降维效率的三段核心流程:最近邻搜索、嵌入初始化和布局优化。
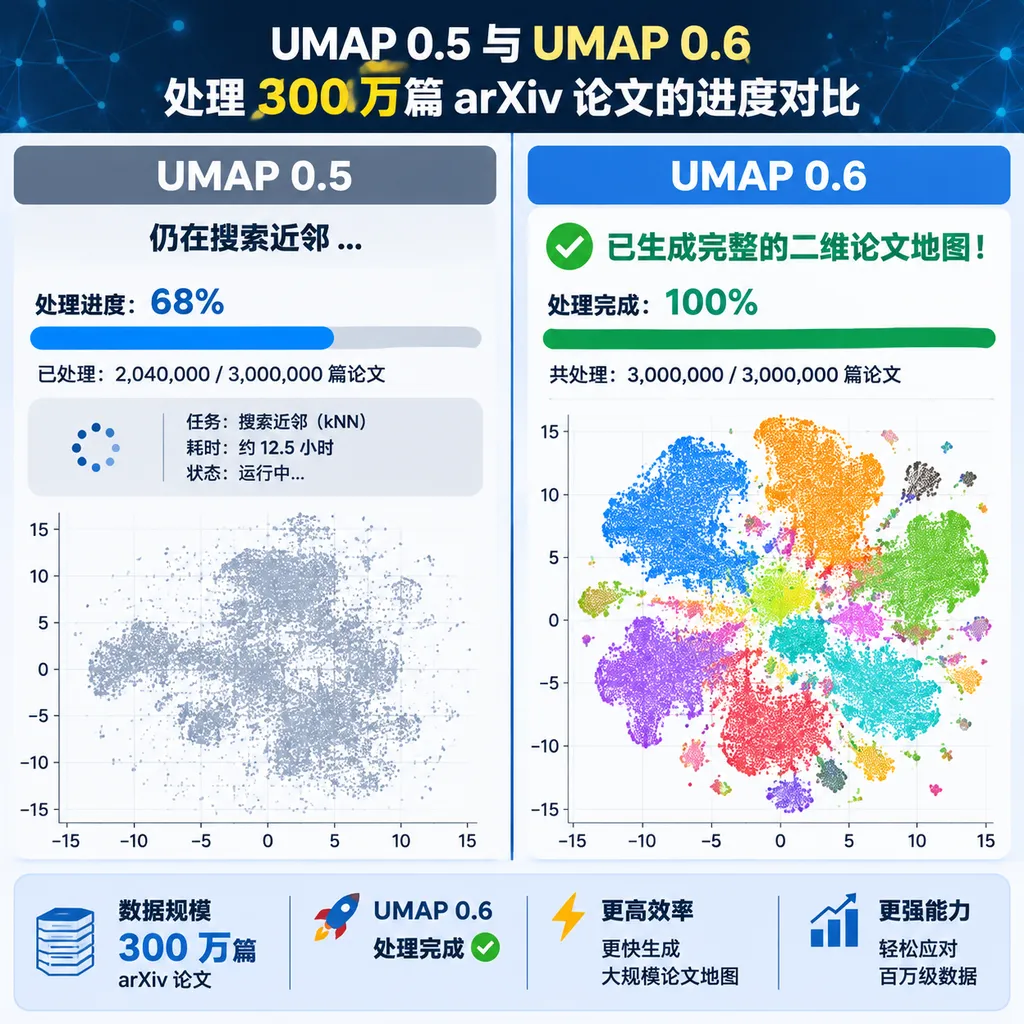
项目维护者Leland McInnes公布的测试结果显示,在包含约300万篇arXiv论文的数据集上,UMAP 0.6能够在5分钟内完成整个降维任务;同一时间,UMAP 0.5甚至还没有完成最近邻搜索。固定随机种子后,旧版完整运行需要52分钟,新流水线快约12倍。(reddit.com)
这不是一次普通的性能更新。UMAP 0.6真正解决的是一个长期矛盾:开发者过去必须在运行速度、结果可复现和大规模嵌入质量之间做选择,而新版本第一次尝试让三者同时成立。
UMAP为什么需要重做
UMAP是一种非线性降维算法,用于把数百乃至数千维的向量压缩到二维或三维,同时尽量保留数据点之间的局部邻域和整体拓扑关系。
在AI应用里,UMAP早已不只是论文里的可视化工具。开发者会用它观察Embedding模型是否把不同主题分开、检查RAG知识库的向量分布、分析图像特征、寻找异常样本,也会把UMAP生成的低维表示交给HDBSCAN等聚类算法。
问题在于,现代AI数据集的规模已经变了。几年前,7万张MNIST图片算标准测试集;现在,一个中型知识库就可能包含数百万条文本向量,单条向量还有768、1024甚至数千个维度。旧版UMAP虽然比t-SNE更容易扩展,但到了百万级数据,最近邻图构建、谱初始化和布局优化仍会依次成为瓶颈。
UMAP的完整工作可以粗略拆成三步:先寻找每个数据点的近邻,再把近邻关系转换成加权模糊图,最后把这张图铺到二维或三维空间。UMAP 0.6的策略很直接——三步一起改,而不是只优化最后一段循环。
性能提升有多大
UMAP 0.6的性能提升来自完整流水线的协同优化,因此不能简单理解为某个计算内核快了12倍。
| 测试场景 | UMAP 0.5兼容流水线 | UMAP 0.6新流水线 | 变化 | |---|---:|---:|---:| | 300万篇arXiv论文完整降维 | 5分钟时仍未完成近邻搜索 | 5分钟内完成 | 跨越百万级使用门槛 | | 最近邻搜索 | 基准速度 | 约快4倍 | 更充分利用PyNNDescent | | 固定随机种子的300万规模运行 | 52分钟 | 不到5分钟 | 约12倍加速 | | 7万条MNIST完整拟合 | 41.9秒 | 5.63秒 | 约7.4倍加速 | | 固定随机种子后的布局优化 | 主要退回单线程 | 保持多核并行 | 可复现不再等于慢 |
其中MNIST结果来自项目文档中的预热测试:兼容模式使用谱初始化和旧优化器,耗时41.9秒;递归初始化配合Adam优化器耗时5.63秒。文档也明确提醒,这比较的是两套完整配置,不能把7.4倍差距全部归功于Adam。(github.com)
换句话说,UMAP 0.6不是给旧引擎换了一个更快的零件,而是重新安排了整条生产线。
递归初始化:先画缩略图,再逐层放大
递归初始化是一种先压缩图结构、在小图上生成布局,再逐层展开到原始数据规模的初始化方法。
旧版UMAP通常使用谱初始化。谱初始化会通过图拉普拉斯矩阵的特征向量为数据点寻找初始坐标,在中小型数据集上效果不错,但图变得非常大时,特征分解本身就可能昂贵且不稳定。随机初始化虽然便宜,却会让后面的优化器从一团噪声开始工作,需要更多迭代才能整理出簇结构。
UMAP 0.6的init="recursive"走了另一条路:它反复粗化模糊图,把相似节点合并成更小的图;等图缩小到容易处理的规模后先完成布局,再把结果扩展到上一层,逐级恢复到全部数据点。
这个过程有点像绘制一张全国地图。旧方法接近于一开始就在空白画布上摆放每条街道,新方法则先确定省份和城市的位置,再补充城区、道路和建筑。后者不仅更快,也更不容易在早期把两个本应分开的区域挤在一起。
官方称,递归初始化生成的起点可以在更少的优化轮次内接近最终布局,误差能够快速收敛到最终结果的3%以内。recursive_coarsening_ratio参数可以设为2、3或4,其中4的粗化速度最快,较小的数值则会使用更多中间层,换取更渐进的展开过程。(reddit.com)
对普通用户而言,这些高级参数不一定需要手动调整。递归初始化最大的价值不是多了几个旋钮,而是让百万级数据获得了一个足够好的起跑位置。
新优化器:固定随机种子也能吃满CPU
可复现并行优化是指算法在使用多个CPU核心的同时,仍能在相同数据、参数和随机种子下输出完全一致的结果。
这件事听起来理所当然,旧版UMAP却很难做到。旧优化器会立即把每次计算得到的吸引力或排斥力写回坐标;多个线程同时更新同一个嵌入时,写入顺序取决于线程竞争。顺序稍有变化,最终坐标就可能不同。
因此,UMAP 0.5在设置random_state后,为了保证结果可复现,通常需要把布局优化限制在单线程。官方300万论文测试中的52分钟耗时,很大一部分就是这个机制带来的代价。
UMAP 0.6新增了optimizer="adam"和optimizer="momentum",原有优化器则以optimizer="compatibility"保留。Adam会累计梯度方向及其尺度,再为不同坐标自适应调整更新步长;Momentum则保留部分上一次更新方向,让优化轨迹更平滑。
新优化器不会让多个线程随时抢着修改坐标,而是先累计作用力,再按照稳定顺序应用更新。项目文档中的验证显示,相同数据和random_state=42条件下,Adam两次生成的数组可以通过np.array_equal精确比较,同时仍使用配置好的Numba线程,单次墙钟时间约5.7秒。(github.com)
这项改动对生产环境比单纯跑分快更重要。需要版本化向量地图、回归测试聚类结果或审计模型数据分布的团队,以前经常被迫在可复现和多核性能之间二选一;UMAP 0.6基本消除了这个选择题。
硬负样本挖掘改善了大图的细节
硬负样本挖掘是一种优先选择当前低维空间中距离较近、但原始近邻图中并不相邻的数据点作为负样本的训练策略。
UMAP的布局优化依靠两种力量:相连节点互相吸引,不相连节点互相排斥。数据量较小时,随机挑选负样本通常够用;数据量达到数百万后,绝大多数随机负样本距离很远,对当前布局几乎没有信息量。
例如,在一张论文向量地图里,随机负样本可能让一篇强化学习论文与一篇蛋白质结构论文互相排斥,但它们本来就相隔很远。真正困难的是区分两篇主题相近、嵌入位置接近,却属于不同研究分支的论文。
UMAP 0.6会在当前嵌入的局部窗口里挑选更难区分的负样本,让有限的优化步骤集中处理簇边界和细粒度结构。默认的negative_selection_range为200000;当数据集超过这个范围时,优化器可以在当前布局排序的局部窗口中选择负样本。(github.com)
新版本还提供exclude_graph_neighbors,避免把原始近邻图中已经相连的节点误当成负样本。这个细节很关键,否则同一对节点可能同时受到吸引和排斥,优化器相当于一边踩油门一边刹车。
项目维护者认为,硬负样本机制是新版在百万级数据上获得更高邻域准确率和更清晰簇结构的主要原因之一。它让UMAP 0.6不仅更快,而且能用更少的优化轮次解析出旧版容易糊在一起的细粒度区域。(reddit.com)
这是一个过渡版本,不是无感升级
UMAP 0.6默认仍保留0.5系列的兼容行为,新流水线目前需要主动启用。
开发者升级依赖后,如果只运行原来的代码,不一定会立即获得递归初始化和Adam优化器的全部性能。官方建议评估新流水线时设置compatibility_layout=False;未来版本才会把递归初始化与Adam组合切换为默认方案。(github.com)
安装或升级命令保持不变:
pip install -U umap-learn
兼容模式保留是正确决定。UMAP的输出没有唯一正确坐标,同一份数据经过旋转、镜像或簇位置调整后,结构质量可能完全相同,但下游系统未必把它们视为相同结果。依赖固定坐标阈值、已有可视化标注或序列化模型的项目,不应该直接切换流水线后假设输出完全兼容。
UMAP 0.6能够在相同平台和依赖版本下复现0.5.x兼容路径的嵌入与transform结果,旧版保存的模型也仍能加载。开发者更稳妥的迁移方式,是先在代表性数据集上并行运行两套配置,再比较邻域召回、聚类稳定性、运行时间与内存占用,而不是只看二维散点图是否更漂亮。
它不会取代GPU,但会让CPU方案更能打
UMAP 0.6的核心意义不是打败GPU实现,而是显著推迟开发者必须迁移到GPU的时间点。
| 方案 | 更适合的场景 | 主要优势 | 主要限制 | |---|---|---|---| | UMAP 0.5兼容模式 | 需要保持历史输出的现有项目 | 行为稳定、迁移风险低 | 固定种子时并行能力弱,大规模速度慢 | | UMAP 0.6新流水线 | 百万级CPU降维、可复现实验、Embedding分析 | 多核可复现、初始化更快、细节更清晰 | 当前需要主动启用,输出布局会变化 | | GPU版UMAP | 已有GPU集群、需要反复处理超大数据 | 高吞吐,适合批量实验 | 依赖GPU显存、驱动和额外部署环境 | | t-SNE | 中小规模数据的局部结构展示 | 视觉簇边界通常鲜明 | 大规模扩展、全局结构和运行成本通常更弱 |
对于已经有RAPIDS环境的团队,GPU仍然是追求极限吞吐的合理选择;但对运行在普通工作站、CPU服务器或CI任务中的Embedding分析,UMAP 0.6把性能提升到了足以改变架构决策的程度。
特别是300万条记录在5分钟内完成这一结果,意味着许多过去只能夜间离线运行的可视化和质量检查,现在有机会进入交互式分析流程。开发者可以更频繁地比较不同Embedding模型、切分策略或语料版本,而不是每改一次配置就等待近一小时。
OpenAI Hub的判断
UMAP 0.6是一次偏底层、但实际影响很大的升级,其价值远高于新增几个参数。
递归初始化解决了大图从哪里开始画的问题,Adam与Momentum解决了怎样稳定并行地画,硬负样本挖掘则解决了百万级地图如何保留细节。这三项改动对应的是同一条链路中的不同瓶颈,因此最终效果不是简单相加,而是让CPU版UMAP跨过了一个规模门槛。
不过,官方公布的300万论文和MNIST数据仍属于项目方基准测试,机器配置、向量维度、距离度量和参数都会影响实际耗时。团队不应直接把“5分钟”写进容量规划,而应该在自己的稀疏度、维度和数据分布上重新测试。
更值得关注的指标也不只是总耗时。对Embedding和RAG系统来说,邻域召回率、簇稳定性、异常点分布和多次运行的一致性往往比二维图的观感更重要。UMAP 0.6最有价值的进步,恰恰是把性能、细节质量和可复现性放进了同一套设计中。
如果后续版本按计划将新流水线设为默认,UMAP 0.6会成为一次类似“换发动机但暂时保留旧驾驶模式”的过渡。现在适合开始测试,但对依赖历史坐标的生产项目,还不到闭眼切换的时候。
参考来源
- UMAP 0.6发布说明与300万篇arXiv论文测试:项目维护者介绍性能、初始化、优化器和大规模嵌入质量变化。
- UMAP GitHub项目主页:源代码、安装方式、依赖要求与项目概览。
- UMAP优化器技术文档:Adam、Momentum、兼容优化器、并行可复现性和负样本机制说明。
- UMAP参数文档:递归初始化、粗化比例与新流水线参数说明。