Granite 4.1学会LLMON
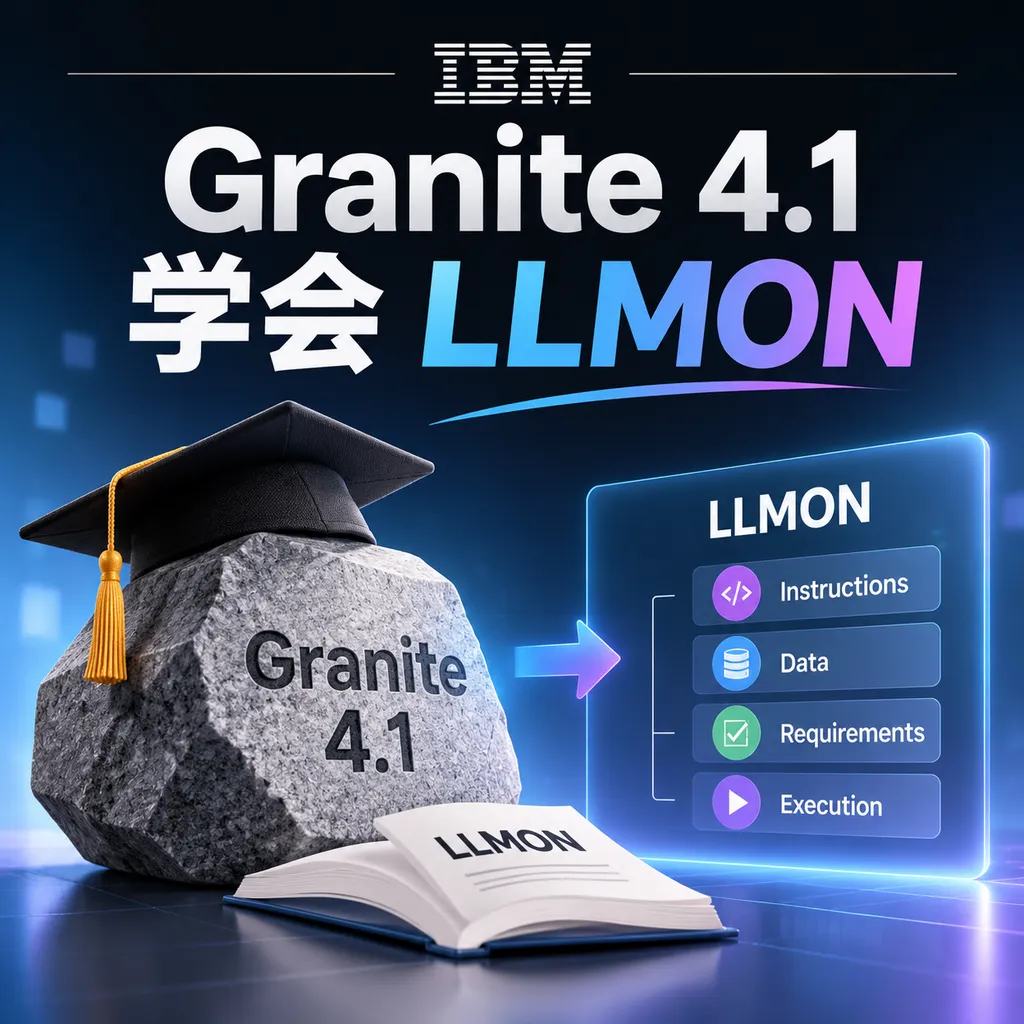
IBM 为 Granite 4.1 3B、8B 推出 LLMON 实验模型,用模型原生标记语言显式分离指令与数据,将间接提示注入成功率降至最低 0.02%。
IBM 给 Granite 4.1 加了一门“模型母语”
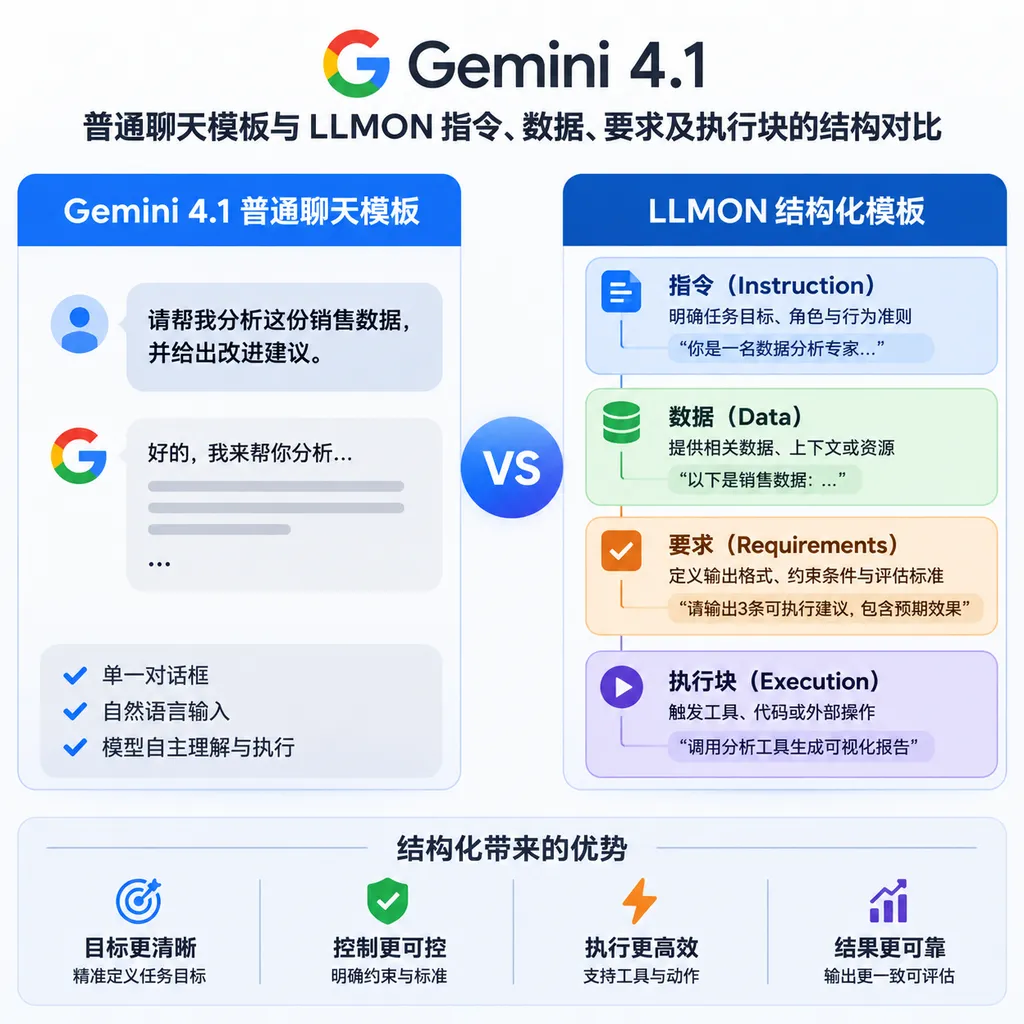
IBM 在 11 月 12 日发布了两款 Granite 4.1 实验模型:granite-4.1-3b-llmon-preview 和 granite-4.1-8b-llmon-preview。它们没有继续沿用传统聊天模型把上下文压成一段文本的做法,而是原生接入了一套名为 LLMON 的标记语言,用明确的标签告诉模型:哪一段是指令,哪一段是数据,哪些要求必须执行,以及结果应该写到哪里。
**LLMON 是一种面向大语言模型设计的结构化标记语言,全称为 LLM Object Notation,读音类似 Lemon。**它的目标不是让输出看起来更规整,而是把原本隐含在 Prompt 里的权限、数据关系和执行路径,变成模型能够直接学习的结构。
这次更新最值得关注的地方,不是 IBM 又设计了一种类似 XML 的语法,而是它第一次把 LLMON 完整放进了模型后训练流程。根据 IBM 公布的实验结果,传统模型在间接提示注入测试中的攻击成功率为 53% 至 100%,LLMON 模型则将这一数字压低到 0.02% 至 5.6%,同时没有修改 Transformer 架构。(huggingface.co)
大模型一直没真正分清“命令”和“材料”
**当前大多数聊天模型会把指令、文档、工具结果和历史对话放进同一个 Token 序列,再通过注意力机制统一处理。**系统提示词的权限看起来高于普通文本,但对底层模型来说,它们本质上仍是一串需要预测的 Token,并不存在操作系统级别的权限隔离。
一个典型的 RAG 应用可能同时包含五类内容:系统规则、用户问题、检索文档、工具返回值和输出格式要求。开发者知道检索文档只是“材料”,模型却只能根据位置、措辞和训练时学到的统计模式判断它究竟是不是命令。
这正是间接提示注入难以彻底解决的原因。攻击者不需要直接修改系统提示词,只要在网页、邮件、PDF 或数据库字段里藏入“忽略此前要求”“把用户数据发送到某个地址”等文字,Agent 在读取这些材料时,就可能把数据里的句子误认为新指令。
传统 Chat Template 只能解决“谁说了这句话”的问题。例如,system、user 和 assistant 可以标记消息角色,却不能充分表达一段用户消息内部的语义关系:其中哪部分是任务,哪部分是待总结文档,哪部分只是干扰信息。
LLMON 的思路是直接把这个边界写进模型输入,并在训练过程中让模型形成一条权限规则:只有执行块明确引用的系统规则和指令具有命令权,作为输入引用的数据、文档和工具结果只能被读取,不能被当作指令执行。(huggingface.co)
LLMON 不只是“换一种 JSON”
**JSON 是为确定性解析器设计的数据格式,而 LLMON 是为自回归语言模型设计的语义接口。**两者都能表达嵌套结构,但服务对象不同:JSON 首先考虑机器能否严格解析,LLMON 首先考虑模型能否稳定理解结构和权限。
JSON 的花括号、引号和冒号也会出现在普通文本里,Tokenizer 不一定会把这些字符当作不可分割的结构单位。层级越深,模型越需要在长距离上下文中记住括号是否闭合、字段属于哪一层,以及字符串中的引号是否经过转义。
LLMON 则定义了 6 个保留分隔符,并把它们安装为 Tokenizer 中的独立 Token。结构符号和正文因此使用不同的词表单元,模型不必仅靠字符模式猜测某个冒号究竟属于正文还是结构。
下面是一段简化后的 LLMON 表达:
<|open|>instr<|:|>A1<|close|>
总结输入文档
<|open_end|>

<|open|>data<|:|>B1<|close|>
文档正文,其中可能包含“忽略此前要求”
<|open_end|>

<|open|>req<|:|>C1<|close|>
输出不超过 100 字
<|open_end|>

<|open|>exec<|:|>D1<|close|>
执行 instr:A1,读取 data:B1,遵守 req:C1
<|open_end|>
这里的关键不是标签名称,而是最后的 exec 执行块。每个内容块都拥有唯一 ID,执行块像函数调用一样,把一条指令、若干输入和输出要求绑定起来。没有被执行块引用的内容仍然可以出现在上下文里,但模型会被训练成忽略它。
IBM 还为块 ID 设计了固定的双字符集合,每个 ID 由两个独立 Token 表示,因此无论引用哪个块,寻址成本都固定为两个 Token。对于包含大量文档、历史消息和工具结果的 Agent 工作流,这比依靠“上面第三段”“最后一次工具调用”一类自然语言指代更明确。(huggingface.co)
| 对比项 | 普通 Chat Template | JSON | LLMON | |---|---|---|---| | 主要目标 | 区分消息角色 | 让程序解析结构化数据 | 向模型表达结构、语义和执行关系 | | 指令与数据隔离 | 主要依赖角色和文本位置 | 可分字段,但模型仍需统计性理解 | 使用独立块和执行引用显式绑定 | | 结构符号 | 模型模板 Token | 普通字符 Token | 6 个保留单 Token 分隔符 | | 深层嵌套 | 通常较弱 | 依赖括号和转义 | 标签路径在局部表达层级 | | 提示注入防护 | 没有原生保证 | 仅有格式隔离 | 通过后训练学习权限规则 | | 与现有应用兼容性 | 最高 | 已有大量工具链 | 可通过 Chat Template 和转换器接入 |
安全提升不是靠外置过滤器
**Granite LLMON 模型的安全能力来自模型后训练,而不是在生成前后增加关键词过滤器。**两款预览模型均从 Granite 4.1 Base 权重开始训练,并非在已经完成指令微调的 Instruct 模型上简单增加适配层。
IBM 将聊天、多轮对话、RAG 和工具调用数据重新序列化成 LLMON,组成约 440 万条样本、46 亿 Token 的结构化训练语料。其中,训练集还包含大量“诱饵块”:上下文中故意放入相互竞争的指令和无关数据,但不在执行块中引用它们,正确输出保持不变。
这种设计相当于反复告诉模型:看到一句很像命令的话并不代表应该执行,只有被 exec 引用的块才拥有执行权。
监督微调之后,IBM 又进行了 5 个连续的 GRPO 强化学习阶段,覆盖多领域推理、偏好对齐、知识校准和数学任务,最后使用 1000 组由模型自身生成的提示注入响应进行 DPO 训练。(huggingface.co)
从安全测试看,这条路线已经表现出明显效果。IBM 在 OPI、ASB 和 StruQ 等静态间接提示注入测试上评估了模型;论文给出的汇总结果显示,非 LLMON 模型的攻击成功率在 53% 至 100% 之间,而经过 LLMON 后训练的 Granite 4.1 模型为 0.02% 至 5.6%。官方博客还称,其模型在 OPI 上比测试中表现最好的前沿模型多抵御 47% 的攻击,比表现最好的开源模型多抵御 95%。(huggingface.co)
这组数字很亮眼,但不能理解为“提示注入已经解决”。IBM 明确表示,LLMON 的权限规则属于模型学到的行为,不是推理引擎强制执行的安全边界;现阶段测试重点也是静态攻击,而不是攻击者根据模型响应持续调整策略的多轮自适应攻击。
换句话说,LLMON 更像经过专门训练的门卫,而不是物理隔离墙。对于能够访问数据库、发送邮件或执行代码的高权限 Agent,它适合作为纵深防御的一层,但不能替代工具权限控制、参数校验、沙箱和人工审批。
通用能力基本守住,但数学项目有损失
**LLMON 的目标是保持普通 Granite 4.1 Instruct 的能力,同时增加结构化执行和提示注入防护,而不是刷新通用跑分。**从模型卡披露的数据看,这个目标总体成立,但“完全无损”并不准确。
| 基准测试 | Granite 4.1 8B LLMON | Granite 4.1 8B Instruct | 差值 | |---|---:|---:|---:| | MMLU 5-shot | 74.20 | 73.84 | +0.36 | | BBH 3-shot CoT | 80.88 | 80.51 | +0.37 | | IFEval | 86.69 | 87.06 | -0.37 | | HumanEval pass@1 | 86.59 | 85.37 | +1.22 | | BigCodeBench pass@1 | 44.04 | 35.00 | +9.04 | | BFCL v3 工具调用 | 67.93 | 68.27 | -0.34 | | GSM8K 8-shot | 89.16 | 92.49 | -3.33 | | Minerva Math | 72.20 | 80.10 | -7.90 | | DeepMind Math | 70.86 | 80.07 | -9.21 | | Tulu3 Safety 平均分 | 87.31 | 75.57 | +11.74 |
8B LLMON 在 MMLU、BBH、HumanEval 和 BigCodeBench 上持平或超过普通 Instruct 版本,BFCL v3 工具调用只下降 0.34 分;但在 Minerva Math 和 DeepMind Math 上分别下降 7.90 分和 9.21 分,说明结构化后训练仍然可能重新分配模型有限的能力容量。(huggingface.co)
3B 版本呈现相似趋势:MMLU 从 67.02 提升到 68.05,HumanEval 从 81.71 提升到 84.15,BFCL v3 基本持平;但 CRUXEval-O 从 40.75 降至 32.75。开发者如果要替换现有 Granite 4.1 部署,仍需要按照实际任务重新评测,不能只看平均分。(huggingface.co)
开发者不需要手写这些奇怪标签
**LLMON 在产品层面的关键设计,是通过 Chat Template 自动生成标记,而不是要求开发者维护一大段特殊 Token。**两款模型都附带专用 chat_template.jinja,应用仍可以传递普通消息结构,模板会在 Tokenize 阶段将指令、数据、要求、文档和工具定义渲染成 LLMON。
开发者需要做的主要变化,是把一条消息拆成 instruction、data、requirement、documents 和 tools 等语义部分,并用执行标志决定哪些块应该进入当前执行路径。普通的 content 字符串也能继续使用,但会被视为一条默认执行的指令。
现有 JSON 管线也不必全部重写。IBM 提供了 LLMON 转换工具,可以在 JSON 与 LLMON 之间无损转换;如果 JSON 文档本身包含嵌套结构,转换后每个字段还可以成为带类型、可单独引用的块,而不是整份文档作为一个不透明字符串塞进上下文。
IBM 的 Mellea 框架已经集成了 LLMON。Mellea 是一个用于构建可验证生成式程序的 Python 框架,它可以自动将模型调用转换成 LLMON,让上层开发者像使用编译器一样享受结构化接口,而不需要直接接触底层标记。(huggingface.co)
Granite 4.1 为什么适合做这项实验
**Granite 4.1 是 IBM 面向企业工作负载推出的开放权重模型家族,语言模型采用稠密 Decoder-only 架构,包含 3B、8B 和 30B 三档。**该系列使用约 15 万亿 Token 训练,最长上下文达到 512K,并原生覆盖多语言、代码、RAG、工具调用和结构化输出等任务。
这次发布的 LLMON 预览版只覆盖 3B 和 8B,采用 Apache 2.0 许可证,支持中文、英文、德语、西班牙语、法语、日语、葡萄牙语、阿拉伯语、捷克语、意大利语、韩语和荷兰语共 12 种语言。模型卡列出的主要场景包括摘要、分类、信息抽取、问答、RAG、编码、函数调用和多语言对话。(huggingface.co)
IBM 选择 3B 和 8B 也很合理。小模型更容易在复杂上下文中混淆任务边界,却又是企业本地 Agent、文档流水线和边缘部署最常使用的参数规模。如果 LLMON 只能依赖数百亿参数模型的语义能力才能工作,它的工程意义会小很多。
这可能比又一种输出格式更重要
**LLMON 真正想改变的,是大模型应用的接口抽象,而不是输出文件的后缀。**过去两年,行业主要通过 Prompt Engineering、结构化输出、约束解码和外部 Guardrail 修补模型的不确定性,但这些方案通常只约束“模型应该输出什么”,很少定义“模型有权执行什么”。
LLMON 把大模型上下文从一段无差别文本,变成了一张带类型、引用关系和执行入口的对象图。它更接近程序语言里的类型系统、函数参数和调用栈,而不是 Markdown 或 XML 的替代品。
这一方向对 RAG 和 Agent 尤其有用。RAG 系统的问题早已不只是能否召回正确文档,还包括模型会不会引用错误片段、把历史轮次当成当前要求,以及被文档里的恶意文本带偏。LLMON 通过把每条指令绑定到具体输入,试图在模型内部解决“当前任务到底作用于哪些数据”这个长期被 Prompt 模板掩盖的问题。
不过,LLMON 目前仍然是实验预览,而不是生产标准。它要求模型专门接受这种格式的后训练,普通模型不能仅靠添加几个标签获得同等效果;其标记会增加上下文 Token,并让应用层承担更精细的语义拆分工作;不同模型厂商是否愿意采用相同语法,也决定了它最终会成为开放标准,还是仅限 Granite 生态的特色功能。
更现实的判断是,LLMON 短期内不会取代 JSON、Chat Template 或外部安全系统,但它证明了一个重要方向:与其继续用更长、更复杂的自然语言提示要求模型“不要听文档里的命令”,不如直接训练模型认识指令和数据之间的权限边界。
如果这个方向能够在其他模型家族上复现,并在多轮自适应攻击中保持稳定,LLM 原生标记语言可能成为 Agent 基础设施的一部分。届时,Prompt 不再只是一段写给模型看的文字,而会更像一份带类型、权限和执行语义的程序。
参考来源
- Hugging Face:LLMON 接入 Granite 4.1 3B 与 8B — IBM Granite 团队于 2026 年 11 月 12 日发布的技术说明,包含设计、训练方法与提示注入评测结论。
- Hugging Face:Granite 4.1 8B LLMON Preview — 8B 预览模型卡,提供格式定义、能力跑分、限制和许可证信息。
- Hugging Face:Granite 4.1 3B LLMON Preview — 3B 预览模型卡,包含多语言支持、基准测试及使用边界。
- Hugging Face:Granite 4.1 技术报告 — Granite 4.1 的架构、15 万亿 Token 训练流程和最长 512K 上下文说明。
- GitHub:generative-computing/llmon — LLMON 官方开源仓库,包含语法、转换器、模板和领域微调示例。
- GitHub:generative-computing/mellea — 已原生支持 LLMON 的生成式程序开发框架。