4.85MB装下模型记忆
parentheses-1.0-240M 发布:253M 参数模型用固定 4.85MB 循环状态替代随上下文增长的 KV Cache,但能力测试仍属早期。
parentheses-1.0-240M 发布:4.85MB 固定状态,换掉不断膨胀的 KV Cache
11 月 13 日,印度小团队 uncoalesced 发布了 parentheses-1.0-240M:一个拥有 253,544,176 个参数的循环语言模型,仅用一块 8GB 显存的 RTX 5050 Laptop GPU 从头训练,推理时用固定 4.85MB 状态保存上下文。模型权重采用 Apache 2.0,代码采用 MIT 许可证,已经同步至 Hugging Face 和 GitHub。(reddit.com)
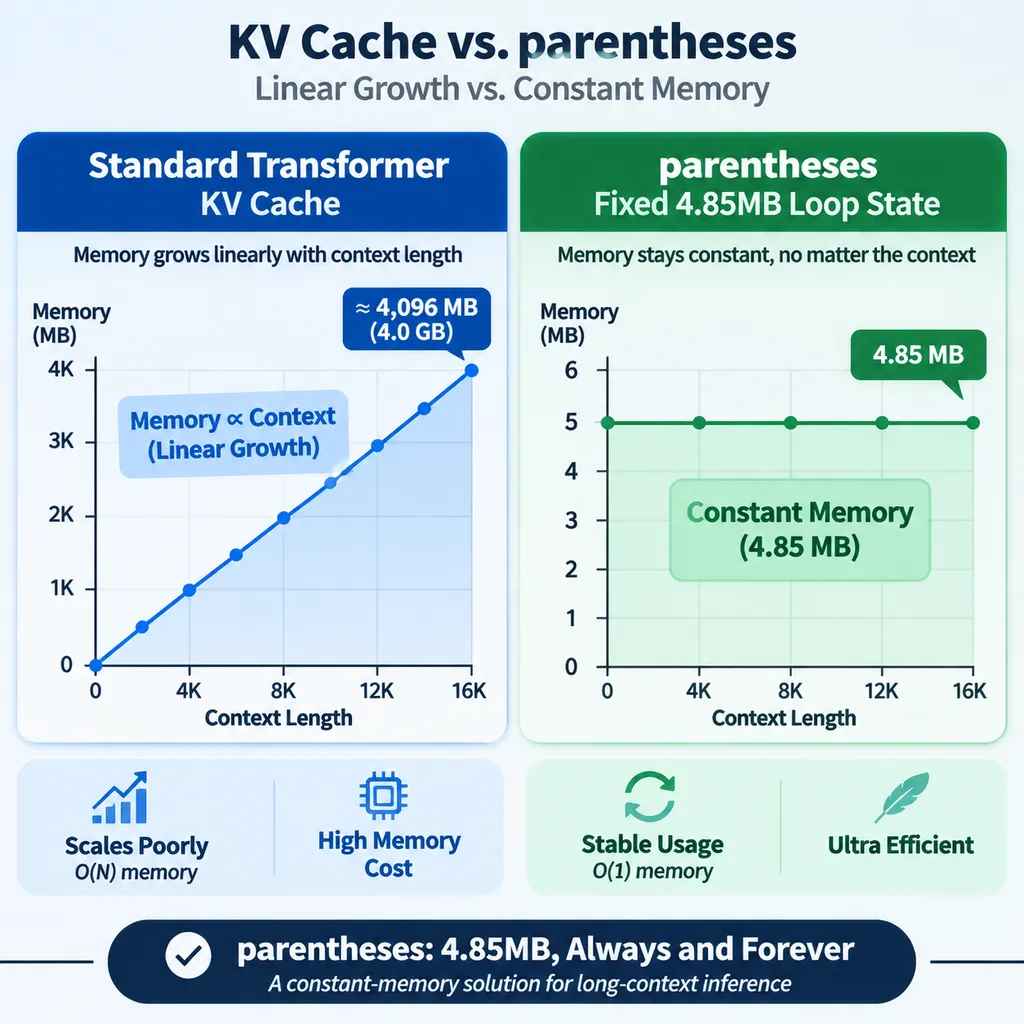
**parentheses-1.0-240M 是一个基于选择性线性注意力的循环状态空间语言模型。**它不是标准 Transformer,也不会为每个历史 Token 保存一份 Key 和 Value,而是把已经读过的上下文压缩进一组固定大小的状态矩阵。无论模型生成 100 个还是 16,000 个 Token,这组状态占用都保持在 4.85MB。
这不是一个试图挑战前沿大模型能力的发布,而是一次相当明确的系统工程实验:**一个两亿级参数模型,能否把训练和推理都塞进普通游戏本,同时保留足够可用的代码生成、多语言和拒答能力?**目前的答案是“部分可以”,但远没有达到可以忽略压缩损失的程度。
真正值得关注的是固定状态,不是跑分
**循环状态是线性注意力或状态空间模型为每个请求维护的一块固定大小内存。**标准 Transformer 在生成过程中需要保存此前每个 Token 的 Key 和 Value,因此 KV Cache 会随上下文长度持续增长;循环模型则像一个不断被改写的“工作记忆”,每读入一个 Token,就对旧状态做衰减,再写入一条新信息。
parentheses 的核心递推公式并不复杂:
S_t = α_t S_{t-1} + β_t (k_t ⊗ v_t),y_t = q_t S_t
其中,S_t 是当前状态,α_t 控制旧信息保留多少,β_t 控制当前 Token 写入多少,k_t ⊗ v_t 是一次秩一更新,q_t 则从状态中读取输出。通俗地说,它不像 Transformer 那样保存完整聊天记录,而是每看完一句话就重写一次摘要。
**选择性线性注意力是一类把历史上下文压缩成固定矩阵、并通过输入相关门控决定记忆与遗忘的注意力机制。**它的优势是单步生成不需要重新扫描全部历史,也不需要让缓存随着序列增长;代价是状态必然有容量上限,新信息可能覆盖旧信息,精确回忆能力通常弱于完整 KV Cache。
parentheses 一共有 16 层,隐藏维度为 1024,每层包含 16 个注意力头,每个头的维度为 64,SwiGLU 中间层宽度为 2752。训练阶段使用大小为 64 的分块并行扫描,让序列仍可在 GPU 上并行处理;推理阶段则切换为逐 Token 循环更新。模型没有位置编码,顺序主要由状态更新和衰减过程隐式表达。(reddit.com)
| 项目 | parentheses-1.0-240M | TinyLlama-1.1B | Pythia-1.4B | |---|---:|---:|---:| | 参数量 | 253.54M | 1.1B | 1.4B | | 推理记忆形式 | 固定循环状态 | KV Cache | KV Cache | | 4096 Token 状态/缓存 | 4.85MB | 536.9MB | 1440.0MB | | 16384 Token 状态/缓存 | 4.85MB | 2147.6MB | 5760.0MB | | 是否随上下文增长 | 否 | 是 | 是 |
在 4096 Token 下,TinyLlama 的 KV Cache 约为 parentheses 固定状态的 111 倍,Pythia-1.4B 则接近 297 倍;到 16384 Token,这两个数字扩大至约 443 倍和 1188 倍。这里展示的是不同架构的缓存规模,不等于总显存占用,也不能直接说明模型速度或能力,但它准确指出了循环架构的工程价值:并发请求的上下文越长,固定状态越容易做容量规划。(reddit.com)
4.85MB 是怎么算出来的
**4.85MB 指的是模型推理状态,而不是完整模型文件大小。**parentheses 的状态包含 1,212,416 个浮点数,以 FP32 的每个元素 4 字节计算,共约 4,849,664 字节。完整 FP32 权重文件则约为 967MB 至 1.01GB,BF16 导出版本约为 484MB 至 507MB。(reddit.com)
这个区别很重要。固定状态解决的是长上下文生成时的动态内存问题,并没有把 253M 参数模型本身压缩到 4.85MB。模型运行时仍需加载数百 MB 权重,另外还需要激活值、算子工作区和运行时框架占用。
官方还提供了面向 DirectML 和 AMD Ryzen AI NPU 的静态 ONNX 循环步进图,文件小于 1.15GB。该计算图一次只接收当前 Token 和上一时刻状态,输出 logits 与新状态,因此不需要构造长度不断变化的注意力矩阵。官方声称它在连续 32 个解码步骤上与 PyTorch 参考实现的最大 logits 误差低于 1×10⁻⁴,但尚未公布功耗和完整设备吞吐量。(huggingface.co)
跑分有亮点,但不能按排行榜理解
**parentheses 的评测更适合被视为发布自检,而不是严格的模型排行榜成绩。**团队测试了 9 个基准,每个基准执行 4 次,共计 960 次生成;第一次使用贪心解码,后三次使用 temperature 0.7 采样。对比基线来自其他论文公开数字,并非在同一评测框架、提示模板和解码配置下重新运行。(reddit.com)
| 基准 | 最好成绩 | 4 次平均 | 官方引用的小模型基线 | 判断 | |---|---:|---:|---:|---| | TerminalBench | 78.33% | 74.16% | 66.00% | 有潜力,但样本较小 | | TruthfulQA | 91.00% | 90.00% | 84.50% | 主要受拒答训练推动 | | MBPP Sanitized | 90.67% | 81.92% | 82.20% | 最佳值亮眼,波动明显 | | HaluEval QA | 80.00% | 78.34% | 68.20% | 更像真假判断与校准能力 | | MMLU | 50.00% | 30.00% | 30.20% | 50% 单次结果应视为噪声 | | HellaSwag | 33.33% | 24.16% | 42.80% | 明显落后 | | ARC-Challenge | 26.67% | 16.67% | 34.20% | 推理能力不足 | | Belebele Dravidian | 25.00% | 17.18% | 31.25% | 多语言覆盖不等于理解充分 | | GSM8K | 10.00% | 5.83% | 13.20% | 数学能力仍弱 |
最容易被误读的是 MMLU。四次结果分别为 23.33%、30.00%、16.67% 和 50.00%,平均值只有 30.00%,几乎等于 SmolLM-135M 的 30.20%。团队自己也明确表示,50.00% 的单次采样结果应按噪声理解,而不是模型真实能力突然跃升。
MBPP 同样体现了采样波动:四次结果从 69.67% 到 90.67% 不等。一个成熟的代码模型不应该只展示最好的一次采样,因此 81.92% 的平均值比 90.67% 更有参考意义。即便如此,对于一个 253M 参数、面向多语言而非纯代码训练的模型,这项结果仍值得后续用 HumanEval、执行通过率和统一解码配置复测。
HellaSwag、ARC-Challenge 和 GSM8K 则暴露了固定状态模型更现实的一面。parentheses 在这些需要常识延续、多步推理和精确中间状态的任务上低于对比基线,说明 4.85MB 工作记忆并没有免费替代完整注意力。状态固定意味着成本固定,也意味着容量固定。
91% TruthfulQA 的核心,其实是学会说“不知道”
**认识论拒答是模型在问题前提错误、实体虚构或信息不足时主动拒绝编造答案的行为。**parentheses 团队专门构造了 8000 条拒答训练轨迹,英语、卡纳达语、泰米尔语、泰卢固语和马拉雅拉姆语各 1600 条。
在 100 条保留测试提示中,模型对 94 条陷阱问题执行了拒答,包括时代错置、虚构实体、未来事件和错误前提;在 90 条正常对照问题中,模型没有出现误拒答。团队也承认,TruthfulQA 约 90% 的成绩主要来自这种行为,因此它更接近“校准和拒答测试”,不能简单理解为模型掌握了大量可靠知识。(reddit.com)
这个方向对小模型很实用。两亿级模型的知识容量有限,与其强迫它对所有问题都生成流畅答案,不如训练它识别自己不知道什么。对于本地离线助手、设备诊断和垂直领域终端,这种可预测的保守性可能比多答对几道冷知识题更有价值。
但拒答训练也很容易把基准变成策略测试。若 TruthfulQA 的提示经常包含明显错误前提,一个偏好拒绝回答的模型可能拿到高分,却无法证明它在开放问答中拥有更好的事实性。后续评测至少需要拆分“知道并正确回答”“不知道并拒绝回答”“知道却错误拒绝”三种情况。
一块 8GB 笔记本 GPU 训练,代价是复杂的工程妥协
**低显存训练不是减少参数本身,而是控制优化器、激活值、批次和中间状态在同一时刻的驻留规模。**parentheses 从早期约 130M 模型扩宽而来,扩宽后在继续训练前与原模型保持 98.4% 的 Top-1 输出一致率,随后再进行多阶段预训练、退火、监督微调和偏好对齐。
官方披露的基础语料池包含约 10.87 亿 Token,其中训练集约 10.76 亿 Token;前 4000 个训练步骤累计处理约 2.62 亿 Token。后续阶段加入德拉威语言、教材、双语语料、STEM、代码、数学推理、长上下文样本以及 8000 条拒答数据。所有公开训练数据被限定为 Apache 2.0、MIT、BSD、CC0、CC-BY-4.0 或 ODC 等可商用许可来源。(github.com)
模型还使用了一个 32768 词表的字节级 BPE 分词器,并针对印度文字中的 akshara 音节单元做了保留。它主要支持卡纳达语、泰米尔语、泰卢固语、马拉雅拉姆语和英语,Tulu、Koya、Kuvi、Kolami 则仍处于实验状态。
这里最值得肯定的不是“消费级 GPU 也能训练大模型”——253M 参数离今天的大模型尺度很远——而是团队把架构、数据许可、训练过程、评测脚本、ONNX 导出和已知缺陷一起公开了。对于想研究循环模型和端侧推理的开发者,这比单独发布一个无法复现的权重文件有用得多。
固定状态的代价:它会忘,而且可能忘错
**有损状态是指历史信息被压缩后无法被完整恢复的模型记忆。**parentheses 没有位置编码,状态内容又按新近程度加权,因此越早出现的信息越容易被后续 Token 稀释。官方明确列出了这一限制,而不是把固定内存包装成“无限上下文”。(reddit.com)
这意味着模型即使能够稳定运行 16384 个循环步骤,也不等于它能准确利用 16384 Token 前的细节。数值稳定性只证明状态没有出现 NaN、爆炸或明显漂移,不证明长距离检索正确率。真正有意义的测试应该包括不同深度的 Needle-in-a-Haystack、重复实体覆盖、代码变量追踪、多轮指代和跨段落事实冲突。
固定状态尤其不适合需要逐字保真的场景。例如,让模型读入一份长合同后复述第 37 条中的金额,Transformer 可以从 KV Cache 中重新关注对应 Token;循环模型只能从压缩后的状态中恢复信息。如果金额在写入过程中被覆盖,就没有原始缓存可以回看。
反过来,循环状态很适合不要求逐字回忆、但需要持续处理数据流的任务,例如设备日志摘要、语音流状态跟踪、传感器异常检测、终端命令辅助和低功耗离线对话。它更像人的工作记忆,而不是一个可以随机访问的数据库。
它不是 Transformer 杀手,但方向是对的
**parentheses-1.0-240M 的价值在于证明固定状态语言模型可以被完整地部署到消费级和边缘硬件链路中。**253M 参数、4.85MB 状态、8GB 单卡训练、ONNX 循环图和宽松许可证,这些指标组合在一起,比单项跑分更有意义。
它目前不适合被当作通用聊天模型。MMLU 平均 30%、GSM8K 平均 5.83%、ARC-Challenge 平均 16.67%,已经说明其知识和推理能力仍停留在小模型实验阶段。模型卡中一些跨框架、跨年份和跨评测设置的对比也需要谨慎阅读,尤其不能用最佳采样成绩替代稳定平均水平。
它也没有证明纯循环架构优于混合架构。更现实的路线可能是让大部分层使用固定状态处理长序列,再间隔插入少量标准注意力层恢复高分辨率检索能力。这样既压低 KV Cache,又避免把全部历史压进一个不可逆摘要。
但对端侧 AI 而言,4.85MB 固定状态确实是一个值得记住的数字。模型权重可以量化,算子可以优化,真正难控制的是每个并发请求随上下文增长的动态缓存。parentheses 把这部分成本变成常数,也把问题从“显存会不会耗尽”改成了“固定状态究竟能记住多少”。
后一个问题更难,却也更接近下一代高效模型架构真正需要解决的核心。
参考来源
- Reddit 发布帖:团队公布模型限制、架构公式、固定状态规模和初步评测结果。
- Hugging Face 模型页面:包含模型权重、完整参数配置、各项基准结果和使用说明。
- GitHub 项目仓库:包含模型代码、评测脚本、训练数据说明、ONNX 导出和已知限制。