llama.cpp 1.0:本地推理终于成年
llama.cpp 与 ggml 同步发布 v1.0.0,正式建立 API、ABI 和语义化版本规则。它不是一次单纯的性能升级,而是本地 AI 基础设施从高速试验转向稳定生态的关键节点。
llama.cpp 1.0:本地推理终于成年
11 月 13 日,ggml-org 正式发布 llama.cpp v1.0.0,同时将底层张量计算库 ggml 升级至 v1.0.0。这是 llama.cpp 诞生约三年半以来的首个正式大版本,也是项目第一次明确承诺:今后的 API 与 ABI 不兼容变更,必须通过主版本号升级向下游开发者发出信号。(huggingface.co)
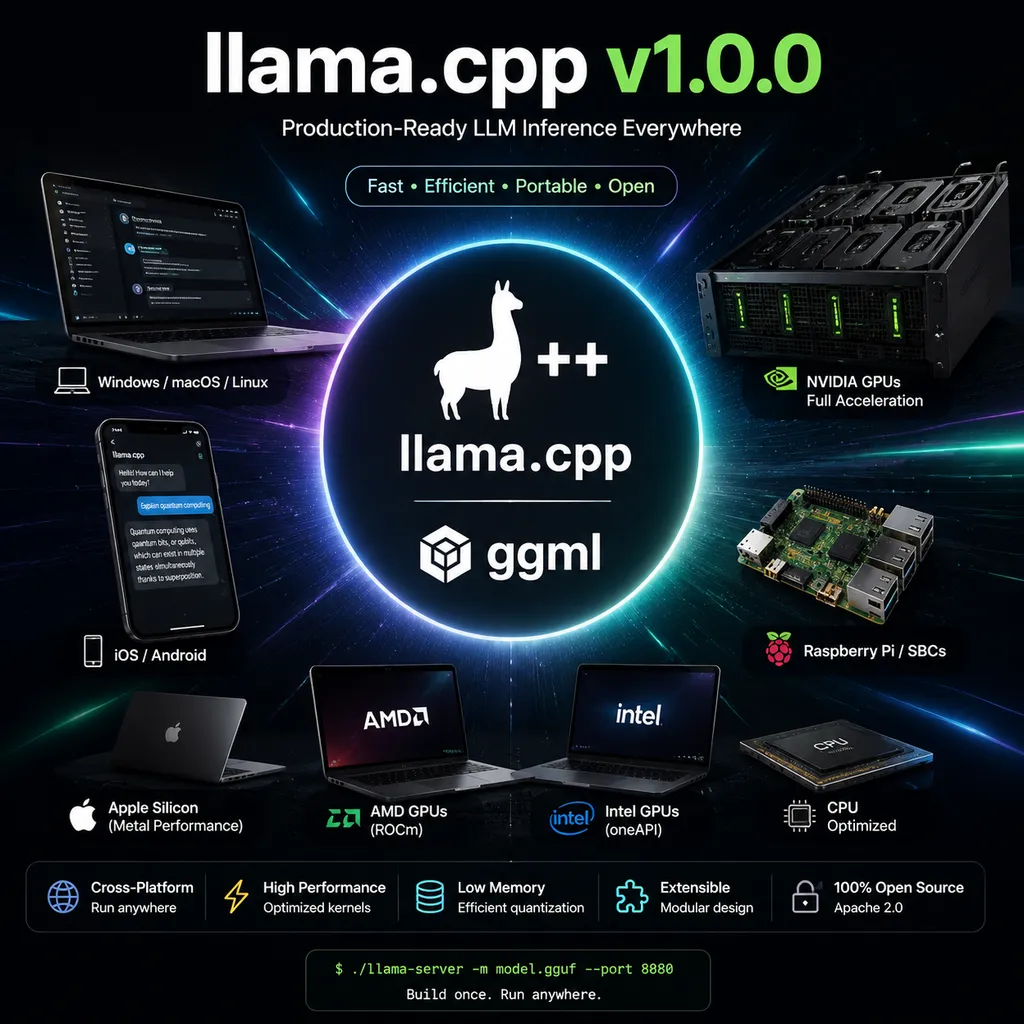
**llama.cpp 是一套以 C/C++ 编写、面向跨平台大模型推理的开源运行时。**它通过 GGUF 量化格式和针对不同硬件编写的计算后端,让大语言模型、多模态模型和语音模型能够运行在普通笔记本、手机、工作站乃至企业服务器上。
如果只看版本号,v1.0.0 很容易被理解成一次“终于脱离测试版”的常规升级。但这次发布真正重要的地方,不是某项跑分突然翻倍,而是 llama.cpp 开始像一项成熟基础设施那样管理兼容性。
过去,llama.cpp 最大的优点和最大的问题其实是同一件事:更新太快。新模型上线后,社区通常很快就能补上支持;新的 CUDA、Metal、Vulkan 或移动芯片优化,也会快速进入主分支。代价是,依赖 libllama、libggml 的桌面应用、插件和推理服务经常需要追着接口变化修改代码。
v1.0.0 给这辆高速行驶的车装上了转向灯。
1.0 的核心不是“更快”,而是兼容性契约
**语义化版本是用主版本、次版本和补丁版本表达兼容性变化的版本管理规则。**从 v1.0.0 开始,ggml-org 将按照 MAJOR.MINOR.PATCH 的方式管理公开 C API,开发者看到版本号就能大致判断升级风险。
| 版本变化 | 触发条件 | 对下游项目的含义 |
|---|---|---|
| MAJOR 主版本 | include 目录中的公开 C API 出现破坏性变更 | 需要阅读迁移说明,可能必须修改和重新编译代码 |
| MINOR 次版本 | 新增兼容功能、硬件后端、模型支持或公开接口 | 原有调用原则上继续工作,可相对安全地升级 |
| PATCH 补丁版本 | 不改变 API 的缺陷修复 | 主要用于修复问题,升级成本最低 |
**API 是源代码层面可调用的函数和数据结构约定,ABI 则是编译后程序在二进制层面的交互约定。**API 没变不代表 ABI 一定兼容,例如结构体布局、符号或调用约定变化,都可能让旧程序无法正确加载新动态库。
官方这次同时强调 API 与 ABI,意味着承诺不只覆盖“代码还能不能编译”,也覆盖“已经编译的应用能不能继续链接”。对于 LM Studio 一类桌面工具、移动应用、插件系统和 Linux 发行版维护者,这比新增一个模型架构更有长期价值。
需要注意的是,v1.0.0 本身就是一次破坏性升级。项目移除了 llama_set_warmup 等 35 个已弃用函数,同时删除 defrag_thold 及对应参数,并把 NextN、推测解码相关接口从 llama-ext.h 提升至公开的 llama.h。换句话说,版本规则从今天开始更稳定,但依赖旧接口的项目仍要先完成一次迁移。(github.com)
这不是坏事。长期保留废弃接口看似照顾兼容性,实际会持续增加维护成本,让新后端、新模型和性能优化背上越来越重的历史包袱。v1.0.0 相当于一次集中清理,之后再用明确的主版本号标记下一次破坏性变化。
这次更新到底加了什么
**llama.cpp v1.0.0 是一次兼容性治理、内存优化、模型扩展和服务端加固同时进行的大版本发布。**除了版本规则,正式版本还带来了 FP8 KV Cache、MoE 专家缓存、多模态统一接口、语音生成支持以及一批服务端安全修复。
| 更新方向 | v1.0.0 主要变化 | 实际价值 |
|---|---|---|
| 接口治理 | 删除 35 个废弃函数,NextN 接口进入 llama.h | 降低长期维护成本,公开接口边界更清晰 |
| KV Cache | 支持 OCP FP8 KV Cache | 长上下文场景可降低缓存显存占用 |
| MoE 推理 | 增加主机内存专家缓存,可配置 CPU 处理比例 | 显存放不下全部专家时,减少频繁搬运带来的停顿 |
| 模型加载 | 支持外部 PLE、engram GGUF 分片 | 适配参数组织更复杂的新模型架构 |
| 新模型 | 新增 Kimi-K3.1-Pro、Ripple-65B-Preview、xing4_0 等架构 | 新模型发布后的本地适配速度继续保持竞争力 |
| 多模态 | 统一至 mtmd 基础设施,支持新视觉与流式音频能力 | 文本、图像、音频模型共享更多运行时组件 |
| 服务能力 | 新增 /v1/audio/speech,增强 Responses 格式兼容 | 本地服务从文本生成继续向语音和结构化输出扩展 |
| 安全性 | 修复 SSRF、CORS、DNS rebinding 等问题 | 更适合在局域网或服务器环境中长期运行 |
| Web UI | 增加会话分组、Markdown 编辑器和移动端布局 | 官方服务不再只是开发测试界面 |
FP8 KV Cache,瞄准的是真正昂贵的长上下文
**KV Cache 是模型在生成过程中保存历史注意力键和值的缓存。**它避免模型每生成一个 token 都重新计算前文,但上下文越长、并发请求越多,KV Cache 占用的显存就越可观。
此前很多用户只关注模型权重的 4-bit 或 5-bit 量化,却忽略了长对话运行一段时间后,KV Cache 可能成为新的内存瓶颈。v1.0.0 新增 f8_e4m3 类型的 FP8 KV Cache,并支持可选的静态逐张量缩放。
直观理解,FP8 就是用 8 位浮点数保存缓存,而不是继续使用更宽的数据类型。它不能保证所有模型、所有任务都无损,但在适合的场景下,能够显著降低长上下文缓存的内存压力。对于 32K、64K 甚至更长上下文的本地助手,这项变化比单次生成快几个百分点更实用。
MoE 缓存开始处理“显存放不下专家”的现实
**MoE 是让模型每次只激活部分专家网络的稀疏架构。**它可以用较低的单 token 计算量承载更大的总参数规模,但未被激活的专家权重依然需要存储,并可能在 CPU 与 GPU 之间频繁搬运。
v1.0.0 引入了位于主机内存中的 MoE 专家缓存,并允许配置缓存未命中时由 CPU 承担的计算比例。系统还加入 LRFU、ClassLRU 等替换策略,目标是把经常用到的专家留在更快的位置,同时减少 GPU 等待数据搬运的时间。
这项功能不会让一台普通电脑凭空获得数据中心 GPU 的性能,但它让“大模型超过显存容量”从一个简单的能不能运行问题,变成可以调节缓存、CPU 计算比例和延迟的工程问题。
这正是 llama.cpp 的典型路线:它不假设每个人都有完整装下模型的显存,而是尽可能利用手头已有的 CPU、内存和 GPU。
多模态和语音不再是外挂功能
**mtmd 是 llama.cpp 用于组织多模态模型加载、预处理和子上下文计算的基础设施。**v1.0.0 移除了旧的 clip.h 路线,把视觉、音频和生成模型的相关机制进一步整合到 mtmd 中。
这次更新支持 MageVL-Cowork 和 Kimi-K3.1 的视觉能力,也加入了 drama-3 TTS,并让 Gemma 4 可以接收流式音频输入。多模态子上下文还可以共享计算缓冲区,降低视觉、音频与文本组件同时加载时的额外内存开销。
从产品角度看,这意味着 llama.cpp 正在从“本地聊天模型运行器”变成通用端侧生成式 AI 运行时。未来的本地应用未必只需要一个文本框,它们可能需要读 PDF、看屏幕、处理麦克风音频、生成语音,再调用本地工具完成任务。
v1.0.0 新增的 /v1/audio/speech 端点也是同一趋势的体现。它让 llama-server 的能力范围从文本、嵌入、重排序、结构化输出,继续扩展到语音生成,但本文讨论的是工具链更新,因此不提供调用代码。
服务器安全修复,比新增模型更值得升级
**llama-server 是 llama.cpp 内置的 HTTP 推理服务和 Web 界面。**它最初更像方便开发者测试模型的附属工具,但随着越来越多人把它部署到家庭服务器、工作站或局域网中,服务端安全已经不能继续按“只在本机使用”的假设处理。
v1.0.0 修复了涉及 SSRF、CORS 和 DNS rebinding 的多个问题,并限制 HF_TOKEN 只发送给 Hugging Face 域名。新版本还增加了显式允许未认证工具调用、允许访问私有媒体地址等开关,把高风险行为从默认开放改为主动选择。
对于只在 127.0.0.1 上运行命令行工具的用户,这些修复可能没有明显体感;对于将服务暴露给局域网、浏览器扩展或其他应用的用户,这恰恰是最应该尽快升级的部分。
官方 Web UI 也在变得更像一款完整产品:支持会话分组、长文本 Markdown 编辑、移动端全屏页面、PDF 页面缩略图和聊天搜索。llama.cpp 仍然不是以消费级聊天产品为核心,但它已经提供了一套足以让开发者直接交付内部工具的基础界面。
与 vLLM、MLX 相比,llama.cpp 的护城河是什么
**本地推理引擎是负责加载模型权重、管理内存并在具体硬件上执行计算的软件层。**不同推理引擎的差异,不只是每秒生成多少 token,还包括硬件覆盖、部署复杂度、并发能力和模型适配速度。
| 工具 | 核心定位 | 优势场景 | 主要限制 | |---|---|---|---| | llama.cpp | 跨平台本地与边缘推理 | CPU、消费级 GPU、移动设备、混合卸载、单机私有部署 | 高并发数据中心吞吐并非唯一优先级 | | vLLM | GPU 服务器高吞吐推理 | NVIDIA、AMD 服务器,多用户并发和批处理 | 对普通 CPU、手机和轻量桌面的覆盖较弱 | | MLX | Apple Silicon 机器学习框架 | Mac 上的训练、微调和推理 | 主要围绕苹果硬件生态 | | ONNX Runtime | 通用模型执行运行时 | 跨硬件部署和传统模型生态 | 大模型格式转换与社区模型即用性通常不如 GGUF 路线直接 |
llama.cpp 最难被替代的能力,不是某一张显卡上的峰值速度,而是“同一套模型和接口能跑在尽可能多的设备上”。官方称当前已支持超过 150 种模型架构变体,并覆盖主流推测解码方法;底层后端则横跨 CUDA、Metal、Vulkan、SYCL、OpenCL、WebGPU、Hexagon 等不同路线。(huggingface.co)
如果任务是用多张数据中心 GPU 服务大量并发请求,vLLM 等服务器引擎往往更合适;如果任务是把同一套 AI 能力放进 Mac、Windows PC、Linux 主机、安卓设备和边缘硬件,llama.cpp 的工程价值更突出。
v1.0.0 进一步强化的正是这种“生态底座”定位,而不是试图在所有使用场景里击败所有对手。
Hugging Face 正在把 llama.cpp 推向基础设施化
**基础设施化是指一个开源项目从开发者工具成长为被软件、发行版和硬件厂商长期依赖的公共组件。**2026 年 2 月,GGML 与 llama.cpp 团队加入 Hugging Face,但仍保持开源、社区驱动和技术路线自主。Hugging Face 提供的重点不是改变项目方向,而是长期资源、分发体系和持续集成能力。(huggingface.co)
这次 v1.0.0 已经体现出整合后的变化。官方正在使用 HF Buckets 和 HF Jobs 扩展持续集成容量,并在 NVIDIA、AMD、Qualcomm、Arm、IBM、Intel 提供的硬件上增加自托管测试节点。
分发方式也不再只有“克隆代码然后自己编译”。目前官方列出的渠道包括 Linux、macOS、Windows、Android、iOS 的预发布构建,以及 Docker、Debian、Homebrew、conda-forge、MacPorts、Winget 和苹果平台的 XCFramework。(huggingface.co)
对开发者来说,分发体系和接口稳定性往往比多支持一个模型更重要。模型支持决定今天能不能跑,版本与打包规则决定半年后应用还能不能持续维护。
我们怎么看:这是本地 AI 的 Linux 2.6 时刻
**llama.cpp v1.0.0 的意义,是本地推理生态终于拥有了一套可预期的升级规则。**它并不意味着接口从此永不变化,也不意味着 v1 系列一定长期二进制兼容;官方维护者已经明确表示,未来主版本可能比从 v0 到 v1 的过程出现得更频繁。
但主版本变得更频繁并不是倒退。真正危险的是破坏性变化发生了,版本号却没有告诉任何人。只要边界清晰、迁移路径明确,下游项目就能选择固定版本、延迟升级或安排兼容工作,而不是在某次日常更新后突然发现构建失败。
v1.0.0 也暴露了 llama.cpp 接下来最大的挑战:它必须同时满足两个方向。一边是快速跟进新模型、新量化格式和新硬件,另一边是维持足够稳定的公共接口,让上千个下游应用不必每天追踪主分支。
这两个目标天然冲突。新模型架构越来越复杂,多模态、MoE、推测解码和工具调用持续改变推理运行时的结构;但 llama.cpp 又已经不再是一个可以随意重构的个人实验项目。
好消息是,团队没有用“冻结创新”换取稳定,而是选择用语义化版本、公开头文件边界、正式发行版和大规模跨硬件 CI 管理变化。这是一条更难、但也更正确的路。
对于普通本地用户,v1.0.0 带来的直接收益是更低的长上下文内存压力、更完善的多模态和语音支持,以及更安全的服务端。对于应用开发者,它带来的核心收益则是一句更朴素的话:以后看到版本号,终于知道升级可能会发生什么。
本地大模型推理没有在 v1.0.0 这一天突然成熟,但 llama.cpp 从今天起,开始按照成熟基础设施的方式对待自己的生态。
参考来源
- Hugging Face:llama.cpp v1.0.0,构建更稳固的本地 AI 生态基础 —— 官方发布文章,介绍语义化版本规则、分发渠道、持续集成和模型覆盖。
- GitHub:llama.cpp v1.0.0 Release Notes —— 完整版本说明,包含 API、模型、KV Cache、MoE、多模态、服务端与 UI 变更。
- GitHub:ggml v1.0.0 Release Notes —— 底层张量库的接口清理、FP8 支持和各硬件后端优化说明。
- GitHub:llama.cpp v1.0.0 准备讨论 —— 维护者关于清理废弃接口、破坏性升级和版本策略的公开讨论。
- Hugging Face:GGML 与 llama.cpp 加入 Hugging Face —— 介绍团队合作关系、长期资源投入及本地 AI 技术路线。