Perplexity公开决策模型底牌
Perplexity 发布 Decider v1.3,并首次系统公开决策模型的训练、评测与生产用法。它不负责生成答案,而是用一次推理完成模型路由、分类、评分、重排和信息抽取。
Perplexity Decider v1.3:把模型路由决策的训练、评测与落地场景公开
Perplexity 在 11 月 12 日发布 Decider v1.3 和 Decider Flash v1.3,并罕见地把决策模型如何训练、如何评测,以及如何用于自家搜索和 Agent 系统讲了个透。两款模型均基于通义千问底座训练,以 Apache-2.0 许可提供权重;其中完整版基于 Qwen3.8-27B,Flash 版基于 Qwen3.5-4B 蒸馏而来。(perplexity.ai)
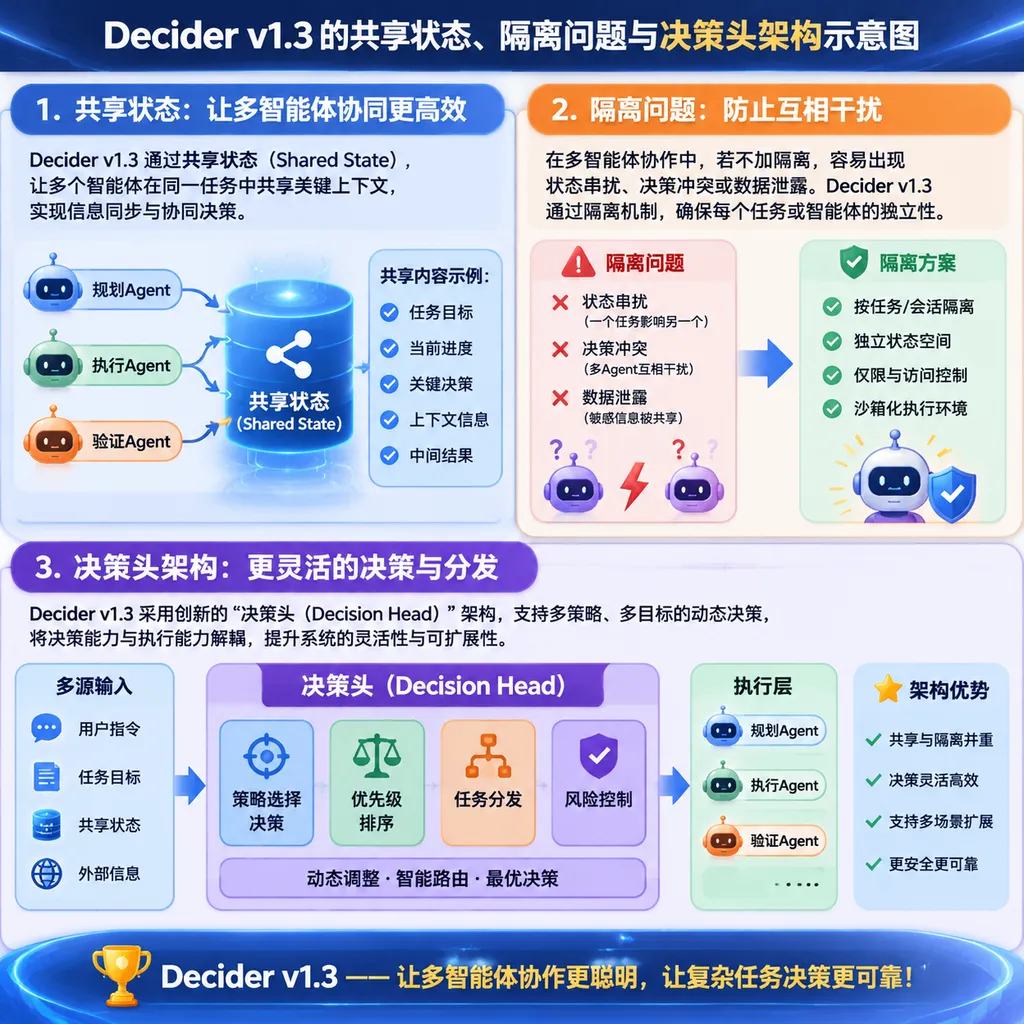
Decider 是一种通用决策模型,即输入一段共享状态和若干问题,直接返回各选项的概率,而不是逐字生成自然语言答案。 它支持二元判断、多选分类、等级评分和新加入的原文定位,可以用来做模型路由、搜索结果重排、内容审核、质量评估、意图识别和结构化信息抽取。
这次更新真正值得关注的地方,不是 Perplexity 又做了一个分类器,而是它试图把模型系统里的“判断层”从生成式大模型中独立出来。
过去,开发者经常让 GPT、Claude 或 Qwen 回答“这个问题难不难”“是否需要联网”“应该调用哪个工具”,然后再解析模型输出的 JSON。这个方案足够灵活,却也有三个明显问题:生成 token 带来额外延迟,格式可能漂移,相同输入还可能因为措辞和采样产生不同结果。
Decider 的做法更像给大模型换上一块专门的仪表盘:底座仍负责理解文本和图片,但输出端不再预测下一个词,而是直接读取每个选项的分数。
它不是更会聊天,而是更会做选择
决策模型与聊天模型的核心差别,是前者只计算答案分布,不生成解释过程。 Decider 会把一个请求拆成共享状态 state 和多个问题,每个问题可以带有 1 至 255 个候选项;模型在特殊标记位置读取隐藏状态,再通过独立的线性决策头将其映射为选项概率。
这种设计允许多个问题复用同一份上下文。例如,客服系统拿到一张工单后,可以同时判断负责团队、紧急程度、用户情绪和是否涉及退款,而不必把同一张工单连续发送给四个模型。
Perplexity 强调,决策问题可以在一次前向推理中处理,并且没有输出 token。这里的收益不只是少生成几个字,而是把原本不可控的文本生成,变成更容易设定阈值、统计误差和接入业务规则的概率输出。
| 模型 | 训练底座 | 主要定位 | BF16 权重显存 | 推荐场景 | |---|---|---|---:|---| | Decider v1.3 | Qwen3.8-27B | 高精度决策与复杂评分 | 约 49 GiB,另需工作显存 | 高风险审核、复杂路由、搜索重排 | | Decider Flash v1.3 | Qwen3.5-4B | 低成本、高吞吐决策 | 约 8.5 GiB,另需工作显存 | 批量标签、内容过滤、实时路由 | | 通用生成模型 | 各类聊天模型 | 生成文本并兼顾判断 | 取决于模型规模 | 需要解释、改写或开放式回答 | | 传统专用分类器 | BERT、Embedding 加分类头等 | 固定任务分类 | 通常较低 | 标签稳定、数据充足的单一任务 |
模型卡显示,Decider v1.3 的权重规模约为 26B 参数,Flash 模型页面显示约 5B 参数;Perplexity 在训练描述中仍按 27B 和 4B 底座称呼两者。两款模型的默认上下文上限为 32768 token,训练序列最长使用到 30720 token。(huggingface.co)
v1.3 解决了一个隐蔽的稳定性问题
Decider v1.3 的主要架构变化,是让不同问题彼此隔离,减少问题顺序和标签形式对答案的影响。 v1.2 会让共享状态和所有问题互相注意,这能最大程度共享计算,但一个问题的出现可能改变另一个问题的结果。
v1.3 采用了 Perplexity 所称的“隔离问题”注意力模式:共享状态可以看到所有问题,但每个问题只能看到共享状态和自己的 token,不能直接读取其他问题。它没有做到完全无干扰,却在计算复用和答案稳定性之间找到一个更实用的折中。
这个变化对生产系统很重要,因为模型路由最怕的不是平均准确率少两个点,而是增加一个无关标签后,原来的选择突然改变。
Perplexity 在 372 道多选题上进行了 4788 次请求,分别测试选项重排、标签与答案重新绑定、标签重命名等扰动。Decider v1.3 在每类变换中的答案翻转率只有 0.27%,Jev 1.14 则为 2.69% 至 4.84%;重复提交相同输入时,Decider 没有出现答案变化,Jev 的变化率为 1.88%。(perplexity.ai)
模型卡同时披露了一个容易被忽略的实现细节:本地推理默认使用完全分离的 separate 模式,每个问题单独处理,以获得最稳定的结果;训练时使用的 isolated 模式会共享状态计算,成本更低,但在官方样本中有 1.5% 至 2.2% 的最高概率答案与分离模式不同。(huggingface.co)
这意味着 Decider 的“一次处理多个问题”并非无条件免费。长文档配多个问题时,共享状态能显著省算力;错误成本很高时,则应该优先选择分离模式,而不是单纯追求吞吐量。
Locate 把分类模型变成了抽取器
Locate 是 Decider v1.3 新增的原文定位能力,可以直接返回匹配文本、字符位置和置信分数。 它面向命名实体识别、个人信息检测、合同字段抽取和抽取式问答,不要求开发者提前列出所有可能答案。
例如,系统可以同时判断一份简历是否满足高级职位要求,并抽取候选人的技能、公司名称和工作时间;处理发票时,也可以判断票据类型,再定位金额、日期和供应商名称。
Locate 不是通过生成文本完成抽取,而是引入新的特殊 token、跨度预测头和 LoRA 适配器,对可能的起点、终点及其配对关系打分。模型还能针对不同字段预测独立阈值,并在找不到答案时返回空列表,而不是编造一个最接近的字段。
Perplexity 没有把 Locate 的适配器直接合并进基础模型,因为内部实验发现,合并后会损伤原有决策任务的表现。因此,Locate 适配器只会在抽取请求到来时启用;如果一个请求同时包含普通判断和 Locate,系统仍需分别进行决策与抽取的前向计算,延迟不会凭空消失。
在 17 个域外抽取任务上,Decider v1.3 的平均分为 69.0,Flash 版为 63.6;对比模型 Liquid d1、Clairic 和 GLiNER large v2.5 分别为 43.3、41.5 和 33.6。测试覆盖科学论文、网络安全报告、隐私政策、简历、合同和结构化表格。(perplexity.ai)
三阶段训练,比跑分本身更值得看
Decider v1.3 的训练流程分为通用全量微调、领域 LoRA 专项训练和视觉专项训练三个阶段。 Perplexity 先在数百个公开数据集上统一训练 27B 模型,再把教师模型的概率分布蒸馏给 Flash 模型。
第一阶段只接受能够普遍改善模型的数据,并主动排除评测基准的训练集。第二阶段才通过 LoRA 加入特定领域和任务的数据,以降低专项优化导致通用能力漂移的风险。第三阶段继续用独立 LoRA 强化视觉任务,而且 Perplexity 明确表示,当视觉指标和文本指标冲突时,会优先保住使用量更大的文本能力。
为了降低随机种子带来的波动,Perplexity 对两个文本训练阶段分别运行三次实验,再对三组权重取平均。这个做法不新鲜,但对概率校准和边界样本稳定性比对话模型的主观体验更重要。
Flash 模型没有简单复制正确标签,而是用 KL 散度学习大模型输出的完整概率分布。Perplexity 称,在相同数据上,传统交叉熵更容易提高包含专项训练数据的基准成绩,但在完全留出的任务上泛化较差;蒸馏则能保留教师对非正确选项的不确定性信息。
Decider 的不少训练数据来自 tasksource,这个项目将分类、多选、token 标注和抽取任务整理成统一格式,目前收录超过 1100 个决策任务,包括 570 个英文任务、550 个多语言任务和45个视觉任务。其公开训练语料还提供约 100 万行精选混合数据和约 250 万行完整数据。(github.com)
评测结果不错,但别只看一张榜单
Decider v1.3 的评测重点从公开排行榜转向了真实业务中的零样本决策。 Perplexity 建立了超过 200 个内部任务,覆盖分类、评分、重排和实体抽取,并坚持不针对单个任务微调。
在 63 个分类任务上,Decider v1.3 的平均准确率为 91.6%,比 Perplexity 线上使用的多分类头系统高 6.54 个百分点。在金融、法律、编程、网络安全、医疗、政府和事实核验七个领域中,完整版均排名第一;与 Jev 1.14 相比,金融任务最高领先 12.9 个百分点,法律任务领先 9.3 个百分点。(perplexity.ai)
在搜索重排测试中,Decider v1.3 对 72 个检索任务取得 83.99 的平均 nDCG@10,比 Qwen3-Reranker-8B 高 1.81 分,比 Jev 1.14 高 2.24 分。在 BEIR 基准上,完整版和 Flash 版分别比 Qwen3-Reranker-8B 高 8.78 和 7.05 分。(perplexity.ai)
| 评测项目 | Decider v1.3 | Decider Flash v1.3 | 主要对比结果 | |---|---:|---:|---| | 63 个内部分类任务 | 91.6% | 高于线上基线,未公布绝对值 | 完整版高于生产系统 6.54 个百分点 | | 72 个检索任务 nDCG@10 | 83.99 | 未公布总平均值 | 完整版高于 Qwen3-Reranker-8B 1.81 分 | | 8 种语言平均准确率 | 88.16% | 86.50% | Jev 1.14 为 85.41% | | 17 个 Locate 抽取任务 | 69.0 | 63.6 | Liquid d1 为 43.3 | | 5 个视觉分类任务 | 76.99% | 72.77% | 完整版高于 Jev 1.14 1.47 个百分点 | | 百万生产请求裁判一致率 | 93.98% | 未公布总值 | v1.2 为 93.68%,Jev 为 93.35% |
这些数字很强,但仍然需要两层折扣。第一层是大部分结果来自 Perplexity 自测;第二层是百万真实请求没有人工标准答案,而是由前沿大模型生成参考标签,因此测试测到的部分能力其实是“与裁判模型意见一致”,不完全等同于业务正确率。
Perplexity 自己也承认,即使排行榜包含私有测试集,团队仍可能通过反复提交和观察成绩间接针对榜单调参。这种主动披露比单纯宣布“行业第一”更有价值,也解释了为什么它同时公开内部任务和真实流量评测。
成本优势明显,但数字不能横着比较
Perplexity 报告的百万请求成本显示,专用决策模型可能比生成模型便宜一个数量级。 在同一批 100 万个生产请求上,Decider v1.3 的报告成本为 26.47 美元,Flash 版为 13.24 美元,Jev 1.14 为 68.10 美元,GLM-5.3-Flash 和 DeepSeek V4.1 Flash 分别达到 312.21 美元和 349.48 美元。(perplexity.ai)
| 模型 | 100 万请求报告成本 | 相对 Flash 版 | |---|---:|---:| | Decider Flash v1.3 | 13.24 美元 | 1.0 倍 | | Decider v1.3 | 26.47 美元 | 2.0 倍 | | Jev 1.14 | 68.10 美元 | 5.1 倍 | | GLM-5.3-Flash | 312.21 美元 | 23.6 倍 | | DeepSeek V4.1 Flash | 349.48 美元 | 26.4 倍 |
这张表不能被理解为通用价格排名,因为 Decider 在本地运行,其他模型通过不同服务调用,官方也没有披露本地硬件成本的完整核算方式,更没有提供统一环境下的延迟数据。
更合理的结论是:当任务只需要回答“是或否”“选哪个”“打几分”时,让生成模型输出一段 JSON 往往是过度计算。Decider 证明了专门的概率决策头可以把这部分开销压下去,但团队仍需用自己的 GPU、并发量和错误成本重新测算。
最有价值的不是路由,而是 Agent 的内部质检
Decider 最成熟的落地场景,是充当 Agent 系统内部持续运行的裁判和质检员。 Perplexity 已用它检查 Agent 日志、诊断强化学习轨迹、验证截图界面,以及预测搜索任务需要投入多少资源。
在安全策略场景中,Decider 一天读取了 10 亿 token,覆盖 7000 个 Agent 会话,并发现了可转化为 14 条规则修复的问题,其中 6 条在两天内获批上线。将修复后的规则回放到一周日志上,最繁忙规则的报警量下降 52%,同时捕获到的合法调查目标增加约 40%。(perplexity.ai)
这个案例比公开跑分更能说明决策模型的价值。规则系统速度快、结果确定,但难以识别未知模式;大模型理解力强,却太贵且不可控。Decider 被放在两者之间,先离线寻找规则漏报和误报,再由 Agent 生成修改建议,最后交给人类安全团队审批。
它也可以分析强化学习 rollout,区分失败来自工具服务、外部网站、沙箱、测试框架还是 Agent 自己的代码。如果只看最终奖励,服务宕机可能被误认为模型能力不足,错误裁判也可能让幻觉答案获得高分;决策模型则能对过程节点逐一分类,并保存概率供后续调整阈值。
OpenAI Hub 判断:Flash 版比完整版更接近实际需求
Decider v1.3 是目前少数把训练方法、概率稳定性、成本限制和内部失败模式同时公开的决策模型。 它的最大意义不是替代 GPT 或 Claude,而是提醒开发者:模型系统里的每一个判断,并不都值得启动一次完整的文本生成。
完整版在法律、金融、复杂评分和检索重排上表现更强,但约 49 GiB 的 BF16 权重显存需求意味着至少要使用数据中心级 GPU,普通开发工作站很难直接部署。Flash 版只需约 8.5 GiB 权重显存,保留文本、图像和 Locate 能力,更适合实时路由、批量过滤和标签系统。
真正的门槛仍然是校准,而不是部署。Decider 返回的是概率,但 0.7 是否足以拦截内容、0.9 是否应该升级到昂贵模型,取决于任务分布以及误报、漏报分别会造成什么损失。Perplexity 也建议团队使用一组具有代表性的标注数据,单独寻找每项任务的阈值,而不是在所有场景中固定使用 0.5。
Decider 因此不是一个下载后就能自动优化成本的路由开关。它更像一套可编程的判断基础设施:在数据足够、阈值经过校准时,它能让多模型和 Agent 系统更快、更稳定;如果没有持续评测体系,它只会把原来难以发现的提示词问题,变成更难发现的概率偏差。
参考来源
- Perplexity Decider v1.3 模型卡:完整版的模型架构、显存需求、上下文限制与推理模式说明。
- Perplexity Decider Flash v1.3 模型卡:Flash 版底座、蒸馏关系、Locate 能力和部署要求。
- tasksource 项目:Decider 训练使用的大规模统一决策任务集合及数据格式说明。
- BEIR 检索评测项目:用于评估零样本检索与重排能力的异构信息检索基准。