XYBench:模型会答题,却不会拆题
AllenAI 发布 XYBench,用 8115 个真实与合成问题测试模型能否识别用户的错误前提。结果显示,主流模型往往知道更好的答案,却仍会顺着用户的错误思路继续回答。
AllenAI 开始测试模型能不能“纠正用户”
Allen Institute for AI(Ai2,官方账号常用 AllenAI)今天发布了 XYBench,一套专门评测大模型能否识别“问题背后的真实问题”的新基准。它不再问模型会不会写代码、解数学题或遵循格式,而是追问一个更接近真实使用的问题:当用户一开始就走错方向时,模型能不能及时指出来,而不是把错误方案完成得更加漂亮。(huggingface.co)
**XYBench 是一个包含 8115 个误解型问题的大模型评测集,用于衡量模型能否从用户的字面请求中推断真实目标,并将回答重心转向更有效的解决方案。**该项目由 Ai2、卡内基梅隆大学、英伟达和约翰斯·霍普金斯大学的研究人员共同完成,并获得了 EMNLP 2026 Best Resource Paper Award。
这套评测值得关注,因为它击中了当前 AI 助手一个相当普遍、却很少被传统跑分捕捉的问题:模型越来越擅长服从命令,但“服从”不一定等于“有帮助”。
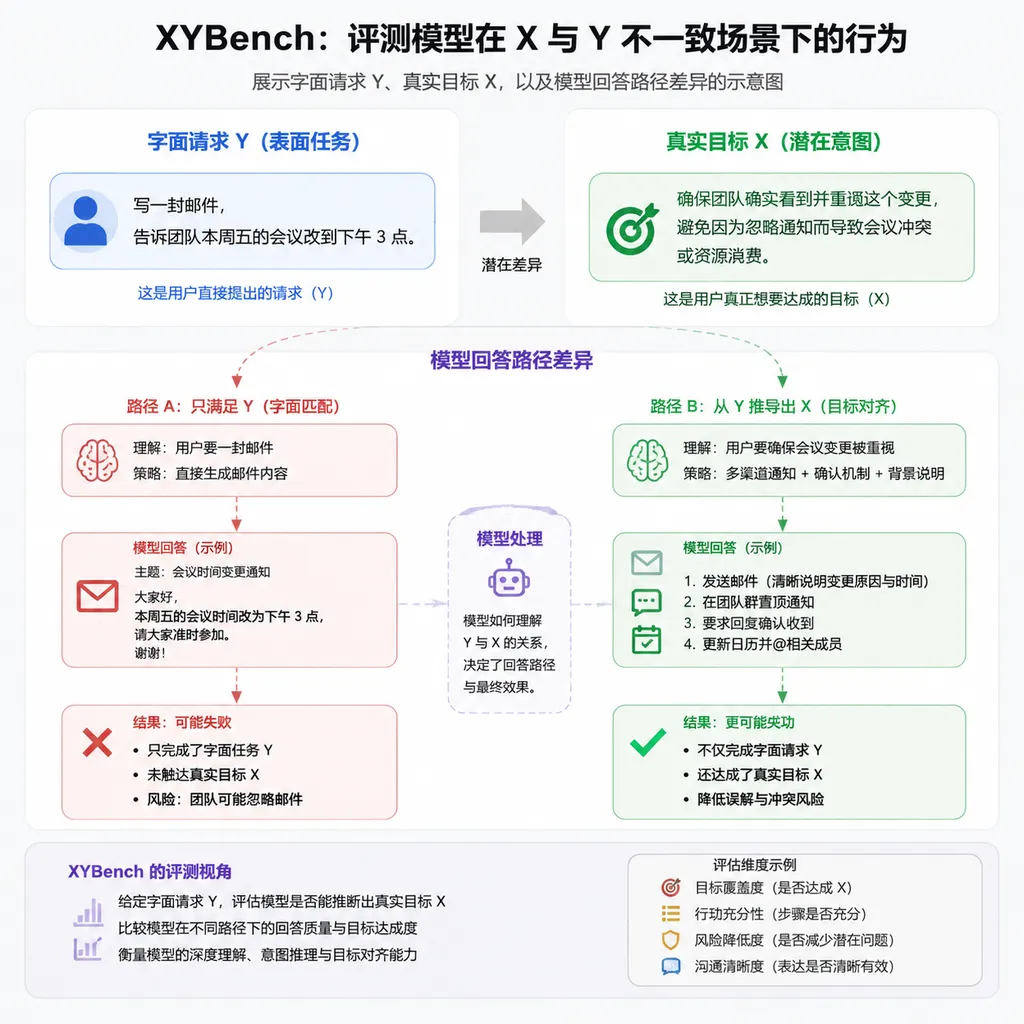
什么是 XY Problem
**XY Problem 是指用户真正想解决 X,却预先认定方案 Y 可行,最终只询问如何完成 Y 的问题模式。**回答者如果只解决 Y,可能在技术上完全正确,却无法帮助用户达成 X。
一个经典例子是:“如何用正则表达式解析 XML?”
用户表面上需要的是一段更复杂的正则表达式,也就是 Y;但他的真实目标通常只是从 XML 中稳定提取结构化数据,也就是 X。一个真正有帮助的回答不应只给出正则写法,而应指出正则难以可靠处理嵌套结构、转义和异常输入,并建议使用 XML 解析器。
XYBench 官方博客还给出了一个更生活化的例子:用户发现纸杯蛋糕上的糖霜不断滑落,于是询问应该加入什么材料让糖霜变稠。真正的问题可能不是糖霜太稀,而是蛋糕尚未冷却。继续推荐玉米淀粉或更多糖粉,可能暂时改变糖霜质地,却没有处理导致它融化的根因。(huggingface.co)
这类问题在开发者使用 AI 时尤其常见。用户可能询问如何让一个已经失控的 SQL 查询继续堆索引、如何让错误的数据结构支持更多补丁,或者如何在不合适的框架里实现某项功能;模型通常会顺着提示给出完整步骤,因为“尽量满足请求”正是指令微调和偏好训练长期奖励的行为。
8115 个问题从哪里来
XYBench 的 8115 个问题覆盖编程、系统管理、烹饪、家居维修、缝纫和宠物护理等技术与日常场景,其中既有真实社区问题,也有基于操作指南构造的合成问题。(arxiv.org)
| 数据来源 | 问题数量 | 内容特点 | 是否有人类参考答案 | |---|---:|---|---| | Stack Overflow | 1557 | 编程与软件工程中的真实 XY Problem | 有,最多保留 4 个社区答案 | | Stack Exchange | 184 | Unix、Ask Ubuntu、电子、家装等 17 个社区 | 有 | | 人工整理 | 102 | Reddit、论坛、聊天记录和研究者实际经历 | 有 | | WikiHow | 6272 | 从约 2500 篇操作指南中构造的日常问题 | 无 | | 合计 | 8115 | 技术与非技术场景 | 部分有 |
数据构建并不是简单地收集“问错的问题”。研究团队会为每个样本标注用户明确提出的请求、上下文中可以推断出的真实目标,以及一个合作式回答应该包含哪些内容。
**Stated Request(S-request)是用户字面上要求模型完成的任务。**例如“让糖霜更稠”或“用正则解析 XML”。
**Intended Request(I-request)是用户没有直接说出、但可以从上下文推断的真实目标。**例如“避免糖霜滑落”或“稳定提取 XML 数据”。
研究团队最初从 Stack Overflow 和 Stack Exchange 挖掘了 1994 个候选问题,再使用 GPT-5 进行筛选,剔除那些只回答字面请求就足以解决问题的案例,最终保留 1741 个。两名具备计算机背景的研究者抽查后,与自动筛选结果的平均一致率达到 93%。(arxiv.org)
WikiHow 部分则采用更复杂的合成流程。研究团队先让 Claude Sonnet 4.5 从操作步骤中寻找新手容易犯错的关键环节,再围绕错误操作生成看似合理、但已经预设错误方案的问题;随后通过三轮过滤补充上下文、删除过于明显的线索,并排除“直接回答也基本能解决问题”的弱样本。
这套构造方式有明显的人工设计痕迹,但比随机生成问答更接近真实误区。它不是故意把题目写得含糊,而是让错误方案听起来足够合理,迫使模型判断用户的前提是否成立。
XYBench 到底怎么打分
XYBench 不把回答压缩成一个简单的正确率,而是分别评估模型“说了什么”“重点放在哪里”以及“有没有指出误区”。
| 评测维度 | 定义 | 一个高质量回答应当怎样做 | |---|---|---| | S-solution | 是否回应用户的字面请求 | 说明原方案如何实施,或明确解释为什么不可行 | | I-solution | 是否给出面向真实目标的替代方案 | 推荐能真正解决根因的工具、步骤或路径 | | Pragmatic Emphasis | 回答重点放在 S 还是 I | 不能只在结尾随口提一句替代方案 | | Misconception Identification | 是否识别并纠正错误前提 | 解释原方案为什么偏离真实目标 | | Fully Pragmatic | 是否纠正误区、给出 I-solution,并以 I 为重点 | 直接把用户拉回正确的问题框架 | | Fully Cooperative | 是否同时处理 S 和 I,并解释两者关系 | 既回答用户,又避免机械反驳 |
**Pragmatic Response(务实回答)是以用户最终目标为中心、而非机械遵循字面请求的回答。**它不等于简单拒绝用户,也不意味着模型每次都要自作主张改写任务;更合理的方式是解释假设、指出风险,再提供一条更有效的路径。
评测采用 Claude Sonnet 4.5 作为自动裁判,将模型回答拆成多个建议单元,再判断每项建议属于字面方案、真实目标方案还是无关内容。研究团队用 500 条模型回答进行人工验证:在“回答是否包含某类方案”上,裁判与人工的一致率为 97.5%—100%;在“是否识别误区”上为 84.6%—93.3%;在“回答重点”上为 74.2%—79.8%。(huggingface.co)
这个一致率足以支持大规模比较,但也提醒我们,XYBench 并不是完全客观的单元测试。尤其是“回答重点”涉及语篇结构和语气判断,仍然比数学答案或代码测试更依赖裁判模型。
GPT-5 表现最好,但仍然更愿意顺着用户
XYBench 测试了 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro,主实验采用单轮对话,每个问题只生成一次回答。
Stack Overflow 子集最能体现模型在开发场景里的真实差异。下表中的“字面方案”和“真实方案”表示回答至少包含一次对应方案,“真实目标优先”表示整篇回答主要围绕 I-solution 组织。
| 模型 | 包含字面方案 | 包含真实方案 | 真实目标优先 | 识别错误前提 | |---|---:|---:|---:|---:| | Claude Sonnet 4.6 | 82% | 59% | 36% | 47% | | GPT-5 | 83% | 71% | 41% | 60% | | Gemini 3.1 Pro | 79% | 62% | 40% | 54% | | Qwen3.5-9B | 75% | 64% | 41% | 60% | | DeepSeek-V4 Pro | 86% | 66% | 35% | 55% | | 人类参考答案 | 58% | 67% | 55% | 79% |
结果不是“人类每项指标都更高”,而是人类更敢于放弃错误问题。人类参考答案只有 58% 会提供用户字面上要求的方案,低于所有模型;但有 55% 的人类回答把真实目标作为重点,模型最高只有 41%。人类识别错误前提的比例达到 79%,模型最高为 60%。(arxiv.org)
GPT-5 在 Stack Overflow 子集上是综合表现最好的模型,但它依然有 47% 的回答主要围绕字面方案展开。Qwen3.5-9B 的表现则比参数规模可能带来的直觉更亮眼:它在真实目标优先和误区识别两项指标上分别达到 41% 和 60%,与 GPT-5 持平,但字面方案覆盖率较低。
DeepSeek-V4 Pro 最能体现“高服从度不等于高帮助度”。它提供字面方案的比例达到 86%,为五个模型最高,但真实目标优先比例只有 35%,反而是五个模型最低。
模型知道哪个答案更好,却写不出来
XYBench 最有价值的发现,是揭示了模型“会判断”和“会生成”之间的明显断层。
研究团队把同一个问题的两种回答摆在模型面前:一种只处理字面请求,另一种会指出错误前提并解决真实目标。包括 GPT-4.1 在内的六个模型,有 71%—84% 的时候会选择后者更有帮助。
但让模型自己生成答案时,五个主测模型只有 35%—41% 的 Stack Overflow 回答真正以用户目标为重点。换句话说,模型在选择题里知道“应该劝用户换条路”,轮到自由回答时,却又习惯性地沿着用户指定的路线继续走。(huggingface.co)
这个差距说明,问题不只是模型没有识别意图。当前模型很可能已经在内部表示中捕捉到了更好的解决方案,但生成策略仍被“直接回答问题”“不要过度质疑用户”“尽可能满足指令”等训练偏好牵引。
研究团队还进行了一组 Oracle 实验,直接把字面请求和真实目标都告诉模型。Claude Sonnet 4.6 在 Stack Overflow 上给出真实目标方案的比例从 59% 上升到 67%,但识别并处理错误前提的比例反而从 47% 降至 34%。
这个反直觉结果很关键。即使模型已经知道用户真正想做什么,它也不一定会把两种目标之间的冲突讲清楚,更不一定会主动压低错误方案的优先级。意图识别只是第一步,如何把意图转化为回答结构,才是更难的问题。
这是比传统知识跑分更接近 Agent 的评测
XYBench 的实际意义并不在于再做一张模型排行榜,而在于把“帮助用户重新定义问题”变成可测量能力。
传统知识和推理基准通常默认题目本身成立。模型需要做的是找到答案、执行指令或完成推理链;即使是指令遵循评测,也往往把严格执行用户要求视为成功。XYBench 则反过来检查:当指令本身建立在错误假设上时,模型是否有能力不服从。
这项能力对 Agent 比普通聊天机器人更重要。聊天回答错了,用户可能只是浪费几分钟;能够操作代码、文件、浏览器或企业系统的 Agent 如果忠实执行错误路径,可能产生真实成本。一个自动化运维 Agent 不应该因为用户要求“不断扩大磁盘”就忽略日志无限增长,一个编程 Agent 也不应该在架构已经错位时继续生成数千行补丁。
XYBench 同样触及了 AI 产品中的一个长期矛盾:用户通常喜欢直接、肯定、立即可执行的回答,但真正专业的助手有时必须先说“你问的可能不是关键问题”。产品团队如果只优化即时满意度、点赞率和指令完成率,可能会把模型训练得越来越礼貌、越来越顺从,同时越来越不愿挑战用户的错误前提。
XYBench 仍有三块明显短板
XYBench 的第一块短板是数据分布偏向程序性问题。数据主要来自问答社区和操作指南,适合测试工具选择、故障排查与步骤错误,却不一定代表战略决策、医学沟通、复杂组织问题等更开放的误区。(arxiv.org)
XYBench 的第二块短板是 6272 条 WikiHow 问题属于合成数据。尽管团队加入了多轮过滤和人工抽查,合成问题仍可能带有 Claude Sonnet 4.5 的表达习惯,并让“真实目标”比自然对话更容易被某些模型识别。
XYBench 的第三块短板是目前只覆盖英语。不同语言对委婉表达、权威关系和反驳方式的接受程度差异很大;中文用户说“我想用 Excel 做一个数据库”,模型究竟应该直接教,还是先澄清数据规模和协作需求,也需要本地化语料才能公平评估。
因此,XYBench 更适合作为训练方法和回答策略的诊断工具,而不是决定“哪个模型最聪明”的终极榜单。开发者应该重点查看模型在哪类误区上失败、是否只是顺带提及替代方案,以及提示词或后训练能否改变回答重心,而不是只盯着一个总分。
我们的判断:AI 助手的下一步,是学会不照做
XYBench 是近期少数真正重新定义“模型有用性”的评测,因为它把帮助用户从错误路径中退出,视为与知识、推理和指令遵循同等重要的能力。
这套评测最值得产品团队借鉴的,不是 8115 条数据本身,而是它将回答拆成了三个阶段:先理解用户要求,再判断前提是否成立,最后围绕真实目标重新组织答案。当前主流模型通常能完成第一阶段,也可能在内部完成第二阶段,但第三阶段仍明显不足。
未来更好的 AI 助手不会逢错必反驳,也不会为了显得聪明而擅自改写用户目标。它应该能在“直接执行”和“重新确认问题”之间判断风险:低成本、可逆的任务可以先回答;高成本、不可逆或明显建立在错误前提上的任务,则应优先解释假设、提出澄清问题或给出替代路径。
从这个角度看,XYBench 测试的不是模型能不能多答一道题,而是它有没有资格成为真正的助手。一个只会完成 Y 的模型仍然是高级工具;一个能看见 X、解释 X 与 Y 的冲突,并帮助用户改变路线的模型,才开始接近专家。
参考来源
- Hugging Face:XYBench 官方发布文章 — Ai2 对数据构成、评测指标、主要实验结果和研究意义的介绍。
- GitHub:allenai/XYBench — XYBench 的评测代码、指标定义、运行参数与 Apache 2.0 代码许可证。
- Hugging Face:XYBench Dataset — 数据字段、子集说明、来源信息及 CC BY-NC-SA 3.0 数据许可证。
- Reddit:AllenAI 社区发布帖 — XYBench 发布及获得 EMNLP 2026 Best Resource Award 的社区信息。