Gnomon让Agent安全改数据库
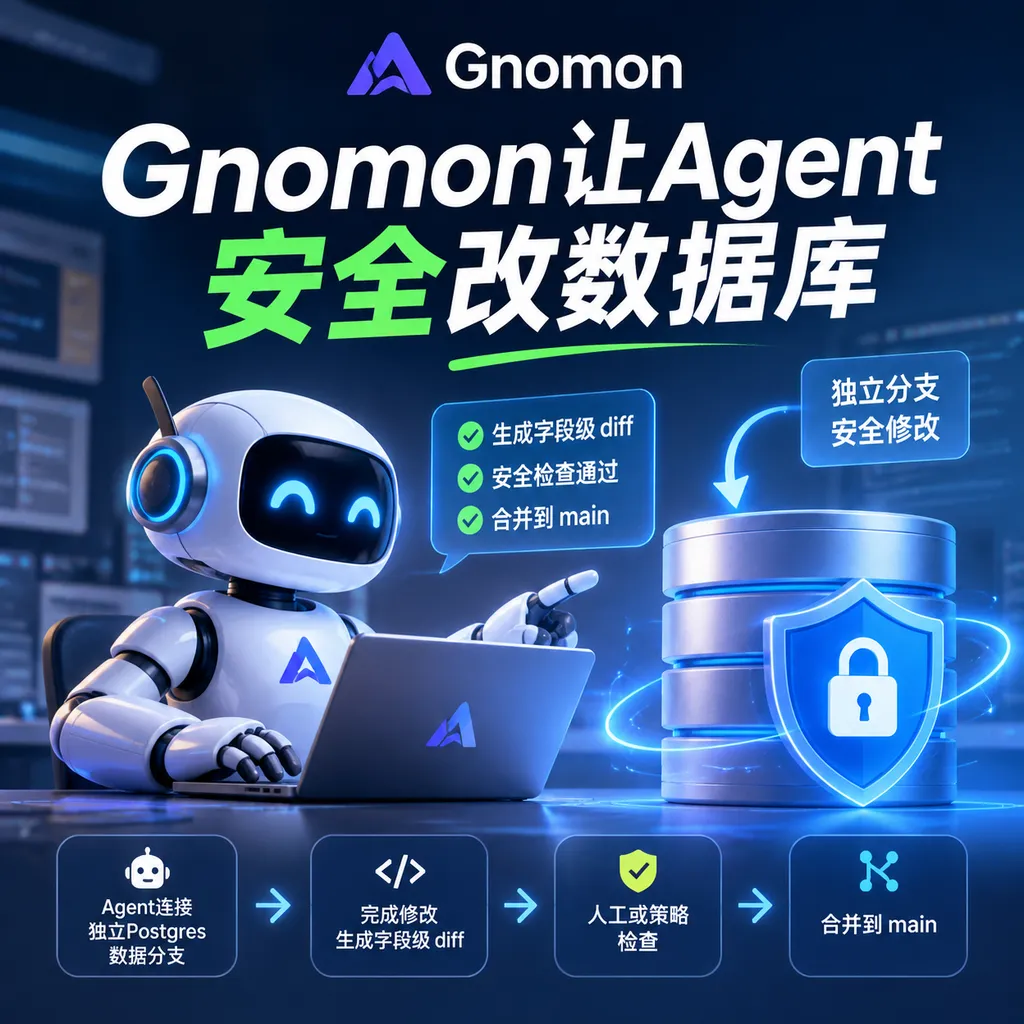
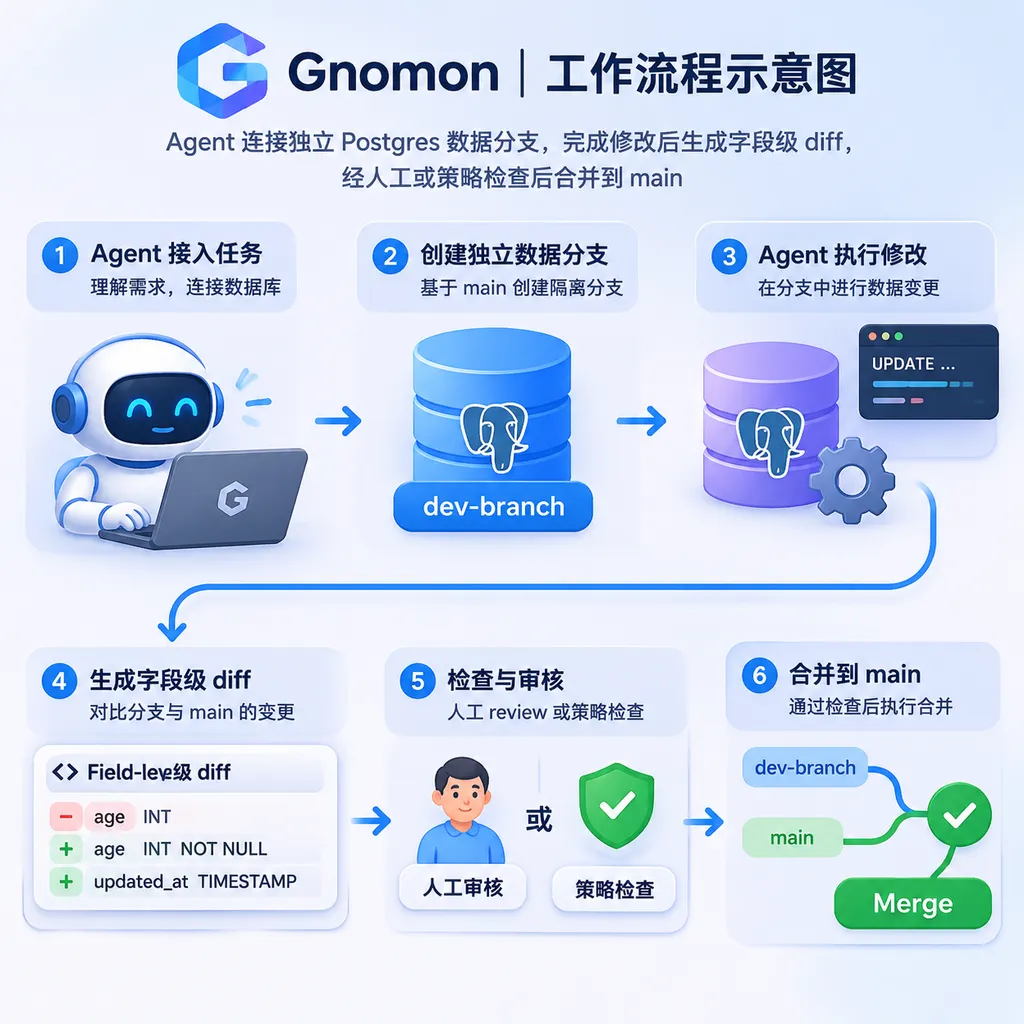
Gnomon把分支、差异审查、三方合并和撤销带进Postgres,试图解决AI Agent能写数据库、却难以审计和回滚的问题。
Gnomon让Agent安全改数据库
AI Agent终于可以拿到真实数据库的写权限了,但不是直接改生产主表。
截至2026年11月14日,Bits Infra公开了Gnomon 1.0.1。**Gnomon是一套运行在PostgreSQL内部的数据版本控制工具,为每次Agent任务创建独立数据分支,并提供diff、审查、三方合并、时间旅行和撤销能力。**项目支持PostgreSQL 15至18,采用PostgreSQL License开源,目前官方仓库显示约20个Star。(github.com)
它的产品定位可以概括成一句话:给Postgres数据加上类似Git的工作流,让Agent像提交代码一样提交数据变更。
这不是又一个帮Agent执行SQL的工具。让模型连接Postgres、查看表结构并执行查询,Agno、LangChain、MCP Server等方案早已能够做到;真正没有解决的是,Agent写错一条SQL之后,团队如何准确知道它改了什么、为什么改、能不能合并,以及如何把这次操作完整撤回。
Gnomon瞄准的正是这个缺口。
数据库写权限,正在成为Agent落地的高风险区
Agent数据库安全是指在允许AI系统读写业务数据时,仍能限制其影响范围、追踪操作过程,并可靠恢复错误变更。
过去一年的Agent产品大多停留在“读数据库”阶段:查询订单、生成报表、检索客户信息,风险相对可控。随着工具调用能力增强,新的需求开始出现——退款Agent要修改订单状态,运营Agent要批量调整价格,数据Agent要回填字段,编程Agent要执行数据库迁移。
问题在于,LLM生成SQL的错误往往不是语法错误,而是业务语义错误。
例如,一个退款Agent可能正确执行了UPDATE,却漏掉库存恢复;一个清洗Agent可能按错误条件更新了20万行;一个客服Agent可能根据过期数据,将已经结算的订单再次退款。传统数据库权限只能判断“这个角色是否有权更新orders表”,很难判断“这一次更新是否符合任务边界”。
常见的补救方法也不够理想:
- 开事务执行,确认后再提交,但长事务会占用连接和锁,难以覆盖跨小时任务;
- 复制一套测试数据库,但复制成本随数据量增长,测试数据也容易迅速过期;
- 依赖审计日志,但日志能告诉你执行过什么,未必能直接恢复字段级状态;
- 使用备份或PITR恢复,但它们面向灾难恢复,不适合只撤销某个Agent改动的17行数据;
- 在应用层拦截SQL,但Agent若能绕过应用、使用其他驱动连接,保护边界就会失效。
Gnomon的判断是:Agent的安全边界不应该只存在于Prompt、工具描述或应用代码中,而应该下沉到数据库本身。
Gnomon不是复制数据库,而是给变化建分支
Gnomon数据分支是从某个数据库历史坐标出发、只保存自身变更的数据视图。
启用Gnomon后,开发者需要先对指定表开启追踪。它会在表旁创建版本存储、路由视图和触发器,从启用时刻开始记录INSERT、UPDATE和DELETE,包括行主键、变化字段、操作者和事务位置。这个过程不回填历史数据,也不会复制现有表;原表名称、字段、索引和主库查询计划保持不变。(raw.githubusercontent.com)
当一个Agent获得自己的分支后,没有修改过的行仍然来自主分支;Agent修改过的行则进入分支自己的存储。如果主分支在分叉后更新了某一行,Gnomon会通过历史版本还原分支创建时的状态,避免Agent在任务过程中突然看到一套前后不一致的数据。
这种机制更接近“写时保存差异”,而不是克隆一个完整数据库。
官方基准测试中,创建单个分支耗时约0.13毫秒,连续创建10万个分支时平均约0.05毫秒;10万个打开的分支占用约53MB目录空间,且没有影响主分支的读写性能。这个结果意味着,理论上可以为每个Agent任务、每次测试甚至每个Pull Request单独创建分支,而不必等待数据库副本完成。(raw.githubusercontent.com)
| 方案 | 隔离粒度 | 创建成本 | 能否字段级审查 | 局部撤销 | 典型用途 | |---|---:|---:|---:|---:|---| | Gnomon数据分支 | 任务、Agent或测试 | 只保存变化数据 | 支持 | 支持 | Agent写操作、数据修复、测试 | | 完整数据库副本 | 数据库实例 | 与数据规模相关 | 通常不直接支持 | 依赖额外工具 | 集成测试、环境隔离 | | 数据库事务 | 单次连接或事务 | 低 | 有限 | 提交前可回滚 | 短时原子操作 | | 审计日志 | 操作记录 | 持续写入日志 | 可追踪但难审查 | 通常需手工反向操作 | 合规和事后调查 | | 备份与PITR | 整库时间点 | 存储和恢复成本较高 | 不支持 | 通常按实例恢复 | 灾难恢复 |
这里的关键不只是“便宜地开分支”,而是Agent不需要为Gnomon改写业务逻辑。对Agent来说,分支可以表现为一条普通的Postgres连接字符串,它继续通过psycopg、Prisma、Django ORM或node-postgres执行原有查询,实际读写路径由数据库内部完成路由。(raw.githubusercontent.com)
Diff解决的是“它到底改了什么”
数据Diff是对分支与基线之间行级、字段级变化的结构化比较。
传统SQL日志记录的是语句,例如“将符合条件的订单状态改为refunded”;Gnomon展示的是结果,例如哪些订单被修改、每个字段原值是什么、新值是什么。这种差异对Agent场景尤其重要,因为模型生成的SQL和SQL实际影响的数据并不是一回事。
一条看似合理的UPDATE可能因为WHERE条件错误而命中数千行。审查SQL只能看到意图,审查Diff才能看到后果。
Gnomon提供浏览器审查界面,审查者可以查看单行变化、对具体记录评论并处理冲突。团队还可以用SQL编写合并前检查,例如限制订单状态只能从paid变成refunded、退款金额不得超过付款金额,或者一次任务最多影响20行。
官方基准显示,在20万行表中对1000条变化生成Diff约需33毫秒,其成本主要随变化数量增长,而不是随整张表规模增长。(raw.githubusercontent.com)
这比让人类审查Agent的完整执行轨迹更实用。开发者真正需要确认的通常不是模型思考了多少步,而是最终哪些业务事实发生了改变。
三方合并比“覆盖主库”更像真正的版本控制
三方合并是同时比较分支当前值、分支起点值和主分支当前值,从而判断变更是否冲突的合并方式。
如果Agent修改了订单状态,而主分支只更新了物流备注,两边可以同时保留;如果Agent和人工客服都修改了同一个退款金额,系统则应产生冲突,而不是简单采用最后一次写入。
Gnomon把合并策略细化到列:
counter策略合并两边的增量,适合库存数量或计数器;jsonb策略按键合并JSON对象;set策略执行集合并集;text3策略按行合并文本;- 默认的
conflict策略拒绝猜测,将无法自动解决的变化写入冲突表。
这种设计比Git文本合并更懂数据类型。一个订单数量从10分别减到9和8,不能简单选择某一边;如果两次变化代表两笔销售,正确结果可能是7。Gnomon允许团队为这个字段指定计数器策略,通过两个分支相对基线的变化量计算结果。(raw.githubusercontent.com)
官方测试中,使用可选C模块时,向主分支合并5万条更新的速度约为每秒10.5万行,且不获取整张表的表级锁。这个数字足以覆盖大多数Agent操作和后台数据修复任务,但距离高吞吐实时写入场景仍需结合业务负载实测。(raw.githubusercontent.com)
真正有价值的是权限边界在Postgres里面
Agent约束角色是一个只能访问指定数据分支、无法直接修改主分支的Postgres登录角色。
Gnomon可以通过一条CLI命令,为Agent创建独立数据库角色、专属分支、连接字符串和MCP配置。即使Agent主动使用带schema的表名尝试访问主表,数据库也会拒绝;该角色也不能读取其他Agent分支,不能自行审批,更不能直接合并或撤销主分支数据。(raw.githubusercontent.com)
这比在系统提示词中写“不要修改生产数据”可靠得多。Prompt属于软约束,数据库权限属于硬约束;模型可以忽略前者,却无法说服Postgres绕过后者。
Gnomon还支持自动合并策略。团队可以规定某个Agent只能修改orders和refunds两张表、只能执行插入和更新、最多影响20行、只能在09:00至17:00操作,并要求它读取过的数据在主分支上没有发生新变化。策略会在合并时根据分支实际变化执行,而不是根据Agent声明的计划执行。
另一个值得注意的设计是held outbox。Agent触发的邮件、Webhook和支付等外部副作用可以先进入分支的待处理队列,只有合并成功后才真正发送。否则,即使数据库事务最终撤销,一封错误退款邮件或一笔外部支付也可能已经无法收回。(raw.githubusercontent.com)
这是Gnomon比普通数据库分支更贴近Agent的一点:它管理的不只是表数据,还试图管理Agent行动的发布时机。
时间旅行让Agent的决策可以复现
数据库坐标是精确描述某一时刻已提交事务集合的历史位置。
时间戳通常只能近似表达“当时”,而Gnomon坐标记录Agent每次读取所处的确切数据库状态。即使主库后来发生大量变化,开发者仍可以重新执行查询,获得Agent当时看到的相同数据。
这让Agent审计从“它声称当时看到了什么”变成“系统可以重新证明它当时看到了什么”。
Gnomon还会为每次工具调用保存参数、分支、读取坐标和结果摘要,并按运行生成哈希链。出现争议时,团队可以验证运行记录是否完整,或者回放Agent读取过的数据。对于退款、授信、库存和合规审核等高责任场景,这类能力比保存自然语言推理过程更有实际价值。(raw.githubusercontent.com)
当某项检查从通过变成失败时,gnomon bisect还可以查找最早破坏检查的事务,思路类似Git bisect,只不过定位对象从代码提交变成数据库事务。
性能代价不能忽略,官方数字也不能直接当生产承诺
数据版本控制开销是为每次数据库写入额外保存历史版本所产生的CPU、WAL和存储成本。
Gnomon不是没有代价。官方测试中,启用C触发器后,单行UPDATE的服务端CPU时间从10微秒增加到15微秒;单客户端吞吐从每秒5.26万次降至4.10万次,约保留原性能的77%。8客户端下,吞吐从每秒18.2万次降至13.9万次,约保留76%。(raw.githubusercontent.com)
每次写入产生的WAL从224字节增加到434字节,接近翻倍;每个历史版本还需要约141至147字节存储空间。对读多写少的Agent业务,这个成本可能完全可以接受;对高频交易、IoT事件流或大规模日志写入,额外WAL和历史存储会迅速变成容量问题。
| 官方测试项目 | 未追踪表 | Gnomon C模块 | 变化 | |---|---:|---:|---:| | 单行UPDATE,1客户端 | 52.6k TPS | 41.0k TPS | 吞吐下降约22% | | 单行UPDATE,8客户端 | 182k TPS | 139k TPS | 吞吐下降约24% | | 批量更新20万行 | 215ms | 609ms | 耗时约2.8倍 | | 每次写入WAL | 224字节 | 434字节 | 增加约94% | | 分支合并 | — | 105k行/秒 | 5万条更新测试 |
更重要的是,这组测试在Apple Silicon笔记本上的PostgreSQL 18.3中完成,并关闭了fsync和synchronous_commit。官方强调应重点观察同一轮测试中的相对比例,而不是绝对吞吐数字。换句话说,这些结果可以说明设计不是慢到不可用,但不能替代生产环境压测。(raw.githubusercontent.com)
它与Agent数据库工具不是同一类产品
Agent数据库工具负责让模型调用数据库,Gnomon负责控制这些调用产生的数据变化。
两者不是替代关系,而是上下层关系。MCP Server、Agent框架或ORM仍然负责向模型提供查询和执行能力;Gnomon位于Postgres内部,为这些操作增加分支、历史、权限和合并机制。
Gnomon已经提供MCP Server、TypeScript SDK、Python SDK、GitHub Action、dbt包和审查应用,也列出了对Node、Python、Ruby、Go、Java、Elixir、.NET、PHP、PostgREST和Supabase的集成。Agent可以使用OpenAI Agents SDK、Claude Agent SDK、LangChain、Vercel AI SDK或任意MCP客户端,而不需要绑定某个模型厂商。(raw.githubusercontent.com)
| 产品层级 | 主要问题 | 代表能力 | |---|---|---| | Agent框架 | 如何规划和调用工具 | 工作流、记忆、模型路由 | | MCP数据库工具 | 如何让Agent查询Postgres | Schema探索、SQL执行 | | ORM与数据库驱动 | 应用如何读写数据 | 连接池、查询、事务 | | Gnomon | Agent写完后如何隔离、审查和发布 | 分支、Diff、合并、撤销、回放 | | 备份与PITR | 数据库损坏后如何恢复 | 全局时间点恢复 |
Gnomon也不是向量数据库、Agent记忆框架或工作流编排器。它处理的是结构化业务数据的版本和发布,不负责决定Agent下一步做什么,也不负责替代对象存储、向量索引或模型服务。
一个方向正确、但验证远未结束的1.0产品
Gnomon当前最值得关注的价值,是把Agent写数据库从一次不可控执行,变成可审查的数据变更请求。
从产品方向看,它抓住了Agent进入生产系统后的核心矛盾:企业既希望Agent能真正完成任务,又不能把主数据库完全交给一个具有概率性的模型。只读Agent很好演示,却难以创造完整业务价值;直接写主库又很难通过安全和合规审查。数据分支提供了两者之间的中间层。
但Gnomon目前仍明显处于早期阶段。项目虽然已经使用1.0.1版本号,代码和文档覆盖面也相当大,但GitHub社区规模仍小,公开仓库提交历史有限,真实生产案例、长期升级稳定性、复杂RLS兼容性以及超大规模历史数据维护成本,都需要更多外部验证。(github.com)
安装门槛也不算低。Gnomon支持PostgreSQL 15至18,自管环境可以安装扩展和可选C模块;RDS、Aurora和Supabase需要通过pg_tle或纯SQL形式部署。C模块能提供更快写入、真实行锁、ON CONFLICT、TRUNCATE和过期读取检测,但需要配置shared_preload_libraries,这在部分托管数据库中并不可行。(github.com)
因此,Gnomon现阶段更适合三类团队:
- 已经使用Postgres,并准备让Agent执行退款、数据修复或运营操作;
- 需要大量并行数据库测试,但不想为每个测试复制数据库;
- 对Agent操作有人工审批、审计、回放和撤销要求。
如果Agent只做查询和报表,Gnomon可能过重;如果系统写入吞吐极高、数据主要是追加型事件,版本存储成本也可能超过收益。
Gnomon的意义不在于重新发明Git,而在于承认一个现实:当Agent开始修改真实世界,团队需要审查的“代码提交”会越来越少,审查的“状态变化”会越来越多。
代码可以重新部署,数据一旦改错,往往更难补救。Gnomon试图让数据库变化拥有分支、审批和撤销,这个方向值得重视。至于它能否成为Agent时代的基础设施,还要看接下来能否经受真实生产负载,而不只是跑通一套漂亮的退款演示。
参考来源
- Gnomon GitHub仓库:项目定位、源代码、功能列表与开源协议。
- Gnomon安装文档:PostgreSQL版本支持、1.0.1安装方式和托管数据库部署说明。
- Gnomon核心概念:追踪表、数据库坐标、分支、三方合并和Run模型。
- Gnomon Agent文档:Agent角色隔离、合并策略、回放和停止机制。
- Gnomon安全设计:数据库角色、RLS、权限边界和令牌机制。
- Gnomon性能测试:读写开销、分支创建、Diff、合并和WAL测试数据。