Lightreason开源,4090提速11倍
Lightreason 公开了单张 RTX 4090 加速 Qwen 的完整代码与测试记录,Qwen3.6-35B-A3B 实测从 7.93 提升至 51.08 tok/s。但“11 倍”来自另一条 3B 实验路线,并非所有结果都能直接复现。
11 月 13 日,开发者 me-farza 开源了 Lightreason,试图回答一个本地模型玩家最关心的问题:不更换 RTX 4090,也不把最终决策交给低精度量化模型,Qwen 的推理速度还能提高多少?
答案是,Qwen3.6-35B-A3B 在一项限长 Python 任务中从 7.93 tok/s 提升到 51.08 tok/s,达到 6.44 倍加速;另一条面向 3B 模型的实验路线,则出现了最高 11.39 倍的局部加速数字。(snslive.uk)
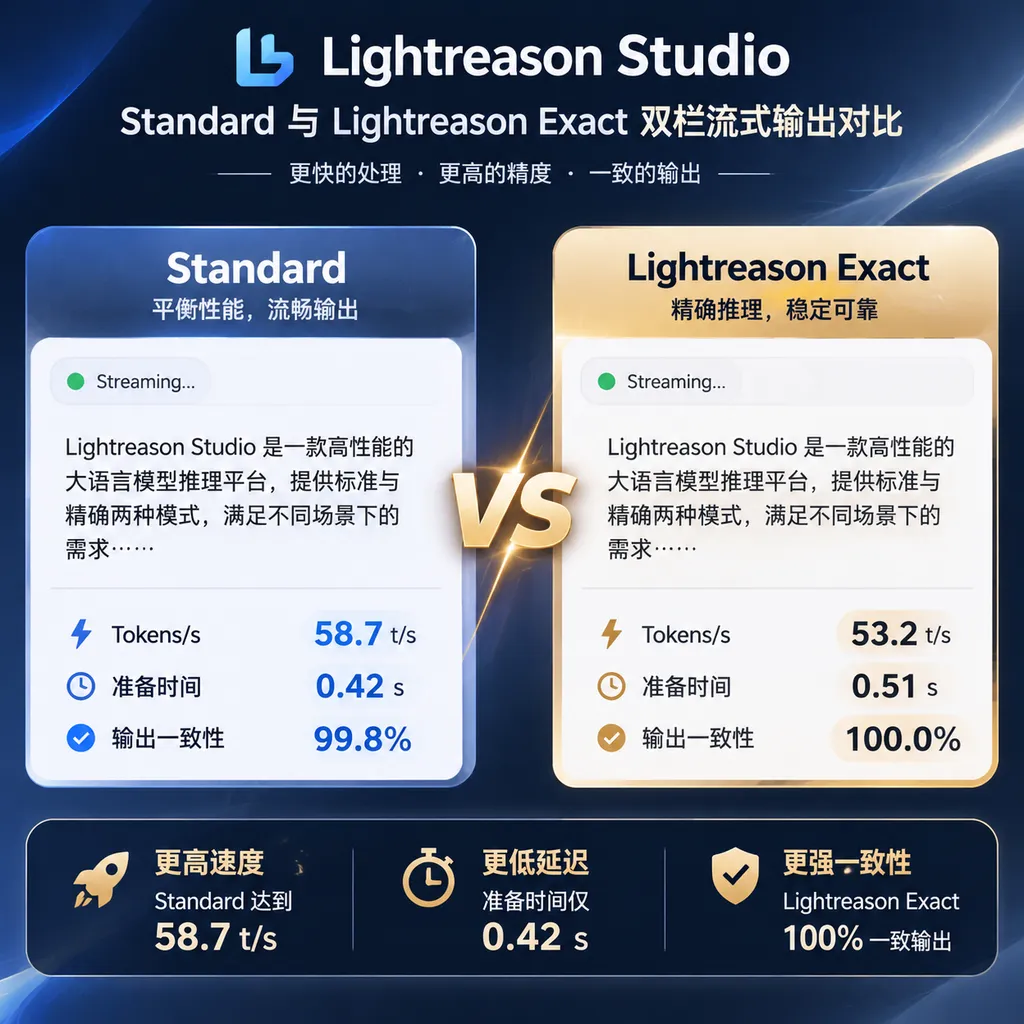
这不是又一个把模型压到 4-bit、然后展示 tokens/s 截图的项目。Lightreason 更接近一个公开的本地推理实验室:仓库同时提供运行代码、固定版本的下载清单、基准测试结果、输出一致性检查和失败实验记录,还附带一个可以并排比较 Standard 与 Lightreason Exact 的交互式 Studio。
**Lightreason 是一套针对消费级 NVIDIA GPU 优化 Qwen 推理过程的开源实验框架。**它没有训练新的 Qwen 主模型,而是围绕 CUDA 执行、KV 缓存、词表计算、推测解码和 MoE 权重搬运重新组织推理流程。
先说结论:6 倍是真的,11 倍需要加注释
Lightreason 最值得肯定的地方,是仓库没有把所有测试结果揉成一个“最高提速 11 倍”的营销数字。不同结果对应不同模型、执行器和输出一致性标准,必须拆开看。
| 测试路线 | 基线速度 | 优化后速度 | 加速倍数 | 输出与复现情况 | |---|---:|---:|---:|---| | Qwen2.5-3B Standard → Exact,六个提示词平均 | 63.0 tok/s | 139.6 tok/s | 2.22× | 30 次 Hugging Face 计时运行一致;9/9 组代码回答完全匹配 | | 3B PARD2,完整天气回答 | 58.3 tok/s | 525.2 tok/s | 9.01× | 完整回答匹配,但需要未随仓库发布的实验室适配器 | | 3B PARD2,Fibonacci 最佳 128-token 片段 | 63.6 tok/s | 724.4 tok/s | 11.39× | 属于最佳局部片段,不代表完整请求平均速度 | | Qwen3.6-35B-A3B,限长 Python 提示词 | 7.93 tok/s | 51.08 tok/s | 6.44× | 使用相同输入跨会话比较;与 Scheduled 路线首次在第 116 个 token 分歧 |
**“Qwen3.6 在 RTX 4090 上提速 6—11 倍”并不是严格意义上的同一组对照实验。**其中 6.44 倍来自 Qwen3.6-35B-A3B,而 9—11 倍来自 Qwen2.5-3B-Instruct 的 PARD2 实验路线;后者的峰值还依赖一个没有包含在公开仓库里的 LoRA/projector 适配器。(snslive.uk)
因此,如果只看当前公开代码和公开模型能够较完整复现的部分,更稳妥的标题数字应该是:3B 模型约 2.2 倍,35B MoE 模型约 6.4 倍。11.39 倍可以作为研究峰值,但不能当成安装仓库后必然得到的性能。
为什么 4090 跑 35B,瓶颈不是算力
**Qwen3.6-35B-A3B 是一个总参数约 35B、每个 token 激活约 3B 参数的混合专家模型。**根据 Qwen 官方模型卡,它包含 256 个路由专家,每次选择 8 个专家,同时还有一个共享专家;模型共有 40 层,原生上下文长度为 262,144 tokens。(huggingface.co)
这类 MoE 模型有一个很适合消费级硬件的特点:虽然全部权重很大,但每生成一个 token,并不需要让所有专家同时参与计算。问题在于,即使专家不参与当前 token,它们的权重依然需要存放在某处。
Lightreason 记录的 Qwen3.6 文本权重占用约为 64.56 GiB,而 RTX 4090 只有 24GB 显存。把 BF16 权重完整塞入显卡显然不可能;如果每一步都临时从系统内存搬运专家权重,PCIe 传输又会把 GPU 变成等待数据的昂贵摆设。
**MoE 权重卸载是把大部分专家权重保存在系统内存,只将当前计算真正需要的专家送入 GPU。**它的优势是能用较小显存运行大模型,代价是推理速度会高度依赖内存带宽、PCIe 传输、专家命中率以及权重缓存策略。
Lightreason 的 35B 路线建立在 FreeToken 和 Inco AI 的 DFlash2 之上。FreeToken 提供面向 MoE 的 CPU/GPU 混合执行能力,DFlash2 提供并行草稿模型,Lightreason 再针对 Qwen3.6 增加选定行预填充、重复专家路径的 AVX2 复用、CUDA 原生解包、34 层 packed host banks,以及无损 GPU 专家副本层。(github.com)
这套设计的核心不是“让 4090 算得更快”,而是“尽量少搬一次权重,并让搬过来的权重多做几次有效计算”。对于 64.56 GiB 的 BF16 模型,减少一次无效传输,往往比优化一个矩阵乘内核更值钱。
推测解码为什么能带来 6 倍加速
**推测解码是一种由小型草稿模型先生成多个候选 token,再由原始目标模型批量验证的推理技术。**只要验证规则正确,最终 token 仍由目标模型决定,草稿模型只负责“猜题”,不能直接修改答案。
传统自回归生成像是每写一个字,都要把整套专家权重重新翻一遍。推测解码则像是草稿模型先写出一小段,目标模型一次检查多个 token;如果多个候选被接受,目标模型就能用一次或少数几次权重加载,推进多个生成位置。
这种收益在 MoE 权重卸载场景下尤其明显。假设连续几个 token 选择了部分相同的专家,Lightreason 就可以复用已经送到 CPU 缓存或 GPU 的专家权重,而不是为每个 token 重复进行相同的数据搬运。
Lightreason 使用的目标模型仍是原始 BF16 Qwen,专家计算前还会重建原始 BF16 位模式。换句话说,它不是通过把 Qwen3.6 主模型压成 2-bit 或 4-bit 来换速度,而是在执行层减少浪费。
这也解释了为什么它不一定能在纯 tokens/s 上击败所有 GGUF 量化方案。激进量化可以直接减少一半甚至更多的权重读取量,而 Lightreason 选择保留 BF16 目标模型,优化目标更接近“在保持原始目标模型决策的前提下,把 4090 和系统内存榨干”。
3B Exact 路线更像一套可落地优化
**Lightreason Exact 是不依赖额外草稿适配器、直接优化目标模型执行过程的运行模式。**在 Qwen2.5-3B-Instruct 上,它把六个提示词的平均速度从 63.0 tok/s 提升到 139.6 tok/s,约为原来的 2.22 倍。
这条路线的技术组合没有 724 tok/s 那么夸张,但更值得普通开发者关注:
- CUDA Graphs 记录并重放重复的 GPU 工作,减少 Python 调度和 kernel launch 开销;
- 紧凑 KV 缓存降低注意力状态的显存占用和访存压力;
- BF16 投影融合减少中间结果写回与重复 kernel 调用;
- 词表候选预筛选先缩小候选范围,再使用原始输出权重精确打分;
- Studio 将图编译准备时间与正式生成时间分开统计,避免用热启动成绩冒充首次运行体验。
**CUDA Graph 是把一串稳定的 GPU 操作预先录制下来,之后以更低调度成本重复执行的 CUDA 机制。**它适合形状相对固定、调用频繁的解码阶段,却不适合直接套在所有动态请求上,因此 Lightreason 使用 bucketed 方式为不同输入形状准备执行路径。
仓库报告称,LR CUDA Graph 与紧凑 KV 路线在 30 次 Hugging Face 对照计时中保持匹配;Python、JavaScript 和 SQL 三类完整回答也在 9/9 新测试对中一致。对需要确定性回归测试的开发者来说,这组数字比单个峰值速度更有意义。
11 倍路线的真正限制是草稿模型
**PARD2 是一种让多个草稿分支并行预测候选 token 的推测解码方法。**相比单链草稿,它可以一次探索多条可能路径,再让目标模型批量验证,从而提高一次验证能够接受的 token 数量。
Lightreason 的 PARD2 路线确实展示了非常激进的结果:完整天气回答从 58.3 提升到 525.2 tok/s,Fibonacci 测试的最佳 128-token 片段则从 63.6 提升到 724.4 tok/s。
但这组结果目前不能被视为完全开箱即用。仓库虽然提供了 AMD 的公开 PARD2 草稿目录和 tokenizer 接入方式,却明确说明峰值结果还需要一个单独提供的实验室 LoRA/projector checkpoint;这个适配器没有包含在本次源码发布中。AMD PARD 项目可以解释技术原理,却不能替代 Lightreason 测试所用的配套权重。
局部片段速度也不能直接等价于完整交互速度。Fibonacci 等高度规律的序列很容易被草稿模型连续命中,候选 token 接受率会明显高于真实代码修改、开放式写作和复杂推理任务;一旦草稿频繁猜错,验证成本仍然存在,加速比会迅速下降。
所以,11.39 倍说明这条技术路线的上限很高,却不能证明任意 Qwen 请求都能达到 700 tok/s。开发者真正应该记录的是整段请求平均速度、首 token 延迟、草稿接受率、图准备时间和最终输出一致性,而不是截取最快的 128 个 token。
输出一致性比跑分更复杂
**无损推理优化应该保证最终输出仍由原始目标模型控制,但这不意味着不同执行路线一定逐 token 相同。**采样随机数、浮点计算顺序、批量验证方式和候选接受策略,都可能让生成序列在某个位置开始分叉。
Lightreason 对这些差异没有回避。35B 的 6.44 倍对比使用相同输入跨会话测量,但 Packed 输出与 Scheduled 输出在第 116 个 token 首次不同;另一方面,Packed 配置对更接近自身执行方式的固定八位置控制组完成了 20/20 配对匹配。
3B 草稿辅助运行器在 36 组保留测试上,比前一版草稿辅助运行器快 1.062 倍,并与前一版保持相同输出,但只在 12/36 测试中与 Hugging Face 参考实现完全一致。
这不是简单的“质量下降”,而是提醒开发者必须先定义自己所说的一致性:
- 最终答案语义相同;
- 完整文本字符相同;
- token ID 序列相同;
- 在随机采样下保持相同概率分布;
- greedy decoding 下逐 token 完全一致。
如果模型用于聊天或本地编码助手,语义一致通常已经足够;如果模型用于评测、回归测试、生成结构化补丁或复现实验,token 级差异就必须被记录。
Lightreason 好用吗?
**Lightreason 更适合愿意调试推理栈的开发者,而不是想双击安装的普通用户。**公开的 3B Studio 快速开始要求 Linux、RTX 4090、兼容 CUDA 12.8 的驱动、Python 3.12、PyTorch 2.9.1 和 Transformers 4.57.1;35B 路线还需要更大的系统内存,并涉及 Triton 编译和单独的模型下载。
项目目前也不是 vLLM 或 llama.cpp 的直接替代品。它更像一组针对特定模型和硬件验证过的优化配方:你可以研究其中的 CUDA Graph、KV 布局、专家缓存和推测解码策略,也可以沿着仓库提供的硬件移植指南适配其他 GPU,但不能假设换成 RTX 3090、5090 或不同 CPU 后仍有相同提升。
Lightreason 的真正价值是把本地推理优化从“玄学参数分享”变成了可检查的工程过程。仓库不仅记录成功实验,也记录变慢、输出变化和无法公开复现的部分;这比只发布一张 724 tok/s 截图靠谱得多。
对于 RTX 4090 用户,我的建议很直接:如果只是需要一个快速本地编码模型,成熟的 GGUF、AWQ、MTP 或现成服务框架仍然更省时间;如果需要研究 BF16 MoE 如何在有限显存上运行,或者希望理解 CPU、RAM、PCIe 与 GPU 之间的真实瓶颈,Lightreason 值得完整读一遍。
这次开源留下的三个判断
**第一个判断是,消费级大模型推理正在从“显存容量问题”转向“数据调度问题”。**Qwen3.6-35B-A3B 每个 token 只激活约 3B 参数,使 24GB 显卡具备运行 35B BF16 目标模型的理论空间,但前提是专家搬运和缓存足够聪明。
**第二个判断是,推测解码的收益越来越依赖任务,而不是只依赖硬件。**高度规律文本可能出现 10 倍以上加速,真实代码任务则取决于草稿模型能否猜中目标模型;未来的竞争重点会从“每秒算多少”转向“每次验证能接受多少 token”。
**第三个判断是,开源推理项目必须把可复现结果与研究峰值分开。**Lightreason 的 6.44 倍 35B 结果有明确输入、速度和输出差异记录,而 11.39 倍结果缺少公开适配器;两者都值得关注,但可信度和使用方式并不相同。
Lightreason 还不是一套可以直接进入生产环境的通用服务框架,但它已经证明了一件事:RTX 4090 的 24GB 显存不是本地运行大 MoE 的绝对天花板。真正的天花板,是你能否让模型少搬权重、多验证 token,并且清楚知道每一次优化改变了什么。
参考来源
- Lightreason GitHub 仓库:项目源码、基准测试、Studio、实验历史及复现说明。
- Qwen3.6-35B-A3B 模型页:Qwen 官方模型架构、参数规模、上下文长度与许可证信息。
- Qwen3.6-35B-A3B 配置文件:40 层、256 个专家、每 token 激活 8 个路由专家等精确配置。
- FreeToken GitHub 仓库:Lightreason 35B 路线所依赖的 MoE CPU/GPU 混合执行引擎。
- AMD PARD GitHub 仓库:并行草稿模型与推测解码方法的开源实现。
- Inco AI DFlash2 模型集合:Lightreason 35B 路线所使用的并行草稿模型相关资源。