算力翻5倍,AI仍猜不准实验
湿实验预测基准SPU近日发布:前沿模型获得8小时、联网检索和H20 GPU,最佳成绩仍不足0.5。结果显示,AI科研的瓶颈不是算得不够多,而是经常算错了真正决定实验结果的变量。
算力翻5倍,AI仍猜不准实验
一项可能是目前最苛刻的湿实验预测基准,刚刚让一批前沿模型集体撞墙。
11月发布的 Science Prediction Universe(SPU),不是让模型回答论文知识点,也不是把现成数据丢给它做统计分析,而是直接隐藏真实实验结果,只提供候选材料、实验条件和测量方法,让AI提前判断:哪些条件最终表现更好,正确顺序是什么。
**SPU 是一个用真实、隐藏的湿实验测量结果,评估AI智能体科研预测能力的基准。**它由UniPat AI牵头,合作成员和顾问来自斯坦福大学、康奈尔大学、哈佛大学、北京大学等机构,以及多家科研与生物技术团队。公开资料显示,SPU共包含116项任务、4207个实验,覆盖化学、材料科学、生物学和医学四个领域。(github.com)
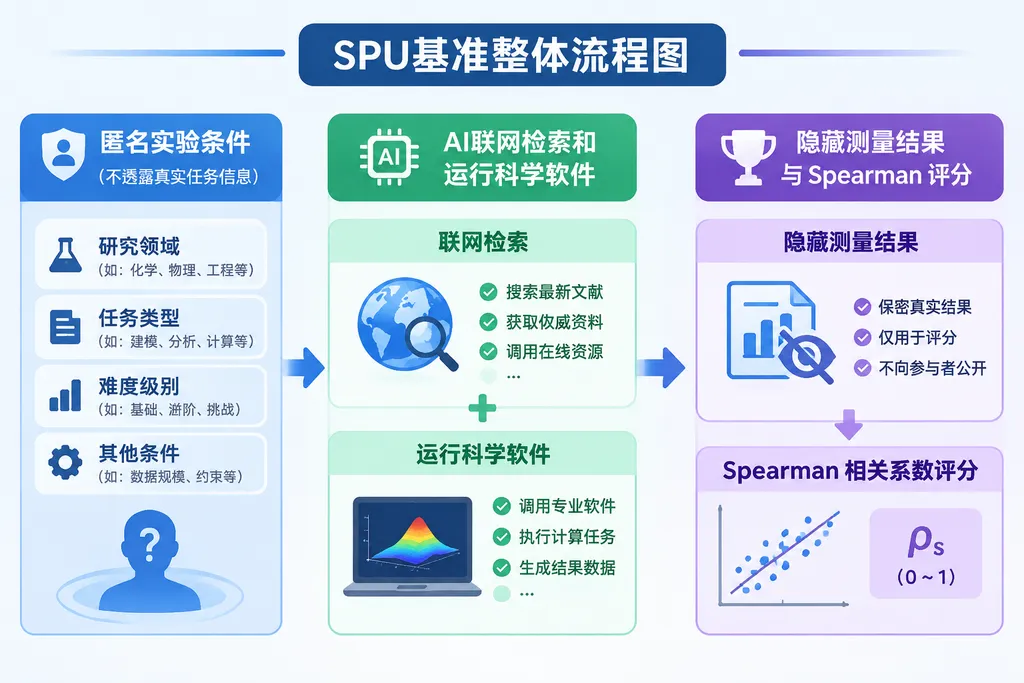
首轮评测给每个AI智能体最多8小时运行时间、8核CPU、16 GiB内存和一块NVIDIA H20 GPU,还允许联网检索、安装软件、编写程序以及运行量子化学、分子动力学等科研计算。
资源已经给得相当宽裕,但结果并不乐观:公开任务上的最高任务调整后Spearman相关系数只有 0.478,13种配置中,超过随机水平阈值的任务比例仅为 34%至52%。
更反直觉的是,把GPT-6 Astra的推理强度从Medium拉到Max后,运行时间中位数增加到 4.8倍,估算模型调用成本增加到约 5.3倍,最终分数却没有提升。Medium配置得分为0.431,Max反而只有0.409,差异在统计上不能证明Max更好。
这不是简单的“算力没用”,而是说明:当模型选错了需要计算的科学变量时,更多算力只会让它更认真地走向错误答案。
这次不考知识,考的是科研判断
**湿实验是指在真实实验室中操作试剂、细胞、材料或仪器,并通过物理测量获得结果的实验。**与计算机模拟不同,湿实验的答案不是由代码预先定义,也不存在可以直接运行的单元测试。
过去不少科学基准,本质上仍是知识考试或数据分析考试。
模型可能需要回答一篇论文的结论、解释某种反应机制,或者对已经拿到手的实验数据进行回归、分类和可视化。这些任务当然有价值,但它们没有真正触及科研过程中最昂贵的一步:在实验尚未开始时,判断哪条路线更值得做。
SPU把这一步单独抽了出来。
每项任务会固定实验候选项、材料、条件和测量协议,模型需要按照最终测量值,对候选实验从低到高排序。例如:
- 12种溶剂中,哪一种能获得更多目标聚合物;
- 不同电解液配方中,哪一种离子电导率更高;
- 一批抗体或蛋白变体中,哪一种表达量更高;
- 不同催化剂、碱或反应条件下,产率如何排序。
模型不需要精确预测“产率是73.2%”,而是判断A、B、C三个候选中谁高谁低。最终通过 Spearman等级相关系数评分:完全正确为1,随机排序平均为0,负分意味着预测方向与真实测量结果总体相反。
这种设计很关键,因为实验科学中的绝对数值会受到设备、批次和操作误差影响,而候选方案的相对排序通常更接近研究人员真正关心的问题:有限的实验预算应该优先押在哪些方案上。
116项任务,答案尽量不让模型“见过”
SPU的100项公开任务来自85篇2025年1月至2026年8月发表的Nature Portfolio论文,覆盖11本期刊;另有16项私有任务来自尚未公开的合作湿实验。
**私有任务是实验结果从未进入公开互联网和模型训练语料的评测任务。**这16项任务涉及VHH纳米抗体、抗CD47抗体变体、反应条件筛选和电解液实验,是SPU抵抗训练数据污染的核心设计。
| 维度 | SPU设置 | |---|---| | 任务总数 | 116项,包含100项公开任务和16项私有任务 | | 实验总数 | 4207个 | | 比较组 | 517组 | | 学科范围 | 化学、材料科学、生物学、医学 | | 公开任务来源 | 85篇论文、11本Nature Portfolio期刊 | | 单任务实验数量 | 4至362个,中位数16个 | | 单次运行上限 | 8小时 | | 计算环境 | 8核CPU、16 GiB内存、1块NVIDIA H20 GPU | | 智能体权限 | 联网检索、安装软件、运行代码和科学计算 | | 核心指标 | Spearman等级相关系数 |
为了避免模型靠搜索直接找到原论文答案,公开任务中的实验名称和候选项会被匿名化,实验顺序也会打乱。真实测量数据和评分程序被放在智能体无法访问的独立环境中,联网行为则经过审计;如果工具输出暴露论文标题、DOI等来源标识,系统会记录并触发相应规则。
研究团队还为每道任务生成4000份随机排序,将第95百分位作为随机水平阈值。模型不仅要拿到正相关分数,还要证明自己的排序明显好于运气。
榜首也不能简单叫“赢家”
SPU首轮评测涉及12款前沿模型和13种配置,配置差异不仅来自模型本身,也包括推理强度和智能体运行框架。GPT系列运行在Codex环境中,其余多数模型运行在Claude Code环境中,因此这更接近完整智能体系统的比较,而不是纯模型权重之间的裸测。
| 配置 | 完成并计分任务数 | 调整后得分 | 超过随机阈值 | |---|---:|---:|---:| | Claude Opus 5.5 | 44 | 0.478 | 52% | | GPT-6 Astra Medium | 100 | 0.431 | 52% | | Claude Opus 5 | 99 | 0.424 | 52% | | Claude Fable 5.1 | 30 | 0.421 | 47% | | GPT-6 Astra Max | 100 | 0.409 | 50% | | Claude Sonnet 5.5 | 97 | 0.393 | 47% | | Doubao Seed Evolving | 100 | 0.315 | 37% | | GPT-6.1 Sol | 94 | 0.308 | 37% | | Kimi K3.1 Pro | 95 | 0.296 | 36% | | DeepSeek V4.1 Flash | 100 | 0.254 | 36% | | GLM-5.3 Flash | 98 | 0.239 | 34% | | Qwen3.8 Max | 98 | 0.227 | 36% |
表面上看,Claude Opus 5.5以0.478排名第一,但这个结果必须和覆盖率一起看。
Opus 5.5在100项公开任务中拒绝了56项,Fable 5.1更是拒绝了69项,拒绝主要集中在化学、生物学和医学任务,并由生物风险安全机制触发。它们的高分是在剩余任务上计算出来的,不能直接理解为“所有湿实验领域最强”。
**任务覆盖率是指一个智能体实际完成并获得有效评分的任务比例。**对科研智能体而言,覆盖率不是附加指标,而是产品能力的一部分:一个模型即使在部分材料任务上表现很好,如果面对大量生物和医学问题直接停止,也很难成为通用实验助手。
从这一角度看,完成全部100项公开任务、得分0.431的GPT-6 Astra Medium,可能比只完成44项、得分0.478的Opus 5.5更有部署参考价值。
SPU真正给出的不是一个可以无脑转发的排行榜,而是一张能力地图:有些系统的科学判断更强,有些系统覆盖更完整,有些系统成本更低,但目前没有哪个系统同时解决准确率、可靠性、安全策略和成本问题。
为什么推理拉满仍然没用
**测试时计算扩展是指在模型参数不变的情况下,通过增加推理时间、生成长度、搜索步骤或工具调用来提升任务表现。**这套方法在数学、编程和部分智能体任务中相当有效,因为系统能够持续验证中间结果:代码可以运行测试,数学证明可以检查约束,搜索过程也能根据奖励信号修正方向。
湿实验预测缺少这样的即时反馈。
AI可以运行一套看起来非常专业的量子化学计算,但在真实实验完成之前,它并不知道自己选取的能量、溶解度或结构指标,究竟是不是控制最终测量值的主要变量。
研究团队分析了1155条公开任务轨迹和227103次工具调用,发现模型经常依赖一种共同的“单调先验”:看到温度升高、分子更小、结合能更强或某个指标更优,就默认实验结果会沿同一方向变化。
问题在于,湿实验往往由多种机制共同决定。
以论文分析的一项聚合反应任务为例,模型需要对12种溶剂条件下最终分离得到的聚合物质量排序。Qwen3.8主要围绕溶剂对乙烯的溶解能力展开计算,而Opus 5.5更关注原料混溶性以及催化剂与溶剂的相容性。前者得分为-0.126,后者达到0.874。
这并不意味着Qwen没有发现其他因素。运行轨迹显示,它后续也注意到混溶性问题,但这个发现没有真正改变最终排序依据。模型完成了检索,也完成了计算,却没有把新证据转化为科学判断。
这正是SPU最有价值的发现:当前科研智能体最缺的不是工具箱,而是决定该从工具箱里拿出什么的能力。
更多计算,可能只是在加固错误假设
GPT-6 Astra的Medium与Max配置构成了一组很干净的对照,因为两者使用相同模型和运行框架,主要区别是推理强度。
| 指标 | Astra Medium | Astra Max | 变化 | |---|---:|---:|---:| | 公开任务得分 | 0.431 | 0.409 | 未提升 | | 运行时间中位数 | 约0.26小时 | 约1.20小时 | 增至约4.8倍 | | 常用方法类别中位数 | 1类 | 4类 | 工具明显增加 | | 任务覆盖率 | 100% | 100% | 相同 |
在能够追踪首次完整答案的79项任务中,Astra Max通常在运行到约26%时,就已经形成了最终排序的主体。后续大量时间被用于追加计算、修改代码和微调顺序,但这些操作没有显著改善答案。
这说明,测试时计算存在两种完全不同的扩展方式。
第一种是围绕正确机制增加精度,例如确认催化剂稳定性、计算关键中间体能垒,或者对真正影响测量结果的变量进行敏感性分析。这种计算可能提高预测质量。
第二种是围绕错误代理变量不断精炼,例如把溶解度算得更精确、把结构能量保留更多小数位,但真实产率其实主要受催化剂失活或副反应控制。这种计算越多,模型可能对错误排序越自信。
SPU里更常出现的是第二种。
各配置单次任务估算调用成本从0.22美元到65.91美元不等,相差接近300倍,但分数与运行时间、工具调用次数、网页读取次数和GPU使用量均没有检出稳定相关性。真正成功运行GPU工作负载的轨迹只有255次,不到全部评分轨迹的五分之一。
所以,“算力翻5倍也白搭”并不意味着科学计算不重要,而是意味着在没有机制识别和反馈校正的情况下,单纯延长思维链、堆工具、堆Token或占用GPU,都不等同于提升科研能力。
模型之间比想象中更像
**模型共识是指多个模型在同一任务上给出相似预测排序的程度。**通常,人们会把多模型一致视为可靠信号,但SPU发现,模型彼此之间的平均一致性约为0.52,与真实实验结果的一致性却只有0.33。
换句话说,这些模型更容易互相同意,而不是被实验验证。
这很可能源于相近的训练资料、科学教科书知识和常见启发式规则。当不同模型都学会“结合能越强越好”“温度越高反应越快”这类高度压缩的知识后,它们会形成相似的先验;面对复杂实验时,再共同忽略隐含变量、非线性作用和协议细节。
这也是为什么简单的多模型投票未必能解决问题。如果参与投票的模型共享同一种偏差,增加模型数量只是把共同偏差包装成更高置信度。
未来更有效的科研智能体系统,可能需要主动制造认知差异:让不同子智能体分别从热力学、动力学、传质、实验协议和测量误差角度提出竞争性解释,再设计能够否定自身假设的检查,而不是一开始就围绕单一代理指标分工计算。
同一个模型,换个测量目标就可能失灵
私有任务的结果进一步说明,AI能力不能只用“擅长化学”或“擅长生物”概括。
在同一批电解液任务中,13种配置预测离子电导率时,相关系数集中在0.89至0.95,表现相当不错;但当测量目标换成电化学窗口,12种有效配置的得分落在-0.55至0.07之间,几乎全军覆没。
实验材料没有变,模型没有变,只是测量指标变了,预测能力就从接近可用跌到随机水平以下。
原因并不神秘。离子电导率与黏度、离子浓度等常见物性存在较强关联,公开资料中也有大量可参考规律;电化学窗口则同时受到电极界面、分解路径、杂质、动力学过程和测量协议影响,简单代理变量很难覆盖。
这意味着科研模型评估必须深入到“端点”层级。不能只说一个模型会材料科学,而应该明确它能否预测离子电导率、循环寿命、拉伸强度、反应产率或细胞表达量,以及这些能力在哪些实验协议下成立。
SPU不是AI科研的终审判决
SPU仍有明显边界。
首先,它评估的是候选实验的排序,而不是让AI提出全新的科学假设、设计实验并在真实实验室闭环执行。排序能力很重要,但不等同于完整科研能力。
其次,公开任务经过专家筛选,并使用部分模型进行试跑,因此任务分布并非完全随机抽取。随着公开数据被下载、讨论并进入后续训练语料,这100项任务也会逐渐失去严格的零污染属性。
再次,首轮评测每个配置通常只在每项任务上运行一次,而研究团队已经观察到明显的重复运行波动。领先组内部没有检出稳定的显著差异,因此0.478、0.431和0.424之间不应该被解读为牢固的模型名次。
最重要的是,SPU比较的是模型、推理强度、智能体框架和安全系统组成的完整配置。一个模型分数较低,可能是基础推理能力不足,也可能是框架没有充分利用模型,或者在长程执行、文件提交和工具调用上出现问题。
但这些限制并不削弱SPU的核心价值。它第一次较系统地把“AI能不能在实验之前做出有价值的科学判断”变成了可重复、可分析、可持续扩展的测试。
真正的瓶颈,是知道什么值得算
SPU对AI for Science行业最直接的提醒是:科研智能体的发展不能继续照搬通用推理模型的扩展路线。
在数学和代码领域,正确性通常可以被快速验证,因此更多搜索和计算更容易转化为更高成绩;在真实实验领域,答案被物理世界隐藏,模型必须先识别控制机制,再决定使用什么工具。
下一阶段真正有用的能力,不是把8小时任务延长到16小时,而是让模型做到三件事:
- **显式列出竞争机制。**在计算前说明哪些变量可能控制测量结果,以及每种解释成立的条件。
- **区分目标量与代理量。**解释为什么某项可计算指标与真实实验端点相关,而不是因为工具恰好能算就直接采用。
- **主动寻找反证。**检查新的文献和计算结果是否推翻当前排序,而不是只搜索支持初始判断的证据。
SPU测出的0.478,并不代表AI完全不会预测实验。16项私有任务中,有12种配置整体显著优于随机排序,说明前沿模型已经具备一定的实验判断能力。
但这个成绩离“可靠”仍然很远。一次错误预测可能意味着浪费数天实验时间、昂贵试剂和有限样本;在药物、医学和高风险化学研究中,错误自信甚至比直接拒答更危险。
SPU最重要的结论因此不是某个模型赢了,而是当前AI科研能力的上限终于被测得更接近现实:模型已经能查资料、写代码、调用GPU,也能连续工作数小时,但它仍然经常不知道,自己算出的那个数字究竟是不是实验真正关心的数字。
算力可以把计算做深,却不能自动把科学问题选对。
参考来源
- Science Prediction Universe GitHub仓库:项目官方代码仓库,包含基准介绍、任务结构、贡献流程与论文材料。
- SPU公开数据集:100项公开任务的Harbor任务包、评分器及数据说明。
- Codex开源项目:SPU中GPT系列配置所使用的智能体运行工具相关资料。
- Terminal-Bench-Science:用于理解SPU与长程科学智能体任务差异的相关开源基准。