190行JAX复刻DeepSeek V3
开发者用190行核心代码复现DeepSeek V3的MLA、MoE、无辅助损失负载均衡与多Token预测,并在24GB MacBook Air上完成从零训练。
11月14日,一名开发者开源了一个只有约190行核心代码的DeepSeek V3极简复现,并在配备24GB内存的MacBook Air上从零完成训练。项目没有使用PyTorch、Flax或Equinox,而是直接用JAX数组和函数实现模型结构,目标不是跑起671B参数的官方权重,而是把DeepSeek V3最关键的架构机制压缩成一份可以从头读到尾、能够实际训练和生成文本的教学实现。(github.com)
项目名为deepseek-v3-jax,首个包含检查点、训练数据和日志的v1.0版本已于11月14日发布。核心文件deepseek_v3.py在GitHub统计中共有265个物理行、209个有效代码行;作者所说的“190行”,指的是模型主体逻辑,不包括空行、注释以及数据准备和训练入口等外围代码。(github.com)
先说结论:这是代码压缩,不是模型压缩
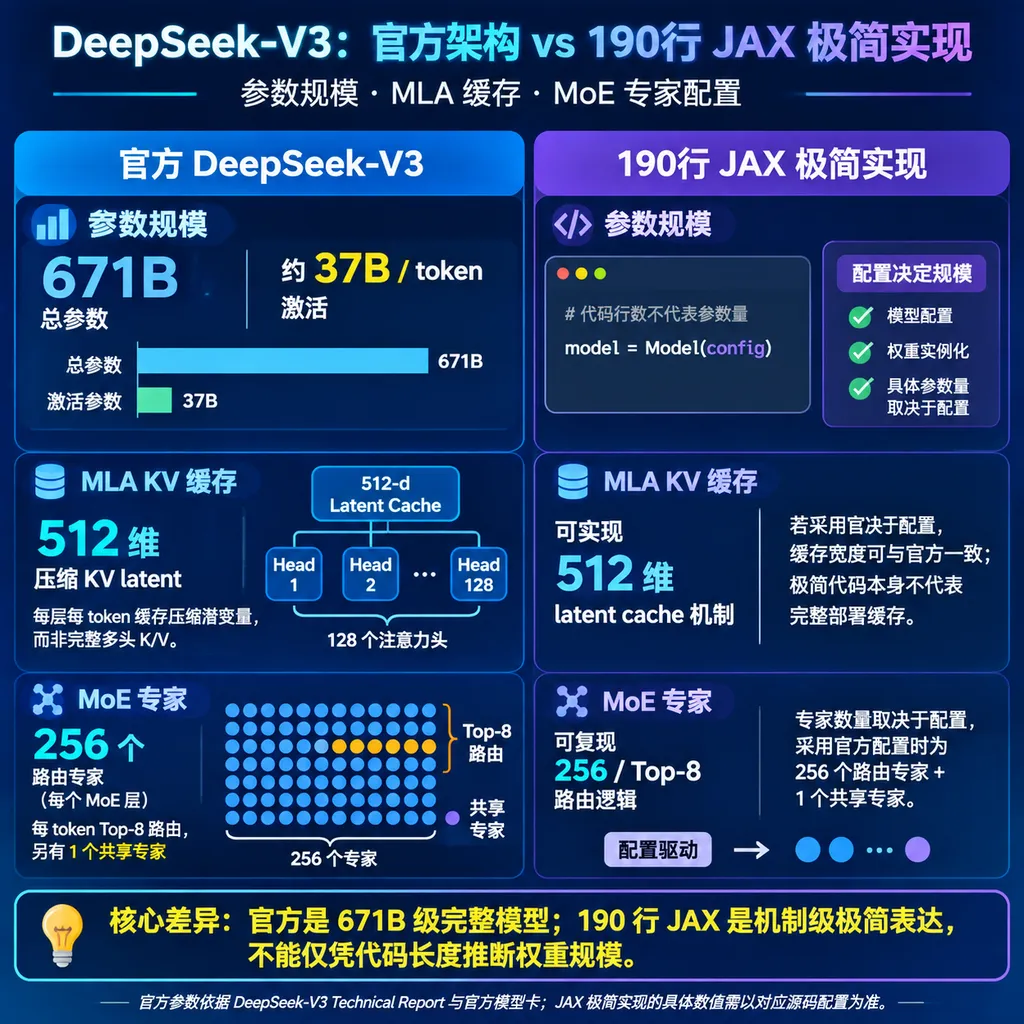
这个项目复现的是DeepSeek V3的架构思想,而不是把671B官方模型压缩到MacBook Air。 两者的参数规模相差约1.85万倍,训练数据、上下文长度和语言能力也完全不在一个量级。
官方DeepSeek V3是一个混合专家模型,即MoE模型,总参数量为671B,每个Token激活约37B参数,使用61层Transformer、256个路由专家和1个共享专家,并在14.8万亿Token上完成预训练。极简JAX版本则只有36.2M参数,每个Token激活13.6M参数,使用6层Transformer、16个路由专家和1个共享专家,训练语料只有2170万Token。(github.com)
| 对比项 | 官方DeepSeek V3 | deepseek-v3-jax | |---|---:|---:| | 总参数量 | 671B | 36.2M | | 每Token激活参数 | 37B | 13.6M | | Transformer层数 | 61层 | 6层 | | 注意力头数 | 128 | 6 | | 路由专家 | 256个 | 16个 | | 每Token选择专家 | 8个 | 4个 | | 共享专家 | 1个 | 1个 | | 上下文长度 | 128K | 256 Token | | 训练数据 | 14.8T Token | 21.7M Token | | 训练硬件 | 大规模H800集群 | 24GB MacBook Air M5 | | 训练耗时 | 完整训练2.788M H800 GPU小时 | 约2.6小时 | | 项目定位 | 可用的前沿大模型 | 架构教学与实验复现 |
把它称为“DeepSeek V3迷你版”也要加限定词。 它保留了MLA、解耦RoPE、DeepSeekMoE、无辅助损失负载均衡、序列级均衡损失和多Token预测,但省略了官方模型的大规模分布式训练、FP8训练基础设施、专家并行、节点限制路由、超长上下文扩展与生产级推理优化。
190行代码到底装进了什么
Multi-head Latent Attention是通过低秩潜变量压缩KV Cache的注意力机制。 标准多头注意力需要为每个Token、每个注意力头保存Key和Value,序列越长,缓存占用越大;MLA先把Key和Value压进一个较小的共享潜变量,需要计算注意力时再展开。
在这个JAX实现中,普通方式每层每个Token需要缓存480个数,而MLA只缓存128维KV潜变量和16维共享RoPE Key,共144个数。缓存量从480降到144,减少70%,约为原来的30%,压缩倍数为3.33倍。(github.com)
这个数字不能直接套到官方DeepSeek V3上,因为官方模型使用不同的头数和维度配置。不过,它把MLA最难理解的一点展示得很直观:缓存的是压缩后的“提纲”,而不是每个注意力头的完整Key和Value。
解耦RoPE是把内容信息和位置信息拆开处理的机制。 项目把不使用旋转位置编码的内容部分记为nope,把携带位置信息的部分单独旋转,并让所有注意力头共享RoPE Key。这样既可以压缩KV潜变量,又不会在低秩压缩中丢掉关键的位置关系。
DeepSeekMoE是让每个Token只经过部分前馈网络专家的稀疏计算结构。 极简版本配置16个路由专家,每个Token选择4个,再叠加1个始终运行的共享专家。共享专家处理通用模式,路由专家负责分流计算,这与DeepSeek V3“总参数很大、实际激活参数较小”的设计逻辑一致。
不过,这里有一个影响性能的重要简化:代码会对所有路由专家执行矩阵计算,再把未选中的专家权重置零。作者也在代码中明确写出“every expert runs on every token”。因此,它复现了MoE的路由数学和训练行为,却没有获得生产级稀疏MoE应有的计算节省。
换句话说,这份实现适合看懂MoE,不适合拿来证明MoE推理一定更快。
最有价值的实验:无辅助损失均衡真的有效
无辅助损失负载均衡是一种通过动态调整专家路由偏置、而不是向主训练目标加入强均衡损失来分配Token的方法。 传统MoE通常加入辅助损失,逼迫路由器把Token平均送给各个专家,但辅助目标可能与语言建模目标冲突,导致模型为了“排队整齐”而牺牲预测能力。
DeepSeek V3的方法更像给拥挤专家降低排队优先级:每一步训练结束后,如果某个专家接收的Token过多,就下调它的路由偏置;空闲专家则提高偏置。偏置只影响哪些专家入选,不改变被选专家原始门控分数,也不会直接进入语言建模损失。极简实现将偏置更新速度gamma设为1e-3,同时保留权重仅为1e-4的序列级均衡损失。(github.com)
作者还做了一个2000步对照实验:
| 实验设置 | 单个专家获得的路由份额 | 第2000步验证损失 | |---|---:|---:| | 开启动态偏置均衡 | 5.7%—6.9% | 3.921 | | 关闭动态偏置均衡 | 0.09%—18.6% | 3.923 | | 理论完全均匀值 | 6.25% | — |
这个结果比“在MacBook上训练DeepSeek”更值得关注。 开启均衡后,16个专家的负载集中在5.7%至6.9%,而关闭后最空闲专家只拿到0.09%的路由,最拥挤专家达到18.6%;与此同时,两组验证损失只相差0.002。至少在这个小规模实验中,动态偏置确实能在几乎不损害模型损失的情况下避免专家塌缩。(github.com)
这不能替代大模型实验,但它让技术报告中的抽象公式变成了开发者可以复跑的消融实验。
多Token预测也被保留了
Multi-Token Prediction是让模型除预测下一个Token外,同时学习更远位置Token的训练目标。 这相当于不仅要求学生回答下一步,还要求提前推演再下一步,迫使隐藏状态包含更多未来信息。
项目设置n_mtp=1,即主模型预测下一个Token,额外的MTP模块预测再下一个Token;MTP损失权重为0.3。MTP模块会把主干隐藏状态与后续Token的Embedding拼接、投影,再经过一个Transformer Block完成预测,并复用主模型的输出头。最终损失由主预测损失、0.3倍MTP损失和序列级均衡损失相加得到。(github.com)
这部分代码的价值在于,它展示了MTP不是简单地让同一个输出头一次吐出两个Token,而是增加一个带独立计算块的训练深度。至于推理时的投机解码、候选验证和真实加速,项目没有实现完整生产方案。
如何在Mac上复现
项目的默认复现环境是Apple Silicon、Python 3.12和24GB统一内存。 作者固定了依赖版本,其中jax-metal 0.1.1必须搭配jax==0.4.34和jaxlib==0.4.34,直接升级JAX可能导致Metal后端不可用。(github.com)
1. 克隆项目并安装环境
git clone https://github.com/Vaibhaav-Tiwari/deepseek-v3-jax.git
cd deepseek-v3-jax
uv venv -p 3.12 .venv
uv pip install --python .venv/bin/python -r requirements.txt
2. 先运行测试,不要直接开训
JAX_PLATFORMS=cpu .venv/bin/pytest tests.py -q
.venv/bin/python smoke_metal.py
项目包含39项测试,覆盖因果掩码、缓存推理与完整前向的一致性、MoE路由、动态偏置、MTP目标、NaN处理和混合精度权重等环节。jax-metal 0.1.1不支持某些双轴张量收缩的梯度,项目通过改写计算路径绕开了这一限制;smoke_metal.py中的相关测试失败属于预期现象。(github.com)
3. 准备训练数据
.venv/bin/python prepare_data.py
脚本会下载207本公版侦探小说,处理约1.2亿字节原始数据,训练一个8192词表的BPE分词器,并生成约2170万训练Token和30万验证Token。作者的完整训练实际处理约9800万Token,相当于对语料训练约4.5轮。
4. 开始默认训练
.venv/bin/python train.py
默认训练12000步,学习率为6e-4,预热200步,随后使用余弦衰减;优化器采用AdamW,权重衰减为0.1,并设置1.0的全局梯度裁剪。作者报告的训练速度中位数约为每秒1.07万Token,总耗时约2.6小时,验证损失从第250步的5.02降到3.51。(github.com)
5. 从检查点生成文本
.venv/bin/python sample.py --prompt 'The fog came in off the' --num 3
项目默认使用0.8温度、Top-K 50,每个样本生成300个新Token。需要强调的是,作者发布的检查点是Python Pickle文件;Pickle在加载时可能执行任意代码,因此只应加载可信来源提供的检查点。
如果设备只有8GB或16GB内存,可以尝试4层、8专家、Top-2路由和128 Token上下文的small配置:
JAX_PLATFORMS=cpu .venv/bin/python train.py --config small
作者只对这一配置做过少量步骤检查,没有完成与默认配置同等规模的完整训练,因此不能假定它会复现相同的损失曲线。
“纯JAX”也需要打一个小星号
项目所说的纯JAX,准确含义是模型结构没有依赖高级神经网络框架。 参数是普通的嵌套字典,RMSNorm、RoPE、MLA、MoE、损失和缓存生成都由JAX数组运算与函数直接组成,没有使用Flax、Equinox或PyTorch模块封装。
但它并非只有JAX一个依赖。核心文件导入了Optax,训练循环使用Optax实现AdamW、梯度裁剪、学习率调度和参数更新;数据处理还依赖Hugging Face Tokenizers、NumPy和Requests。因此,更严谨的表述应该是“纯JAX模型实现”,而不是“零第三方依赖实现”。(github.com)
这个区别不影响项目的教学价值,反而说明作者把有限的代码预算花在了真正需要读懂的模型结构上,而没有重新发明优化器和分词器。
谁最适合看这个项目
这份代码最适合已经理解Transformer、但还没有真正写过MLA和MoE的开发者。 官方DeepSeek V3仓库提供了FP8和BF16推理示例,代码更贴近真实部署,却不可避免地混入量化、并行通信、硬件适配和工程优化;190行JAX版本则把这些生产复杂度剥离,只保留架构骨架。
它尤其适合三类用途:
- 验证MLA缓存如何从完整KV变成低秩潜变量;
- 观察MoE专家失衡、动态偏置与专家塌缩之间的关系;
- 修改专家数量、Top-K、MTP权重和缓存维度,进行低成本消融实验。
它不适合直接用于生产推理、中文能力评测或官方权重加载。 训练语料是英语侦探小说,词表只有8192,默认上下文长度为256 Token,而且所有专家仍会参与底层矩阵计算。把它包装成“消费级电脑运行完整版DeepSeek V3”,属于对项目性质的误读。
极简复现正在成为新的技术文档
这次开源的真正意义,是把大模型论文从“可读”推进到“可运行”。 DeepSeek V3技术报告解释了671B模型为什么采用MLA、稀疏MoE、无辅助损失均衡和MTP,但读者面对的是大规模训练系统;极简实现则给出了一个能在个人电脑上跑通的缩小实验场。
过去,大模型架构教学常见两种极端:一种是几十行的玩具Transformer,足够简短,却看不到前沿模型的关键创新;另一种是生产框架里的完整实现,功能齐全,但路由、缓存和并行逻辑互相缠绕。deepseek-v3-jax处于两者之间:它不是最短的Transformer,也不是最快的DeepSeek推理引擎,但可能是目前理解DeepSeek V3架构成本最低的代码入口之一。
项目目前刚发布,GitHub页面显示只有4次提交,代码和实验结果仍需要更多开发者复核。即便如此,能用约200行可阅读代码同时容纳MLA、MoE均衡和MTP,并附带检查点、数据哈希、训练日志与消融实验,已经比大量只复述论文摘要的“复现项目”更扎实。
参考来源
- Vaibhaav-Tiwari/deepseek-v3-jax:190行纯JAX模型实现、复现步骤、实验数据与训练结果。
- deepseek_v3.py核心代码:MLA、MoE路由、动态偏置、MTP损失和缓存生成的具体实现。
- deepseek-v3-jax v1.0:作者发布的训练检查点、数据集、分词器、日志和校验文件。
- DeepSeek-V3官方仓库:官方模型参数、技术架构、评测结果与推理实现说明。
- DeepSeek V3技术报告中文整理:MLA、DeepSeekMoE、无辅助损失均衡和多Token预测的中文技术资料。