Lovable数据暴露敲响安全警钟
安全机构扫描近16万个Lovable项目,发现数千个应用可能在未登录状态下暴露个人数据。问题不只是代码漏洞,而是AI应用生成平台把上线速度置于默认安全之前。
Lovable生成的应用,被发现能直接读到护照和聊天记录
AI应用生成平台Lovable近日陷入一场数据安全风波。德国安全公司Crissy Field对159,041个Lovable项目进行分析后发现,部分应用在不登录、不输入密码的情况下,就可能返回用户邮箱、支付记录、身份文件信息以及聊天消息。
这不是一次已经确认的黑客入侵,而是一次大规模数据暴露。数据暴露是指敏感数据因访问控制配置不当而能被未授权人员读取;它不等于数据已经被盗用,但意味着任何发现入口的人都可能访问这些内容。
研究结果在2026年11月初由德国财经媒体Handelsblatt率先报道,Crissy Field随后公布了更新后的研究数据。截至11月14日,这件事已经从Lovable单个平台的安全争议,演变为对整个“氛围编码”行业默认安全机制的追问。
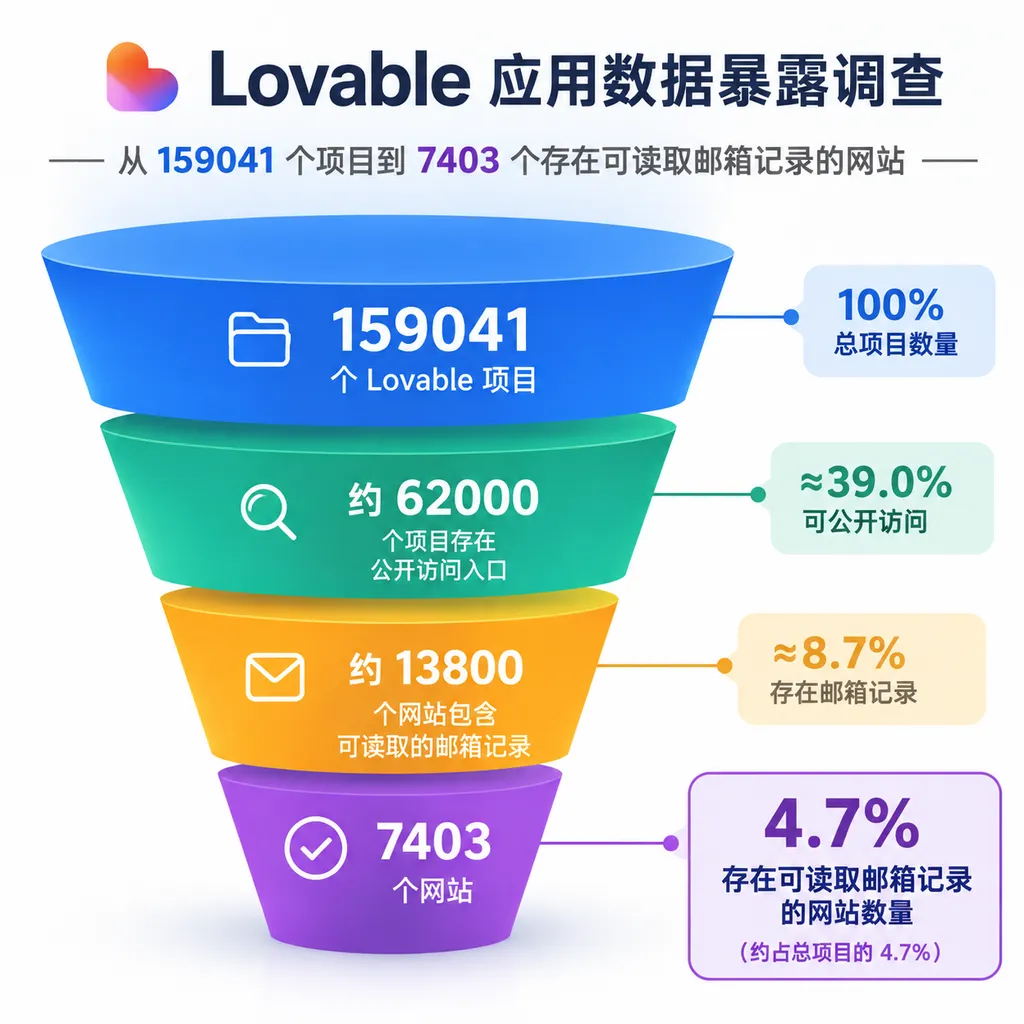
扫描近16万个项目,7403个网站出现个人数据
Crissy Field的研究覆盖了2025年12月至2026年9月被Common Crawl收录的159,041个Lovable项目,其中34,545个项目使用Supabase作为后端数据库。
研究人员发现,有24,664个网站会在页面首次加载时返回Supabase数据库记录。这个数字本身不能直接等同于泄露,因为新闻列表、商品信息和公开用户主页原本就可能被设计为公开数据。
真正值得警惕的是进一步的只读测试。研究人员使用应用前端已有的访问方式继续查询数据库,在7,403个网站的10,560张数据表中发现了包含邮箱地址的记录,占被深入检查网站的约30%。
研究团队特别强调,30%不是Lovable应用的“确认泄露率”。邮箱可能属于公开联系方式或测试数据,Common Crawl样本也不能代表平台全部项目;与此同时,不包含邮箱的敏感记录又可能被漏掉,因此这个比例只能说明风险规模,不能用于计算平台总体事故率。
| 调查指标 | 数量 | 应如何理解 | |---|---:|---| | 扫描的Lovable项目 | 159,041个 | 来自2025年12月至2026年9月的公开网页存档 | | 使用Supabase的项目 | 34,545个 | 本次研究重点分析的数据库技术栈 | | 页面加载时返回数据库记录的网站 | 24,664个 | 不一定属于泄露,部分数据可能本来就应公开 | | 出现含邮箱记录的网站 | 7,403个 | 未登录状态下可继续读取相关数据表 | | 涉及的数据表 | 10,560张 | 表明问题并非集中在单个应用 | | 被发现可访问的聊天消息 | 超过200,000条 | 来自一个德国生活方式论坛 | | 被发现的身份文件记录 | 超过1,000条 | 包含护照号码、有效期和国籍等字段 |
最严重的不是邮箱,而是身份文件和私信
研究发现的高风险数据已经超出普通营销名单的范围。一个德国生活方式论坛暴露了超过80,000份用户资料,其中包括姓名、邮箱、出生日期和性别,同时还有超过200,000条聊天消息能够被访问。
身份文件数据是本次事件中风险最高的一类信息。研究人员在某个服务商应用中发现超过1,000条身份文件记录,字段包含护照号码、证件有效期和国籍,这些数据一旦与姓名、联系方式组合,可能被用于身份冒用、精准诈骗或账户验证绕过。
交易场景同样没有幸免。多个活动组织者和餐饮应用暴露了数万条票务与餐饮销售记录,其中包括邮箱、电话号码、地址、票务代码以及部分支付相关信息;另一个项目则能够访问向客户发送的约280,000封邮件。
内部业务数据也出现在暴露范围内。研究人员看到的内容还包括合同、发票、私人相册、WhatsApp内部沟通,以及物业管理公司利用AI生成的内部邮件摘要,涉及租户、业主和商业伙伴的信息。
需要保持克制的是,目前没有公开证据证明这些数据已经被犯罪团伙批量下载或利用。Crissy Field也没有公布受影响应用的名称和具体访问路径,以避免报告本身变成攻击指南。
问题不是前端出现了公钥,而是数据库没有把门
Supabase是一套基于PostgreSQL的后端平台,它允许网页直接通过数据接口读取数据库。为了让浏览器访问数据库,应用通常需要在前端包含项目地址和publishable key,旧项目中则常见anon key。
前端出现publishable key并不等于密钥泄露。Supabase明确将这类密钥设计为可公开使用的项目标识,真正决定访问者能看到哪些数据的是行级安全策略,也就是Row Level Security,简称RLS。
RLS是运行在数据库内部的逐行授权机制。它可以规定登录用户只能读取自己的订单、团队成员只能访问所属组织的数据,未登录访客则只能看到明确标记为公开的内容。
这次事件暴露的核心问题,是部分应用允许匿名角色访问数据库,却没有为数据表配置足够严格的RLS策略和权限范围。结果就像一家酒店把前台电话号码印在宣传册上本来没有问题,但同时忘了锁住客房,并允许任何打电话的人查询全部入住记录。
| 配置状态 | 浏览器持有公开密钥 | 数据库访问结果 | 风险水平 |
|---|---|---|---|
| 正确启用RLS并限制权限 | 是 | 只能读取策略允许的数据 | 可控 |
| 启用RLS但策略使用USING (true) | 是 | 匿名用户可能读取全部行 | 高 |
| 数据表未启用RLS | 是 | 取决于角色授权,可能直接暴露整张表 | 严重 |
| 前端包含service role或secret key | 是 | 可能绕过RLS并获得高权限 | 极严重 |
这种缺陷通常不会在应用界面上表现出来。创建者打开网页时看到登录页、个人中心和权限菜单,容易误以为系统已经受到保护;但攻击者不需要点击界面,只需要观察浏览器发出的网络请求,再尝试应用已经暴露的数据接口。
Lovable并非被“攻破”,但平台很难只谈共同责任
Lovable应用数据暴露与Lovable自身服务器被攻破是两个不同概念。现有调查指向的是客户生成应用的数据库访问规则配置不当,而不是研究人员进入了Lovable内部系统。
Lovable将安全描述为平台与应用创建者的共同责任。这个说法在传统云计算行业并不新鲜:平台负责基础设施、加密和服务边界,客户负责业务数据、用户权限和具体应用配置。
问题在于,Lovable卖出的不只是云基础设施,而是“不需要编程经验也能上线应用”的完整体验。用户可以用一句自然语言要求创建预约系统、会员社区或客户管理工具,AI负责生成页面、数据库和部署流程,平台甚至承担托管和持续运行。
当平台主动降低开发门槛时,安全门槛却不能原封不动地留给用户。一个不知道RLS是什么的人,不太可能在提示词中主动要求“为匿名角色撤销SELECT权限,并对每张公开表建立基于用户ID的访问策略”。
Lovable目前的官方安全页面表示,项目发布时会自动运行约10至15秒的基础安全扫描,检查数据库配置、RLS规则和已知错误模式;更深入的扫描约需3分钟,部分工作区还可以设置在发现严重问题时阻止发布。
这些能力说明Lovable已经认识到问题所在,但扫描提示与安全默认值仍然是两回事。如果平台允许用户忽略警告继续发布,或者只检测明显的“未启用RLS”,却无法理解一个过度宽松的业务策略,那么最终上线的仍可能是一个形式上通过检查、实际上向所有人开放数据的应用。
真正需要改变的是“默认允许上线”
默认安全是指系统在用户没有做额外配置时,也应处于风险较低的状态。对于面向非专业开发者的AI应用平台,默认安全不应只是一份检查报告,而应成为发布流程中的强制约束。
Lovable以及同类平台至少应该默认执行以下限制:
- 新建数据表默认启用RLS,并撤销匿名角色不必要的读写权限。
- 包含护照号、支付信息、健康数据等敏感字段时,默认禁止匿名读取。
- 应用没有身份验证却连接用户数据表时,阻止公开发布,而不是只显示警告。
- 为每次数据库结构变化重新运行权限测试,避免后续新增表绕过原有策略。
- 将测试数据和生产数据明确分离,禁止把真实客户数据直接复制进原型项目。
- 对公开应用提供持续监测,而不是只在第一次发布时扫描一次。
传统开发团队通常需要经历需求设计、代码审查、安全测试和部署审批。氛围编码平台把这条流程压缩成“描述需求—生成应用—点击发布”,速度提高的同时,也删除了大量原本用于发现权限错误的检查点。
| 环节 | 传统开发流程 | AI应用生成流程的常见状态 | |---|---|---| | 身份与权限设计 | 架构阶段明确角色和数据边界 | 经常在应用完成后补充 | | 代码审查 | 由工程师交叉检查 | 创建者可能不会阅读代码 | | 数据库权限测试 | 测试匿名、普通用户和管理员角色 | 常被登录页面是否存在所替代 | | 安全扫描 | 接入SAST、DAST和依赖扫描 | 依赖平台内置检查 | | 发布审批 | 运维或安全团队确认 | 一键直接发布到公网 | | 持续监测 | 日志、告警和漏洞管理 | 原型上线后可能无人维护 |
这不是Lovable独有的问题
同类风险并不依赖Lovable这一家公司。只要AI生成的网页能够直接连接数据库,而访问规则没有被正确设置,Bolt、Base44、v0、Replit以及其他低代码平台都可能出现相同机制的问题。
Lovable之所以成为这次调查的主角,一方面是其项目规模足够大,另一方面是生成应用具有相对统一的技术特征,研究人员可以从公开网页存档中识别项目,再对相似的数据库集成模式进行批量检查。
统一技术栈既能提高开发效率,也会放大系统性风险。传统网站的漏洞可能需要攻击者逐个分析,而AI平台批量生成的应用往往使用相同目录结构、数据库客户端和权限模板,一旦某种检查方法对一个项目有效,就可能以较低成本扩展到大量项目。
目前没有足够数据证明Lovable的实际泄露比例高于所有竞品。更准确的结论是,Lovable的规模让行业长期存在的配置错误变得可测量,也让“不会写代码也能上线生产应用”的安全代价第一次以数千个网站的形式集中出现。
开发者现在应该检查什么
使用AI生成平台发布过应用的团队,应当把这次事件视为一次资产盘点通知。检查重点不是页面看起来是否需要登录,而是未登录请求能否直接访问底层表、存储桶、视图和服务端函数。
开发者可以按以下顺序自查:
- 列出所有已经发布的项目、自定义域名和平台子域名,包括已经停止使用的原型。
- 检查浏览器网络请求,确认前端连接了哪些数据库项目、数据表和存储桶。
- 为公开schema中的每张数据表启用RLS,并重新审查
anon与authenticated角色的权限。 - 分别测试未登录用户、普通用户、其他账户和管理员的读取、新增、修改、删除权限。
- 检查策略是否包含
USING (true)、缺少用户ID限制或允许匿名角色访问整张表。 - 确认service role、secret key和数据库连接字符串没有进入前端代码、日志或公开仓库。
- 将护照、支付、医疗和企业机密数据放在服务端流程后面,避免由浏览器直接查询。
- 如果确认数据曾可被未授权访问,应保留日志、轮换凭据、通知相关用户并评估合规义务。
AI能生成应用,但不能替你承担数据责任
Lovable事件揭示的不是“AI写的代码一定不安全”,而是应用生成速度已经超过安全治理速度。AI可以在几分钟内创建页面、数据库和登录流程,却无法仅凭界面需求自动理解一家公司的数据分类、员工权限与监管义务。
平台也不能继续把安全能力包装成可选的高级功能。当目标用户从专业工程师扩展到产品经理、设计师和个体创业者时,把关键权限设置藏在数据库控制台里,再通过服务条款要求用户自行负责,并不是与产品定位相匹配的安全设计。
这场风波最终会推动AI应用平台从“生成代码”走向“生成可安全运行的系统”。真正有竞争力的平台不会只比较页面生成速度和模型能力,还要比较默认权限是否收敛、发布门禁是否强制、策略测试是否自动化,以及出现问题后能否定位受影响的数据和用户。
Lovable兑现了让更多人快速发布应用的承诺,但这次调查提醒行业:降低编程门槛不等于消除软件工程责任。创建者可能不知道数据库的门没有锁,上传护照和发送私信的终端用户更不可能知道——而安全产品设计的价值,恰恰是不能把这个判断留给最后一个人。
参考来源
- Crissy Field与Handelsblatt的Lovable应用调查:本文事件数据的主要来源;因发布域名限制,未附原始站外链接。
- Supabase Row Level Security官方文档源码:解释RLS、匿名角色授权和数据表保护机制。
- OWASP Supabase安全测试指南:介绍Supabase前端密钥、RLS缺失与匿名访问风险。
- Vibe-Scanner开源项目:用于审计Lovable、Supabase项目RLS策略及常见权限错误的社区工具。
- Vibe Code Triage开源扫描器:检查AI生成应用中的RLS缺失、认证缺口与公开密钥等问题。