96%之后,Agent记忆卡在哪
Papr 在 LongMemEval-S 获得 96.0% 准确率,但 Top-20 相比 Top-5 只多答对 3 题。结果显示,Agent 长期记忆的瓶颈正从检索召回转向证据阅读与时间推理。
LongMemEval-S 跑出 96%:Agent 长期记忆不再只是检索问题
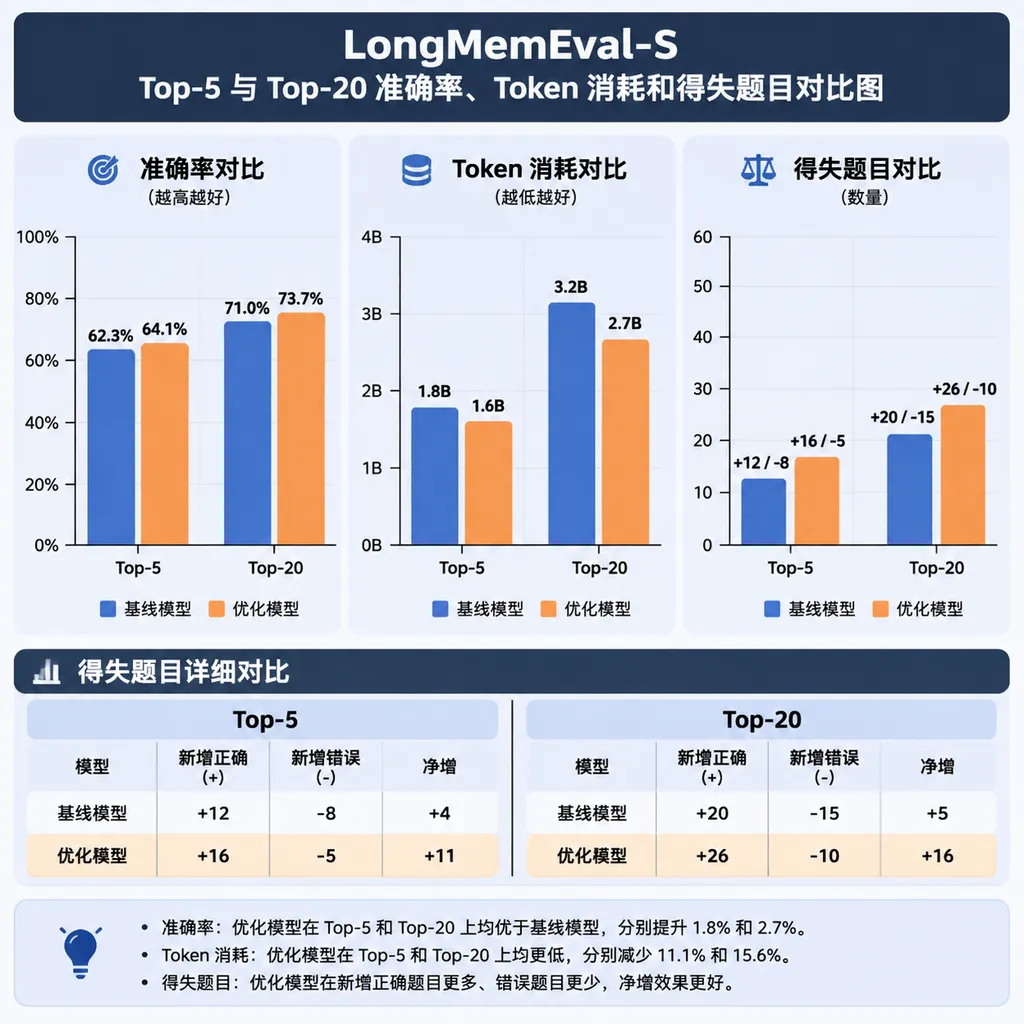
11 月 15 日,Papr 团队公布了一组新的 LongMemEval-S 测试结果:在全部 500 道问题上,其长期记忆系统获得 96.0% 的最终答案准确率,即 480/500,评分使用 LongMemEval 官方提示词和未经修改的 gpt-4o-2024-08-06 Judge。更值得关注的不是 96% 这个数字,而是团队同时公开了 Top-5 与 Top-20 的逐题差异:检索数量增加 4 倍后,系统多答对 11 题,却又丢掉 8 题,最终净收益只有 3 题。(reddit.com)
这组结果说明,Agent 长期记忆的主要矛盾正在变化。 当相关证据已经能稳定进入前五条结果时,继续增加召回数量不再是无成本的提升;Reader 能否识别时间关系、处理事实更新并忽略干扰信息,开始比向量数据库能否“搜到”更重要。
LongMemEval-S 的 96% 到底测了什么
LongMemEval-S 是一个评估对话式 Agent 长期记忆能力的基准测试。 它包含 500 道人工整理的问题,每道题都配有跨越多个会话的聊天历史,要求系统从大量无关内容中找到证据,并完成信息提取、跨会话推理、时间推理、知识更新和拒答。官方研究指出,直接把完整历史交给长上下文模型,准确率可能比 Oracle 证据条件下降约 30%,说明“上下文窗口装得下”并不等于“模型记得住”。(arxiv.org)
最终答案准确率与检索召回率是两个不同指标。 Recall@20 只检查正确证据是否出现在前 20 条结果中,而 96.0% 指的是系统生成答案后,再由官方 Judge 判断答案是否正确。一个系统完全可能拥有 97% 的 Recall@20,却因为读错日期、混淆新旧事实或不该回答时强行回答,最终准确率明显更低。
Papr 此次公开的主要配置如下:
| 配置 | Answer Model | 检索深度 | 最终准确率 | 每题 Reader Token | 中位检索延迟 | |---|---|---:|---:|---:|---:| | Embed High K=20 | Claude Opus 4.6,8K thinking | 20 | 96.0%,480/500 | 约 60K | 约 1.9 秒 | | Embed High K=5 | Claude Opus 4.6,8K thinking | 5 | 95.4%,477/500 | 约 16.5K | 约 1.9 秒 | | Embed Rerank | GPT-5 mini | 5 | 94.4%,472/500 | 约 15K | 约 1.9 秒 | | Embed Low | GPT-5 mini | 5 | 91.0%,455/500 | 约 14.2K | 约 0.17 秒 |
96.0% 与 95.4% 的差距只有 0.6 个百分点。 Top-20 的 Reader 输入从约 16.5K Token 增至约 60K Token,扩大到原来的 3.6 倍,但只净增 3 道正确答案;而团队观察到单次完整运行可能波动约 ±3 题,因此这两个结果在统计意义上基本可以视为同一水平。(github.com)
这也是此次测试最有价值的地方:Top-K 不是越大越好,而是成本、召回率和上下文噪声之间的工程取舍。
Top-20 为什么能赢 11 题,又输掉 8 题
Top-K 是记忆系统交给 Reader 的候选记忆数量。 Top-5 意味着模型只看到排序最高的 5 个会话,Top-20 则意味着模型可以看到更多潜在证据,但也必须在更长的输入中判断哪些内容真正相关。
Papr 的 Top-20 配置相比 Top-5 出现了一个很典型的结果:
- 11 道题从错误变为正确;
- 8 道题从正确变为错误;
- 最终净增加 3 道正确答案;
- 总准确率从 95.4% 增至 96.0%;
- 拒答题保持 27/30,没有改善;
- 时间推理从 123/133 提升到 130/133。
Top-20 的主要收益集中在时间推理。 时间问题通常不是找到一条语义相似的记忆就能解决,而是要同时找出事件、日期、先后顺序和参照点。例如用户可能先说“下周去东京”,数月后又问“我上次提到东京旅行是在生日之前还是之后”。如果 Top-5 少召回了一个决定时间轴的会话,Reader 即使推理能力再强也无法补齐事实。
Top-20 的主要损失来自新增上下文对 Reader 的干扰。 当 15 条额外记忆进入提示词后,模型需要面对更多相似实体、过期偏好和重复描述。它可能抓住一条措辞更直接但时间更早的记录,也可能把“用户曾经计划做某事”误读成“用户已经做过某事”。换句话说,Top-20 提高了证据上限,却降低了平均信噪比。
这种现象可以类比搜索引擎:第一页有 5 个高质量结果时,用户往往能快速找到答案;如果一次展示 20 个结果,其中混入多个旧版本、转载和相似页面,信息更多不一定让判断更准确。
检索召回已经接近饱和
此次测试最关键的数据是 Top-5 的完整证据召回率达到 97.9%。 在 470 道可以回答的问题中,有 460 道题所需的全部证据会话都已进入前五名;扩大到 Top-20 后,这一数字为 467/470。也就是说,把候选数量从 5 增至 20,只让额外 7 道题获得完整证据。(github.com)
检索接近饱和意味着继续优化 Embedding 的边际收益正在下降。 Papr 的管线先使用 0.6B 参数的 papr-embed-schema-1-0.6b 对用户消息和问题进行向量化,每个会话取内部最高余弦相似度作为分数;系统保留前 20 个会话,再使用 Gemini 2.5 Flash 对它们进行重排,最后将排名靠前的会话交给 Answer Model。
整条管线可以拆成四层:
- 写入表示层:决定一段对话如何切分、提取和向量化;
- 初步召回层:从全部历史中找出语义上可能相关的会话;
- 重排层:判断候选会话是否真正包含回答问题所需的证据;
- 阅读生成层:综合证据、处理时间关系并输出最终答案。
当 Top-5 已经覆盖 97.9% 的完整证据时,剩余错误不能简单归咎于向量搜索。 Reader 可能忽略已经出现在上下文中的信息,也可能在多个事实之间建立错误关系。对于 Agent 开发者来说,这意味着评测不能只记录 Recall@K,还必须检查“证据已召回但答案仍然错误”的 Reader Failure。
Reader 正在成为长期记忆的新瓶颈
Reader 是读取检索结果并生成最终答案的模型。 在传统 RAG 系统中,团队常把大量精力放在切块、Embedding、向量数据库和重排模型上,但 LongMemEval-S 的新结果表明,当召回率超过 97% 后,Reader 的证据忠实度会直接决定系统上限。
Reader 至少需要处理四类容易被普通问答掩盖的问题:
- 新旧事实冲突:用户先喜欢 A,后来明确改为喜欢 B,系统必须优先采用更新后的状态;
- 事件与计划区分:用户说“准备去北京”不能被当作“已经去过北京”;
- 相对时间换算:上周、三天后和生日之前必须结合会话时间戳解析;
- 证据不足时拒答:检索结果看似相关,但没有明确答案时,系统不能靠常识补全。
长上下文模型的注意力预算不是均匀分配的。 把 Reader 输入从 16.5K Token 扩展到 60K Token,并不意味着模型对每条证据的理解能力保持不变。更多 Token 会增加相关句子之间的距离,也会让相似但错误的候选获得注意力,这正是 Top-20 会让 8 道原本正确的问题退化的原因之一。
因此,Agent 记忆系统的下一步不应只是“召回更多”,而应是“让 Reader 看见更少但更完整的证据”。
GPT-5 mini 的 94.4% 更值得开发者关注
小型 Reader 获得 94.4%,说明高质量检索可以显著降低对顶级模型的依赖。 Papr 的重排配置使用 GPT-5 mini,在约 15K Reader Token 的条件下答对 472/500,仅比 Claude Opus 4.6 的 Top-5 高配方案少 5 题。(github.com)
这个差距对生产系统很重要。开发者真正面对的不是一次 Benchmark 排名,而是数百万次长期记忆查询中的延迟和成本。如果高质量的写入、召回与重排可以让小模型达到顶级 Reader 约 98.9% 的正确题数,那么很多客服、个人助理和企业知识 Agent 没有必要让最昂贵的模型处理每一次记忆读取。
更合理的生产架构是分层路由,而不是固定使用同一个 Reader。 普通单会话事实和明确偏好可以交给小模型;涉及多次知识更新、复杂时间线或多个会话合并时,再升级到推理能力更强的模型。这种路由方式通常比把 Top-K 从 5 永久调到 20 更有效,因为它把额外计算用在真正困难的问题上。
Top-K 应该动态选择,而不是写死
固定 Top-K 是方便评测的配置,却未必是最佳生产策略。 不同问题需要的证据数量差异很大:询问用户最喜欢的颜色可能只需要一个会话,而统计过去半年参加过多少次会议,则可能需要遍历多个时间段。
开发者可以从这次结果中提炼出五条实践原则:
1. 默认使用较小的 Top-K
Top-5 已能覆盖 97.9% 的完整证据,适合作为默认档位。 较小上下文可以降低 Token 消耗,并减少过期信息和语义相似内容对 Reader 的干扰。
2. 对时间与计数问题扩大检索
时间推理是 Top-20 收益最明显的类别。 系统可以通过轻量分类器识别“之前、之后、最近一次、多少次、持续多久”等问题,再扩大候选范围或执行多轮检索。
3. 用结构化证据替代原始会话堆叠
Reader 需要的是事件链,不是聊天记录全文。 对检索到的会话先提取事件、主体、状态和时间戳,再按时间排序,通常比直接塞入 20 段完整对话更容易推理,也更节省上下文。
4. 单独评测“召回正确但回答错误”
端到端准确率无法告诉开发者问题究竟出在检索还是生成。 每道失败题至少应记录证据是否进入 Top-K、Reader 是否引用正确证据、是否选择了过期事实,以及 Judge 是否存在不稳定判定。
5. 为拒答建立独立阈值
拒答能力不会随着 Top-K 增加自然改善。 Papr 的 K=5 与 K=20 都是 27/30,说明检索更多内容既没有让系统更谨慎,也没有解决缺乏证据时的幻觉问题。拒答应依赖证据充分度、重排置信度和事实一致性,而不是候选数量。
96% 不是一个可以直接横向比较的冠军分数
LongMemEval 的系统排名高度依赖评测配置。 Judge 模型、数据集版本、Answer Model、提示词、Top-K、是否使用完整历史以及是否针对题型路由,都会改变最终得分。两个同为 95% 的系统,可能一个每题读取 60K Token,另一个只读取 15K Token;也可能一个使用官方 Judge,另一个使用不同评分模型。
Papr 团队也主动列出了限制:96.0% 是自报结果;K=20 是在查看 Top-5 失败问题后选择的;团队曾使用 248 道题迭代开发,并在另外 252 道题上检查,但不存在完全未接触的独立测试集;不同完整运行之间还有约 ±3 题波动。因此,96.0% 与其他采用相近协议的 95%—96% 结果更应该被视为同一梯队,而不是精确到小数点后一位的绝对排名。(github.com)
这不会削弱此次结果的工程价值,反而让结论更可信。 真正可复用的信息不是“某家公司领先 0.4 个百分点”,而是 Top-20 用约 3.6 倍 Reader Token 换来 0.6 个百分点提升,并且新增上下文会同时制造新错误。
长期记忆的竞争进入第二阶段
Agent 长期记忆的第一阶段解决的是“能不能找到”,第二阶段解决的是“找到之后会不会读错”。 当检索召回率从 60% 提升到 90% 时,升级 Embedding、切块和重排通常能带来明显收益;但当 Top-5 完整证据召回达到 97.9% 后,系统优化重心必须转向时间线构建、知识更新、证据压缩和动态路由。
96% 不是 LongMemEval-S 被“刷穿”的信号。它更像一个分界点:继续把更多记忆塞进上下文,已经无法稳定换取更高准确率。对于正在开发 Agent 的团队,最值得做的下一项实验不是把 Top-K 从 20 调到 50,而是逐题检查那 8 道因上下文增加而退化的问题。
一个可靠的长期记忆系统,最终比拼的不是记住多少,而是能否在正确的时间使用正确的那一条。
参考来源
- Papr 在 Reddit 公布的 LongMemEval-S 结果:包含 96.0%、Top-5 与 Top-20 得失题数及实验限制说明。
- Papr LongMemEval-S 复现仓库:提供逐题答案、Judge 标签、检索结果和评分复现代码。
- LongMemEval 官方 GitHub 仓库:包含数据格式、任务分类、官方提示词和评测脚本说明。
- Agent Memory 系列评测梳理:整理 LongMemEval、LoCoMo 等长期记忆基准的指标、难度和常见评测边界。