RoPE为何统治现代LLM
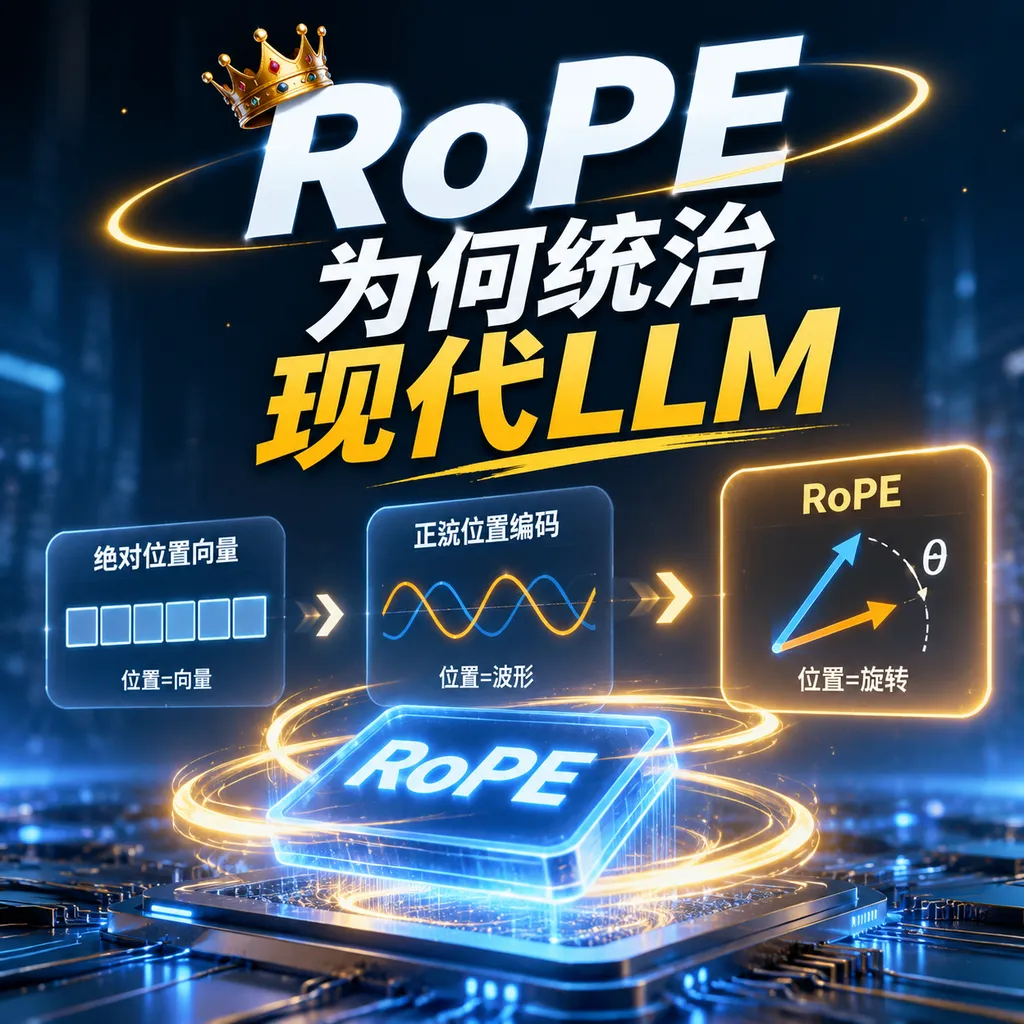
位置编码已经从给词向量添加坐标,演进为直接旋转注意力中的 Query 和 Key。本文拆解 RoPE 的数学直觉、工程实现、长上下文扩展与选型取舍。
RoPE为何统治现代LLM:从绝对位置到旋转编码的实现与取舍
11 月 15 日,机器学习研究者 Sebastian Raschka 发布了一篇关于现代大模型位置编码的系统梳理,重新讨论了一个看似基础、实际上仍在快速变化的问题:Transformer 到底应该怎样理解 token 的先后顺序。文章对 2026 年的开放权重模型进行统计后发现,RoPE 依然是主流方案,但在所有注意力层、所有维度上完整应用 RoPE 的做法正在减少,Partial RoPE、RoPE 与 NoPE 混合等设计开始增多。(magazine.sebastianraschka.com)
这个变化值得开发者关注,因为位置编码并不是一个只影响理论优雅程度的小模块。它会直接决定模型能处理多长的上下文、KV Cache 怎样组织、长文本性能如何衰减,以及把一个 8K 模型改成 32K 或 128K 时,到底是在扩展能力,还是只把配置文件里的数字改大。
位置编码是向 Transformer 提供 token 顺序和距离信息的机制。 如果完全没有位置信息,普通自注意力会把输入近似看成一个无序集合;“猫追狗”和“狗追猫”拥有相同的 token,只是排列不同,但语义显然相反。因果掩码虽然隐式提供了“只能看左边”的顺序线索,却无法直接告诉模型两个 token 相距 1 个位置还是 1000 个位置。
RoPE 真正解决的问题,不是简单地让模型知道“我在第几个 token”,而是让注意力机制更自然地回答:“我和另一个 token 相隔多远,这个距离会怎样改变我们之间的关系?”
第一代方案:给每个位置发一张身份证
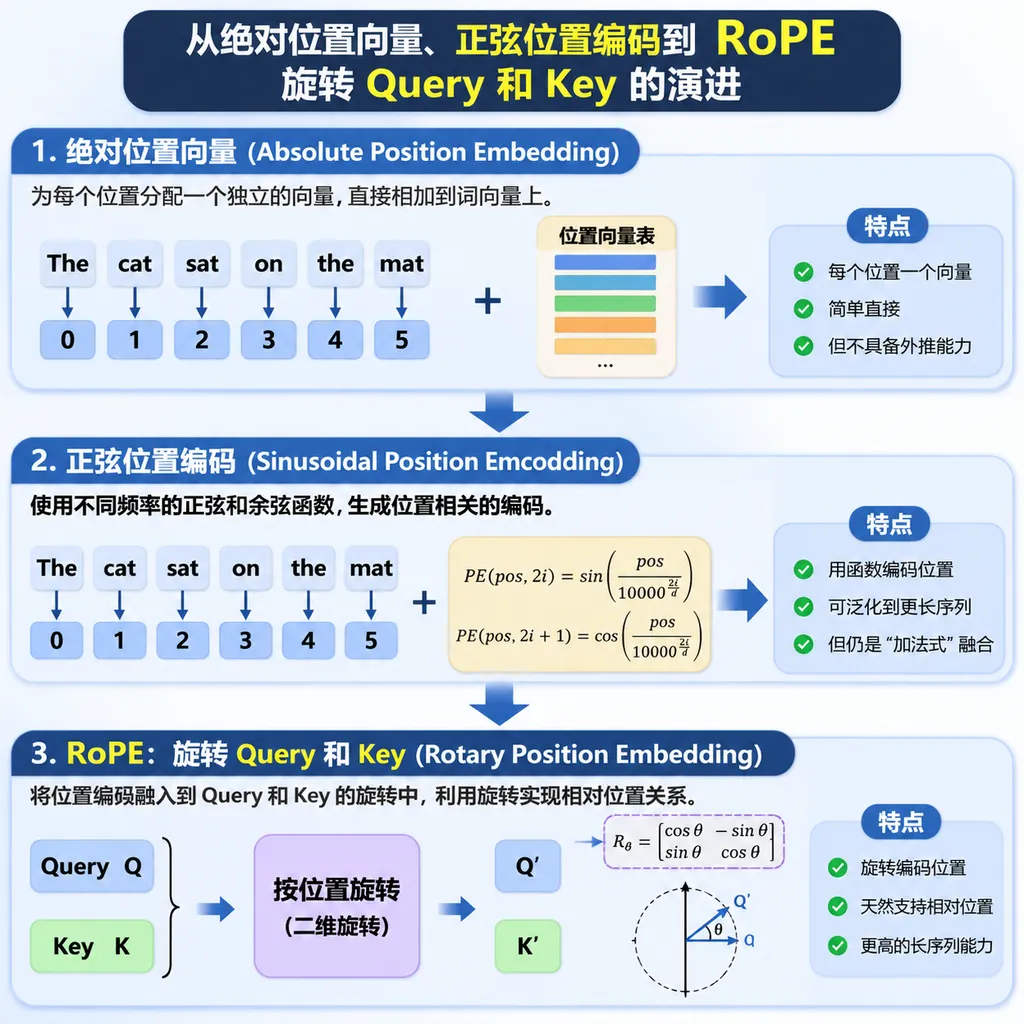
绝对位置编码是为序列中的每个绝对索引分配一个位置向量,并把它加入 token 表示的方法。 GPT-2 使用的就是可学习绝对位置嵌入:模型除 token embedding 表之外,还有一张 position embedding 表,第 0、1、2、3 个位置分别查出不同向量,然后与 token embedding 逐元素相加。
这种方法非常直观。假设“苹果”在位置 5 和位置 500 出现,它的 token embedding 相同,但加入的位置向量不同,因此进入第一层 Transformer 时已经是两个不同表示。
问题也同样直观:位置表的大小在训练前就基本确定了。GPT-2 原始实现只学习 1024 个位置向量,因此天然面向不超过 1024 token 的输入;如果推理时突然输入第 1025 个位置,模型没有一个经过训练的位置向量可以直接使用。(magazine.sebastianraschka.com)
可学习绝对位置编码的优势是自由度高,模型可以为不同位置学习任意模式;代价则是长度被位置表锁定,而且模型学到的可能是“第 300 个位置通常出现什么”,而不是“两个词相隔 3 个位置意味着什么”。在分类、固定尺寸视觉输入或严格限制长度的任务中,这种方案仍然实用;但对通用 LLM 来说,它已经不够灵活。
正弦编码:不用训练的位置坐标系
正弦位置编码是使用不同频率的正弦和余弦函数,为每个绝对位置生成固定向量的方法。 原始 Transformer 没有学习位置表,而是按照公式计算位置向量:高频维度变化快,负责区分邻近 token;低频维度变化慢,用于表达更长距离的位置变化。
它比可学习位置表更适合外推,因为位置 10000、10001 甚至更远的位置都可以直接计算,不会遇到 embedding 表越界。然而,“能够计算一个新位置”不等于“模型能够正确使用这个新位置”。如果模型训练时最多只见过 2048 token,它仍然可能在 8192 token 上失效,因为注意力层和前馈网络从未学习过这种长度下的分布。
更关键的是,正弦编码仍然采用加法:
隐藏状态 = token embedding + position embedding
随后,这个混合后的向量再分别投影成 Query、Key 和 Value。语义信息与位置信息从第一层开始就纠缠在残差流中,模型需要自己从复杂的交叉项里恢复相对距离。它能工作,但不够直接。
RoPE 的核心:别给向量贴标签,直接把它转过去
旋转位置嵌入(Rotary Position Embedding,RoPE)是根据 token 的绝对位置旋转 Query 和 Key,并使二者点积只显式依赖相对位置差的编码方法。 RoPE 由 RoFormer 工作提出,后来随着 LLaMA 等架构普及,逐渐成为现代 LLM 的事实标准。(arxiv.org)
RoPE 不再把位置向量加进输入,而是在每一层注意力内部完成操作:
- 隐藏状态先投影为 Query、Key、Value。
- Query 和 Key 的特征维度被两两分组。
- 每一组二维向量按照当前位置和对应频率旋转。
- 旋转后的 Query、Key 计算注意力分数。
- Value 不旋转,继续承载要被读取和聚合的内容。
为什么只处理 Query 和 Key?因为 Query 与 Key 的点积决定“当前位置应该关注谁”,位置最应该影响的正是这种匹配关系;Value 决定“关注之后读取什么”,没有必要把坐标反复写入被传递的内容。
从几何上看,二维旋转可以写成:
R(mθ) = [[cos(mθ), -sin(mθ)], [sin(mθ), cos(mθ)]]
位置 m 的 Query 乘以旋转矩阵 R_m,位置 n 的 Key 乘以 R_n。计算点积时:
(R_m q)^T (R_n k) = q^T R_m^T R_n k = q^T R_(n-m) k
最后只剩下 n-m,也就是两个 token 的相对距离。
这就是 RoPE 最精妙的地方:实现时使用绝对位置,产生的注意力关系却天然包含相对位置。 如果在一段文本前插入 100 个 token,原本处于位置 20 和 25 的词会移动到 120 和 125,但两者仍然相隔 5 个位置。只考虑旋转操作时,它们增加了相同的整体角度,彼此的相对角度保持不变。
不过,必须纠正一个常见误解:RoPE 并不保证距离越远,注意力分数就越小。不同频率分量会产生不同相位,叠加后的分数通常呈振荡变化,而不是单调衰减。所谓长程衰减,更适合理解为统计意义上的趋势,而不是每一对 Query 和 Key 都遵守的硬规则。
工程实现:公式简单,细节容易埋雷
RoPE 的工程实现是把注意力头的一部分或全部特征配成二维向量,再使用预计算的正弦和余弦完成旋转。 一个常见实现会先得到形状类似 [batch, heads, sequence, head_dim] 的 Query 和 Key,然后生成与 position ID 对应的 cos、sin 张量。
对二维向量 (x₁, x₂),旋转结果为:
- 新的第一维:
x₁ × cos - x₂ × sin - 新的第二维:
x₁ × sin + x₂ × cos
真实代码库通常不会真的构造旋转矩阵,因为那会制造大量无意义的零和矩阵乘法。实现会使用逐元素乘法、维度交换和拼接完成同样的运算。
这里至少有四个容易出错的点。
1. 配对方式必须和权重一致
RoPE 可以把相邻维度配成 (0,1)、(2,3),也可以把前后两半配成 (0,d/2)、(1,d/2+1)。两种方式在数学上都可以成立,但预训练权重默认了其中一种布局。
换句话说,RoPE 的不同维度排列并不是可以随意互换的“代码风格”。如果加载权重后换了一种配对方式,即使张量形状完全正确,模型输出也会明显异常。复现模型时,应该直接检查原始实现,而不是凭经验重写一个看起来等价的版本。
2. cos 和 sin 应复用,而不是逐层重复生成
位置频率由 position ID、旋转维度和 rope_theta 决定。同一次前向传播中,多个注意力层通常可以共享计算结果;推理框架也可以对常用长度进行缓存。
RoPE 不包含可学习参数,浮点运算量相对 QKV 投影和 MLP 很小,但它属于典型的逐元素、访存受限操作。高性能实现更关心少发起一次 kernel、少读写一次显存,而不是减少几次乘法,因此通常会把 RoPE 与 QK 处理或注意力内核融合。
3. KV Cache 存什么,取决于旋转发生在哪里
自回归生成中,历史 Key 通常在写入 KV Cache 前就已经根据自身位置完成旋转。新 token 到来时,只需要旋转新产生的 Query 和 Key,再让新 Query 与缓存中的历史 Key 计算注意力。
这也是 RoPE 适合生成式模型的重要原因:位置操作可以逐 token 完成,不要求重新构造完整的二维相对位置矩阵。传统相对位置向量方法往往需要为每个 Query-Key 组合处理距离信息,实现和缓存管理都更复杂。
4. 混合精度不能牺牲相位精度
短序列下,FP16 或 BF16 通常足以保存旋转结果;但在很长的位置上,position ID 与逆频率相乘产生的角度越来越大,低精度三角函数可能出现明显误差。
稳妥做法是用更高精度计算频率与 cos、sin,再转换到模型计算所需的数据类型。否则模型可能不是因为“不会处理长文本”而退化,而是因为角度计算已经失真。
RoPE 不是长上下文的免费午餐
长度外推是模型在推理时处理超过训练长度序列的能力。 RoPE 让相对距离进入注意力分数,但它并没有自动解决训练分布之外的频率问题。
每一对旋转维度都有自己的波长。高频维度在相邻位置之间就会产生明显角度变化,低频维度可能要经过数千或数万个 token 才完成一次周期。当序列远超训练长度时,模型会遇到训练中从未出现过的相位组合;部分维度还可能转过多个周期,使不同远距离位置产生混叠。
因此,把配置里的 max_position_embeddings 从 8192 改成 131072,并不会凭空得到一个可靠的 128K 模型。真正的长上下文扩展通常需要三个步骤:
- 调整 RoPE 频率或位置映射方式;
- 使用长序列数据继续训练或微调;
- 在检索、代码、长文问答和 needle-in-a-haystack 等不同任务上验证,而不是只看模型能否完成前向传播。
Hugging Face Transformers 当前已经统一支持多种 RoPE 变体,包括原始 RoPE、线性缩放、Dynamic NTK、YaRN、LongRoPE 和 Llama 3 风格缩放,并提供 partial_rotary_factor 控制实际参与旋转的维度比例。不同方案的共同目标,都是重新安排高频与低频维度在长序列中的变化速度。(github.com)
Partial RoPE 与 NoPE:主流方案正在变得更克制
Partial RoPE 是只旋转每个注意力头中部分维度、让其余维度保持不变的设计。 它背后的判断是:模型需要位置感知,但未必需要每一个特征都被位置相位调制。
部分维度保留原始内容表示,可以减少强位置约束对语义通道的干扰;旋转维度则继续为注意力提供距离信息。对于多模态模型、局部注意力模型和混合注意力架构,这种拆分尤其有吸引力,因为不同通道可能承担不同空间或时间尺度的任务。
NoPE 是不显式加入位置编码,而主要依赖因果掩码和网络内部状态学习顺序的方法。 NoPE 并不意味着模型完全没有顺序信息:因果掩码决定每个 token 能看到哪些历史 token,前面已经处理过位置的层也可能把顺序信号传递到后续层。
2026 年更值得注意的趋势不是全面抛弃 RoPE,而是混合使用。Raschka 对近期开放权重模型的整理显示,全层 RoPE 仍然占主流,但 Partial RoPE,以及部分层使用 RoPE、部分层跳过 RoPE 的架构正在增加。(magazine.sebastianraschka.com)
SmolLM3 就是一个具体案例:它每四层移除一次 RoPE,并在长上下文训练阶段把窗口从 4K 依次扩展到 32K、64K,同时逐步提高 rope_theta。这说明 NoPE 层不是独立魔法,真正有效的是层级结构、频率调整与长序列训练的组合。(huggingface.co)
RoPE、ALiBi 和绝对位置,应该怎么选
ALiBi 是在 Query-Key 注意力分数上加入与相对距离成线性关系的偏置方法。 它不旋转向量,也不维护位置 embedding 表,而是直接让距离更远的 token 获得更大的负偏置。
ALiBi 的优势是逻辑简单、外推行为直观;缺点是线性距离惩罚带有更强的先验,表达能力通常不如 RoPE 灵活。RoPE 对 Key 做的是与距离相关、同时依赖内容的旋转,ALiBi 更像是在所有内容关系之上统一收取一笔“距离税”。原始 ALiBi 实验曾展示训练 1024 长度、测试 2048 长度的能力,并报告相对更长序列训练节省约 11% 训练时间和显存。(arxiv.org)
| 方案 | 位置信息进入位置 | 是否有参数 | 长度外推 | KV Cache 适配 | 主要短板 | |---|---|---:|---|---|---| | 可学习绝对位置 | 输入 embedding 相加 | 有 | 较弱,受位置表限制 | 简单 | 长度固定,缺少相对归纳偏置 | | 固定正弦编码 | 输入 embedding 相加 | 无 | 可计算新位置,但性能无保证 | 简单 | 语义与位置过早混合 | | 传统相对位置 | 注意力分数或 Key/Value | 通常有 | 较好 | 实现较复杂 | 容易增加二维距离矩阵开销 | | RoPE | 旋转 Query 和 Key | 无 | 较好,但通常需要缩放与长训 | 很好 | 超长位置存在频率与相位问题 | | ALiBi | 注意力分数加线性偏置 | 无 | 强 | 很好 | 距离先验较硬,表达不如 RoPE 灵活 | | NoPE | 不显式注入 | 无 | 依赖架构与训练 | 最简单 | 稳定性和通用性仍需验证 |
如果是在固定长度分类任务上训练小模型,可学习绝对位置仍然足够;如果需要一个简单、无参数的教学基线,正弦编码最容易解释;如果长度外推优先级极高,又希望方案尽量直接,ALiBi 值得测试。
但对于新的通用自回归 LLM,RoPE 仍然是默认起点。它没有可学习位置参数,适配 KV Cache,容易和 FlashAttention 等高性能注意力实现融合,同时保留了比线性偏置更丰富的内容—距离交互。真正需要讨论的已经不是“要不要使用 RoPE”,而是“旋转多少维、在哪些层旋转、使用哪种频率缩放,以及训练时是否真的覆盖目标长度”。
一套更可靠的落地检查清单
实现 RoPE 时最重要的原则是复现权重所使用的坐标系统,而不是只复现数学公式。 对开发者而言,可以按照下面的顺序排查:
- 确认模型使用相邻配对还是前后半区配对,不能只看函数名称。
- 确认 RoPE 应用在 Q、K 的哪些维度,检查
partial_rotary_factor或 rotary dimension。 - 确认
rope_theta、原始训练窗口和目标推理窗口,三者必须一起解释。 - 确认缓存中保存的是旋转前还是旋转后的 Key,避免重复旋转。
- 确认 GQA、MQA 下 Query 头与 KV 头的形状广播正确。
- 确认 cos、sin 计算精度,特别是 32K 以上上下文。
- 确认模型是否真正经过长上下文继续训练,不能只相信配置文件中的最大长度。
- 同时测试短文本和长文本,避免扩窗后牺牲原始长度性能。
最后一个判断也很重要:长上下文能力不只由位置编码决定。注意力类型、训练数据中的长文比例、优化策略、KV Cache 精度、检索能力和模型是否学会跨段引用,都会影响最终效果。RoPE 解决的是坐标系统问题,不是让模型突然拥有完美记忆。
结论:RoPE 仍是默认答案,但不再是唯一答案
RoPE 的价值在于用很小的工程代价,把绝对位置转换成了注意力中的相对几何关系。 它比绝对位置表更适合扩展,比传统相对位置矩阵更适合 KV Cache,也比 ALiBi 提供了更动态的内容—距离交互。
但 2026 年的位置编码趋势已经出现变化:全量、全层 RoPE 正在让位于更细粒度的设计。Partial RoPE 试图保留不受位置调制的语义通道,RoPE-NoPE 混合架构尝试减少重复的位置约束,多维 RoPE 则把同一套旋转思想扩展到图像、音频和视频坐标。
对模型开发者来说,最务实的策略不是追逐一个“永不退化”的位置编码公式,而是把 RoPE 当成可调节的架构组件:先选择可靠的默认实现,再围绕旋转维度、层分布、频率缩放和训练长度做消融实验。位置编码只有几十行核心逻辑,却可能决定一个模型的上下文窗口到底是可用能力,还是写在模型卡上的营销数字。
参考来源
- Hugging Face Transformers:RoPE 工具实现:包含原始 RoPE、Dynamic NTK、YaRN、LongRoPE、Llama 3 缩放和 Partial RoPE 等实现细节。
- Hugging Face:Rotary Embeddings Utilities:介绍 Transformers 中统一的 RoPE 参数和缩放配置。
- Meta Llama Models:可用于检查 Llama 系列模型中的 RoPE 参数与注意力实现。
- Hugging Face:SmolLM3 技术说明:介绍 RoPE-NoPE 混合层、长上下文继续训练及
rope_theta调整策略。 - 知乎:Transformer 位置编码深度解析:中文梳理绝对位置、相对位置、RoPE 及相关数学原理。