Marimba:让语音先做决定
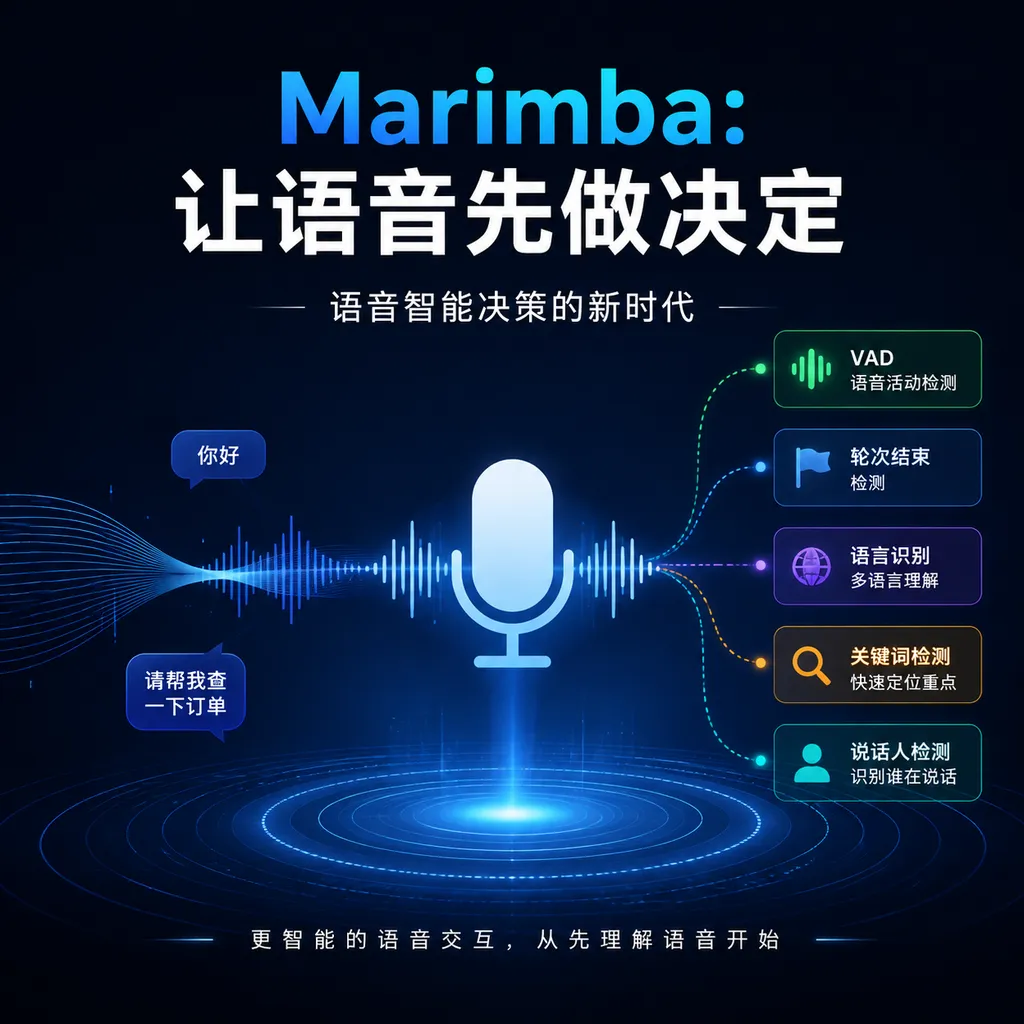
Marimba 基于冻结的 Qwen3-ASR-0.6B,将语音直接转成是非、选项或概率分数。它不是更小的转写模型,而是一层面向实时语音系统的低延迟决策组件。
Marimba 发布:语音模型不再急着转文字,而是先做决定
Marimba 是一个面向短音频与流式语音的轻量决策模型,它不以生成转写文本为主要目标,而是直接返回是非、选项或概率分数。 11 月 15 日,开发者 Solano Amadori 公布了 Marimba,并同步开放模型权重、代码、在线演示和基准数据;项目采用 Apache-2.0 许可证,可通过 marimba-audio Python 包部署,目前公开版本为 0.1.2。论文尚未正式上线,作者表示将在本周提交 arXiv。(reddit.com)
Marimba 最值得关注的地方,是它试图绕过语音应用里那条越来越臃肿的“音频—转写—大模型—结构化输出”链路。 如果一个语音助手只需要判断用户有没有说话、话是否说完、是否换了说话人,或者有没有提到某个关键词,那么先完整转写,再调用大模型分析文本,往往像是为了判断门铃响没响,先把整段监控录像写成文字报告。
“系统一”模型到底是什么
“系统一”模型是只做快速、受约束决策,而不负责生成开放式内容的模型。 这个名字借用了丹尼尔·卡尼曼对人类认知的划分:系统一负责快速、直觉式判断,系统二负责缓慢、审慎的推理。放到 AI 系统里,普通生成式大模型更像系统二,而 Marimba 只回答“是或否”“从几个选项中选一个”或者“给出一个概率分数”。
类型化决策是 Marimba 与传统语音大模型之间最核心的接口差异。 Marimba 当前支持三类返回值:noul 返回布尔判断,choice 从给定选项中选择并返回概率分布,score 返回一个连续概率。这里的 noul 是项目对 yes/no 决策类型的命名,不是自然语言回答。
| 决策类型 | 典型问题 | 返回结果 | 适合场景 |
|---|---|---|---|
| noul | 当前是否有人说话 | true 或 false | VAD、关键词触发、流程门控 |
| choice | 当前使用哪种语言 | 选项及各选项概率 | 语言路由、说话人数判断 |
| score | 用户是否已经说完 | 0 到 1 的概率 | 抢话控制、轮次结束判断 |
类型化输出的价值不是“模型不会犯错”,而是模型不会把输出格式搞错。 Marimba 仍可能把两个人判断成一个人,也可能漏掉一个罕见关键词;但它不会输出一段解释、Markdown 或无法解析的 JSON,更不会在预设选项之外临时创造答案。对实时语音系统来说,结构稳定往往和准确率同样重要。
冻结 Qwen3-ASR,只训练小型决策头
Marimba 的底座是冻结的 Qwen3-ASR-0.6B,新增能力主要来自编码器读出层、问题条件化头和解码器假设评分。 所谓冻结,是指 Marimba 没有重新训练 Qwen3-ASR 的全部约 6 亿参数,而是复用底座已经学到的声学和语言表征,再用较小的任务头读取其中的信息。(github.com)
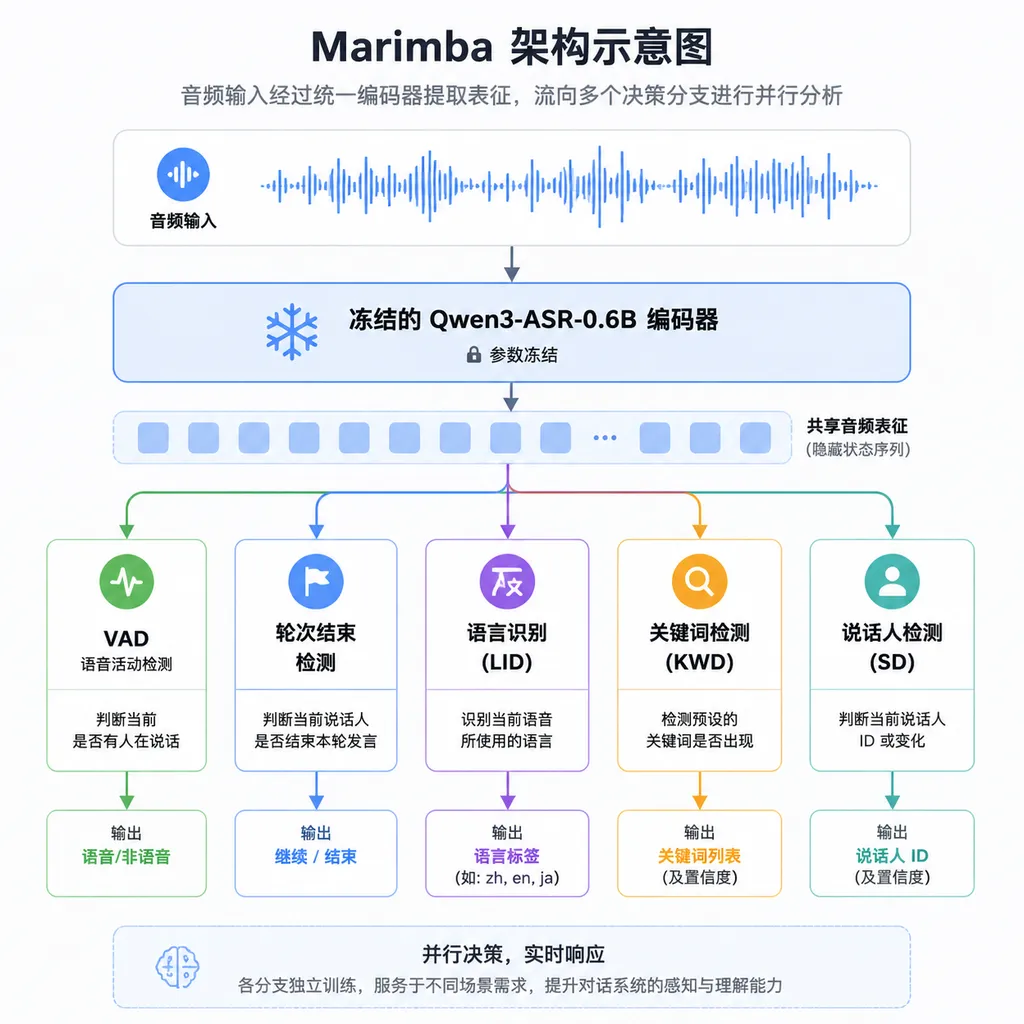
同一段音频只需经过一次编码器,就可以同时服务多个决策问题。 这与为 VAD、轮次结束检测、语言识别和说话人变化分别部署四套模型不同,Marimba 会共享 Qwen3-ASR 的音频编码结果,再把不同问题分配给对应的决策通道。这种设计减少了重复计算,也让语音 Agent 的工程结构更简单。
不同任务并没有被强行塞进同一种推理方法。 语音活动、轮次结束、同一说话人和说话人变化等任务,主要由冻结编码器上的线性层或小型 MLP 完成;语言识别直接利用 Qwen3-ASR 原生的语言分数;关键词检测则检查贪心解码与 4 条 Beam Search 假设中,有多少条包含目标词。
| Marimba 任务 | 主要实现方式 | 是否依赖 ASR 解码器 | |---|---|---| | 轮次结束 | 冻结编码器上的小型读出层 | 否 | | 语音活动 | 问题条件化分类头 | 否 | | 同一说话人 | 比较音频窗口前后两部分 | 否 | | 说话人变化 | 比较最后 2 秒与此前 6 秒 | 否 | | 语言识别 | Qwen3-ASR 原生语言分数 | 是 | | 关键词检测 | 贪心结果加 4 条 Beam 假设 | 是 |
这种混合架构解释了为什么不同问题的延迟差距可以达到两个数量级。 在单张 NVIDIA L4、BF16、Batch Size 为 1、8 秒音频窗口的测试中,轮次结束判断的 P95 延迟为 13.31 毫秒,语音活动检测为 15.77 毫秒,语言识别为 160.80 毫秒,而关键词检测达到 2349.14 毫秒。(github.com)
| 问题 | P50 延迟 | P95 延迟 | |---|---:|---:| | 轮次结束 | 12.23 ms | 13.31 ms | | 语音活动 | 14.40 ms | 15.77 ms | | 语言识别 | 153.67 ms | 160.80 ms | | 关键词检测 | 1399.44 ms | 2349.14 ms |
Marimba 的“轻量”主要体现在决策路径短,而不是所有任务都能在十几毫秒内完成。 不需要解码文字的编码器任务确实很快,但关键词检测仍需运行 ASR 解码并生成多条候选,因此 P95 延迟超过 2.3 秒。把 Marimba 描述成全面实时的语音决策模型并不准确,它更像一组共享底座、快慢分层的语音判断通道。
基准表现:强项是 VAD 和说话人变化
Marimba 在语音活动和说话人相关任务上的公开结果,已经足以支撑真实产品原型。 其语音活动检测在 AMI 数据集上的 AUROC 为 0.995,在 VoxConverse 上达到 0.9996;同一说话人判断分别达到 0.998 和 0.996;说话人变化检测分别达到 0.966 和 0.980。(huggingface.co)
Marimba 的说话人数判断优于项目选取的 pyannote 3.1 基线,但仍不适合替代完整的说话人分离系统。 在 AMI 和 VoxConverse 上,Marimba 的人数分类准确率分别为 0.778 和 0.859,对应的 pyannote 3.1 结果为 0.738 和 0.836。不过 Marimba 只输出 0、1、2、3+ 四档,并且容易低估三人以上的情况。
| 任务 | AMI | VoxConverse | 备注 |
|---|---:|---:|---|
| 语音活动 AUROC | 0.995 | 0.9996 | 默认阈值 0.225 |
| 同一说话人 AUROC | 0.998 | 0.996 | 不输出人物身份 |
| 说话人变化 AUROC | 0.966 | 0.980 | 比较窗口前后片段 |
| 说话人数准确率 | 0.778 | 0.859 | 容易低估 3+ |
轮次结束检测说明 Marimba 有用,但没有神奇到能消灭领域适配。 它在 Smart Turn v3.2 测试集上的 AUROC 为 0.930,低于 Smart Turn 自身在分布内测试中的 0.982;到了分布外的 ICSI 会议数据,Marimba 得分为 0.716,与对比方案的 0.712 基本打平。
校准是 Marimba 真正面向工程部署的关键能力。 在 ICSI 数据上,每折使用 200 个带标签窗口进行校准后,轮次结束任务的期望校准误差 ECE 从 0.200 降至 0.011。准确率决定模型会不会选对,校准则决定“模型说自己有 90% 把握”是否真的接近 90%;后者直接影响系统是否应该立即执行、等待更多音频,还是把任务交给更大的模型。
它不是 ASR,也不是完整的 Audio LLM
Marimba 是语音控制平面的决策组件,而不是新的通用语音基础模型。 它虽然运行在 Qwen3-ASR-0.6B 上,但默认输出不是逐字转写;它也不能像端到端 Audio LLM 那样回答音频内容问题、理解情绪背后的复杂语义,或者生成自然语言解释。
| 方案 | 主要输出 | 延迟特征 | 优点 | 局限 | |---|---|---|---|---| | 传统 VAD | 是否存在语音 | 通常最低 | 成熟、便宜 | 只能判断有无语音 | | ASR 加规则 | 转写文本后匹配规则 | 取决于解码长度 | 可审计、易调试 | 容易受转写错误影响 | | ASR 加生成式 LLM | 文本、JSON 或工具调用 | 通常最高 | 泛化能力强 | 成本高、格式可能漂移 | | 端到端 Audio LLM | 文本或语音回答 | 较高 | 能理解复杂音频语义 | 对简单判断明显过重 | | Marimba | 是非、选项、概率 | 编码器任务较低 | 输出稳定、共享一次编码 | 任务范围有限 |
Marimba 与底座 Qwen3-ASR 的关系,更像“传感器加控制器”,而不是“旧模型的小版本升级”。 Qwen3-ASR-0.6B 本身支持 30 种语言和 22 种中文方言,可统一执行流式与离线识别;官方数据称其在并发数为 128 时可达到 2000 倍实时吞吐。Marimba 没有取代这些转写能力,而是把底座内部表征改造成可直接驱动程序逻辑的信号。(github.com)
对语音 Agent 有什么实际价值
Marimba 最明确的应用场景,是解决实时语音 Agent 在“什么时候听、什么时候停、什么时候回答”上的控制问题。 当前不少语音机器人拥有很强的生成模型,却仍会在用户停顿半秒时抢话,也会在背景电视出现人声时误触发;问题通常不在主模型不会聊天,而在外围的语音状态机不够可靠。
一次编码同时判断多个状态,可以降低语音系统的组件碎片化。 一个实时客服 Agent 可以在同一个 8 秒窗口上同时查询:当前是否有人说话、用户是否已经完成表达、语言是哪一种、说话人是否发生变化,以及是否提到了“退款”或“取消”等关键词。程序随后根据概率阈值选择继续收音、切换语言模型、结束当前轮次或升级人工处理。
Marimba 也适合作为大模型前面的低成本门控层。 当置信度足够高时,系统直接执行简单动作;当置信度不足或问题超出能力范围时,再调用更大的 ASR、说话人分离模型或 Audio LLM。这种分层设计的意义不只是节省算力,更重要的是把关键控制逻辑从生成式模型的不确定文本中剥离出来。
项目已经提供 Pipecat 和 LiveKit Agents 集成,说明其目标并不止于论文基准。 Marimba 可作为 Pipecat 的用户轮次结束分析器,也可作为 LiveKit Agents 的轮次检测组件;流式模式接收单声道 16 kHz 音频,并按设定的 hop 间隔输出最新决策。(github.com)
限制比宣传语更值得看
Marimba 当前最明显的限制,是所有决策只描述音频窗口的最后 8 秒。 更长的音频虽然在部分接口中可以输入至 30 秒,但超过 8 秒的解码上下文尚未经过验证;说话人相关问题还要求窗口中必须有完整的 8 秒有效音频,否则直接返回 None。
关键词分数不能被当成严格校准后的出现概率。 当前实现检查 5 条解码假设中有多少条包含目标词,因此 0.8 更接近“5 条候选中有 4 条命中”,并不意味着真实世界里有 80% 的概率说过这个词。罕见人名、品牌名和专业词汇仍会继承 ASR 的漏识别问题。
Marimba 也没有提供完整说话人日志或身份识别能力。 它能判断窗口前后是否可能属于同一个人、是否发生换人,以及人数属于哪个区间,但不会给每位说话人分配稳定 ID,也不会生成带时间轴的 diarization 结果。
通用环境声音分类目前基本不可用。 官方模型卡明确表示声音与场景分类尚未支持,相关分类头在 CochlScene 上接近随机水平;个人信息检测也仍是实验功能,需要调用方自行提供文本 PII 检测器。
OpenAI Hub 观点:方向正确,但别把它当万能语音模型
Marimba 的价值在于重新划分语音模型的工作边界,而不是刷新一个新的 ASR 榜单。 过去一年,语音模型的发展重点集中在更低 WER、更长音频、更自然的全双工对话;Marimba 则提出另一个现实问题:大量语音应用根本不需要模型“回答”,只需要模型快速、稳定地做一个小决定。
这类模型可能成为语音 Agent 的“反射神经”,而主力大模型继续充当大脑。 反射神经不负责理解整场会议,但需要在几十毫秒内判断用户是否还在说话;大脑可以花更长时间组织回答,却不应该承担每一次静音检测和轮次切换。
Marimba 当前最能打的能力是 VAD、说话人变化和低延迟轮次判断,最需要改进的是关键词通道和跨场景校准。 13 至 16 毫秒的编码器任务延迟很有竞争力,但 2.35 秒的关键词检测 P95 延迟,会限制其在即时唤醒和超低延迟告警中的使用。项目也没有声称所有任务都达到实时标准,这种克制反而值得肯定。
最终决定 Marimba 能否被广泛采用的,不是“系统一”这个新标签,而是它能否持续增加经过验证的决策通道。 如果未来能够加入情绪强度、打断意图、对话角色、噪声状态和更可靠的关键词检测,同时保持一次编码、多任务共享的结构,它会比又一个通用 Audio LLM 更容易进入真实产品。
参考来源
- Marimba 发布帖:作者公布项目定位、开源协议、安装方式及论文计划。
- Marimba GitHub 仓库:包含推理包、架构说明、集成方式、延迟数据与限制说明。
- Marimba 模型卡:包含各任务评测结果、许可证、训练数据和模型限制。
- Marimba Benchmark:公开评测数据与基准结果。
- Qwen3-ASR GitHub 仓库:Qwen3-ASR-0.6B 的官方能力、语言覆盖、推理模式及性能说明。