Meta用200个模型拆解视觉编码
Meta FAIR 与 NYU 的最新研究发现:多模态模型可以跳过视觉编码器预训练,但不能取消视觉专用参数;将这些参数放进语言骨干的早期层,效果不输独立编码器,首字延迟还可降低约13%。
Meta FAIR 与纽约大学在 11 月 12 日发布了一项大规模对照研究:团队从零训练了超过 200 个多模态大语言模型,试图回答一个长期被架构差异掩盖的问题——多模态模型究竟需要一个预训练视觉编码器,还是只需要给视觉信息留出专门的计算能力?
论文给出的答案相当明确:视觉编码器的独立预训练不是必要条件,但视觉专用参数不能少。 更进一步,这些参数甚至不必组成一个位于语言模型之前的独立编码器;把它们嵌入语言骨干的前几层,同样能获得接近甚至略高的视觉问答成绩,并缩短图像请求的首字延迟。(arxiv.org)
这不是一次普通的架构微调,而是在重新定义所谓“原生多模态”:视觉和语言可以更早融合,但让两种模态从头到尾争抢完全相同的一套参数,目前看来并不是好主意。
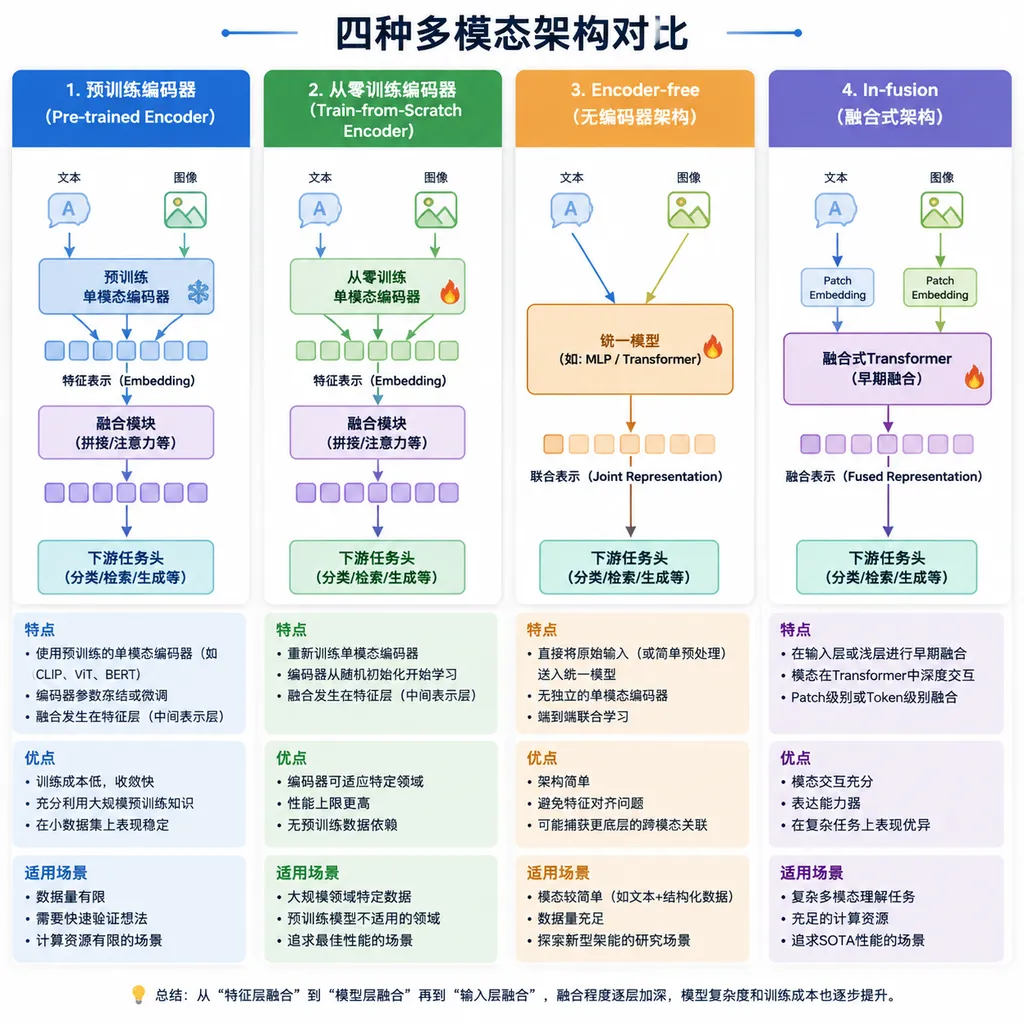
视觉编码器其实捆绑了三个问题
视觉编码器是将图像切分为视觉 Token,并把像素转换为语言模型可处理特征的神经网络模块。 在 CLIP、SigLIP 以及大量 LLaVA 式多模态系统中,视觉编码器通常先在图文对或图像识别数据上完成预训练,再通过投影层连接到语言模型。
问题在于,一个传统视觉编码器实际上同时捆绑了三种设计选择:
- 视觉先验:编码器是否接受过独立的图像或图文预训练。
- 视觉专用容量:是否存在一组只处理视觉 Token、不服务文本 Token 的参数。
- 融合前处理:这些视觉参数是否必须位于语言模型之前,先处理完图像再进入多模态骨干。
过去的模型往往一次性改变三个变量。例如,Encoder-free 模型不只是取消了预训练,也取消了独立视觉参数和融合前处理;而采用 SigLIP 的模型则同时拥有视觉先验、专用参数和前置编码器。只比较最终跑分,很难知道究竟是哪一个因素在发挥作用。
当前头部实验室的路线也并不统一:Gemma 4 12B 取消了传统独立编码器,Kimi K3 保留编码器但选择与语言模型一起从零训练,Inkling 2 Small 则重新引入了编码器。不同模型的数据、训练预算和语言骨干差异太大,公开成绩无法形成有效对照。(alphaxiv.org)
Meta FAIR 与 NYU 这项研究的价值,正在于把三个问题拆开了。
| 架构方案 | 独立视觉预训练 | 视觉专用参数 | 位于语言骨干之前 | |---|---:|---:|---:| | 预训练编码器 | 是 | 是 | 是 | | 从零训练编码器 | 否 | 是 | 是 | | Encoder-free | 否 | 否 | 否 | | In-fusion | 否 | 是 | 否 |
In-fusion 是一种把视觉专用分支直接放入多模态骨干早期层的架构。 所有 Token 仍然经过共享的注意力层和前馈网络,但视觉 Token 会额外经过只属于视觉的注意力投影和 FFN 分支;文本 Token 完全不会调用这些新增参数。
换句话说,它没有在语言模型门口设置一座独立的“视觉翻译站”,而是在模型内部的前几层为图像开了一条专用处理通道。
200多个模型,统一计算预算
全生命周期计算量是训练最终模型所消耗的全部计算,包括编码器预训练、语言预训练和多模态训练。 这项研究最重要的方法设计,是不再把现成视觉编码器的训练成本视为“免费资产”。
团队让所有组件从随机初始化开始,在相同数据、骨干架构和训练方案下进行比较。主要实验使用 Qwen3 风格的 1.7B 和 4B 骨干,并分配约 0.4B 参数作为视觉容量;扩展实验覆盖 0.6B 至 6.4B 的骨干规模,训练预算则从约 6.5×10²⁰ FLOPs 延伸至 2.9×10²² FLOPs。
模型首先使用 224×224 图像进行预训练,随后在 Cambrian-7M 上进行三轮视觉指令微调,评测分辨率提高到 448×448。视觉成绩来自 16 个 VQA 基准,覆盖通用问答、知识、OCR、图表和视觉中心任务;文本成绩则由 12 个常识推理、科学问答、阅读理解和知识基准组成。(unbundling.github.io)
这种实验控制很关键。一个预训练编码器如果额外看过数百亿图文样本,本质上已经携带了大量外部计算和数据;只计算后续多模态训练成本,会让它在对比中获得不公平优势。
结论一:预训练让图像分类更强,却没有让VQA更强
视觉先验是编码器在进入多模态训练之前,从图像分类、自监督学习或图文对齐任务中学到的特征。 研究团队分别测试了 MetaCLIP 对比学习、WebSSL 自监督学习,以及 Cap、CapPa 两种图像描述目标。
结果并不支持“预训练越充分,多模态理解越好”的直觉。在全生命周期计算量相同的条件下,四种预训练编码器最多只能追平与语言模型联合从零训练的编码器;在 4B 骨干的最大训练预算下,MetaCLIP 方案反而落后从零训练编码器 1.8 个平均 VQA 点。
团队还做了一个更激进的实验:不再把编码器预训练计入预算,相当于免费赠送视觉先验。MetaCLIP 的预训练计算量从 1.4×10²¹ FLOPs 增加至 9.0×10²¹ FLOPs,扩大约 6.4 倍;ImageNet 线性探测准确率也从 80.4% 提高到 84.4%。但这些提升没有稳定转化为更高的 VQA 成绩。(unbundling.github.io)
这说明图像分类能力和多模态问答能力并不是一条简单的线性链路。编码器更擅长判断“这是一只狗”,不等于模型更擅长理解“狗站在桌子的哪一侧”“图表第三季度增长多少”或者“图片中的文字与问题有什么关系”。
对模型团队而言,这意味着单独训练视觉编码器可能不是最有效的预算分配方式。如果最终目标是 VQA、文档理解和多模态推理,把计算量直接投入联合训练,可能比先造一个漂亮的 ImageNet 模型更划算。
但“预训练不必要”不能被误读为“外部视觉数据没有价值”。论文中的预训练编码器与其他方案看到的是同一批训练图像;现实中的 SigLIP 2 等编码器可能使用远多于目标模型的数据。研究只能说明:在数据和总计算受控时,独立预训练阶段没有表现出不可替代的价值。
结论二:Encoder-free省掉的不是模块,而是视觉能力
Encoder-free 是让图像 Patch 经过简单映射后,直接进入语言骨干处理的多模态架构。 它的吸引力很直接:模块更少、训练流程更统一,也更接近“所有模态都是 Token”的原生多模态叙事。
实验结果却给 Encoder-free 泼了一盆冷水。在 1.7B 骨干上,它比从零训练编码器低 4.1 至 6.4 个平均 VQA 点;在 4B 骨干上,差距为 2.8 至 6.8 个点。从 0.6B 扩展到 6.4B 后,这一差距仍然存在。根据团队拟合的缩放规律,Encoder-free 大约需要 3 倍计算量,才能追上带视觉专用容量方案的 VQA 水平。
研究人员随后把编码器省下的 0.4B 参数全部还给语言骨干,分别增加模型宽度、深度,或者同时增加两者。结果是文本任务有所改善,但平均 VQA 最多只增加 0.4 点。
| 1.7B骨干方案 | 视觉专用容量 | 平均VQA | |---|---:|---:| | 从零训练编码器 | 0.4B | 44.4 | | Encoder-free | 无 | 39.0 | | 增加共享FFN宽度 | 0.4B共享参数 | 40.1 | | 所有Token共用独立分支 | 0.4B共享参数 | 42.3 | | 前8层视觉专用分支 | 0.4B视觉参数 | 45.0 |
这组数据说明,问题不是模型总参数不够,而是视觉 Token 没有自己的计算空间。把预算塞进共享语言层,文本 Token 会占用这些能力,视觉 Token 仍然需要在同一组参数中竞争表示容量。
更丰富的 Patch 映射也只能部分缓解问题。受 Gemma 4 启发的两层投影把平均 VQA 从 39.0 提高至 40.5,仍明显低于编码器的 44.4。四层分层 MLP 只有在输入分辨率提高到 640×640、并将图像压缩成相同的 256 个 Token 时,才能追上编码器。
因此,一些被称为 Encoder-free 的模型,实际上并没有真正取消视觉专用计算,而是把它藏进了 Patch Stem、分层 MLP 或其他图像压缩模块。名称可以叫 Encoder-free,参数不会凭空消失。
结论三:视觉参数要放得早,但不必放在模型外面
早期视觉容量是部署在骨干前几层、只供视觉 Token 使用的参数。 研究人员把同样的 0.4B 参数放在不同位置,得到的差异比是否预训练更大。
当视觉专用 FFN 分支位于 28 层骨干的前 8 层时,平均 VQA 达到 45.0,略高于独立编码器的 44.4;如果把参数平均分散到全部层,成绩降至 39.4;分散到其中 8 层为 37.6;全部放在最后 8 层则只有 35.1。
OCR 和图表任务对位置尤其敏感。早期视觉分支取得 36.0 分,Encoder-free 只有 25.2 分,相差 10.8 点。一个合理解释是,图像 Token 刚进入模型时仍接近原始 Patch,需要尽早完成局部纹理、空间结构、字符和图表元素的抽取;等它们在共享骨干中传播二十多层后,再追加视觉能力已经太晚。(unbundling.github.io)
这里真正重要的结论不是“编码器应该被删除”,而是“编码器的功能可以被重新安置”。独立视觉编码器是一种实现视觉专用容量的方式,但不是唯一方式。
首字延迟降低13%,工程价值可能比跑分更重要
首字延迟(TTFT)是从请求到达服务端,到模型生成第一个输出 Token 所需的时间。 独立视觉编码器必须先完成整张图片的计算,语言骨干才能开始工作,这形成了一个串行阶段。
在单张 H200、16 个并发请求、每个请求包含一张 448 像素图像和 256 个文本 Token 的测试中,0.401B 视觉预算下,独立编码器的 TTFT 为 210 毫秒,In-fusion 为 182 毫秒,延迟降低约 13.3%。视觉参数预算继续增加时,独立编码器的额外耗时增长得更快。(alphaxiv.org)
对聊天机器人、GUI Agent 和实时视觉助手而言,182 毫秒与 210 毫秒并不是决定产品成败的差距,但它揭示了一个更重要的方向:多模态推理不一定需要“编码器完成后,语言模型再启动”的严格流水线。视觉计算进入骨干后,系统有机会减少模块切换、调度等待和中间特征搬运。
与此同时,In-fusion 也不是免费午餐。它要求推理框架支持按 Token 类型路由参数,视觉请求和纯文本请求需要走不同分支;批处理、张量并行和推理内核都可能变得更复杂。它省掉了外部编码器,却把工程复杂度移进了 Transformer Block。
这项研究改变的是预算观,不是宣判编码器死亡
这篇论文最有价值的地方,是把多模态架构争论从“有没有编码器”推进到“视觉专用计算应该放在哪里”。 从实验结果看,最佳方向并不是完全共享,也不是继续迷信一个昂贵的预训练视觉塔,而是联合训练、专用路由、早期融合。
对于准备从头训练多模态模型的团队,一个更务实的配方已经出现:
- 不必默认先训练 CLIP 或 SigLIP 式编码器,再启动多模态训练。
- 不能因为追求架构统一,就让视觉和文本从第一层开始共享全部参数。
- 视觉专用容量应优先放在骨干早期层,而不是平均铺满整个网络。
- 评估视觉架构时,应计算编码器预训练在内的全生命周期 FLOPs。
- 推理评测不能只看吞吐量,还应测量图片请求的 TTFT 和并发调度成本。
这项研究仍有清晰边界。实验主要基于稠密模型,最大骨干为 6.4B;预训练图像以 224×224 为主;核心指标是 VQA 和文本理解,而不是图像生成、视频理解、机器人控制或超高分辨率文档解析。外部编码器如果带来额外数据、检测能力或高分辨率特征,仍可能具备优势。
但就目前证据而言,单独预训练视觉编码器已经不再是多模态模型的默认正确答案。更准确的判断是:视觉不一定需要独立的大脑,但必须拥有自己的神经回路,而且这条回路越早介入越有效。
参考来源
- Hugging Face Papers:Unbundling Multimodal Vision Encoding — 论文摘要、作者信息与社区讨论页面。
- Reddit r/MachineLearning:作者发布的研究总结 — 包含实验设置、关键成绩和作者对主要结论的概括。