世界模型第一次真正联机了
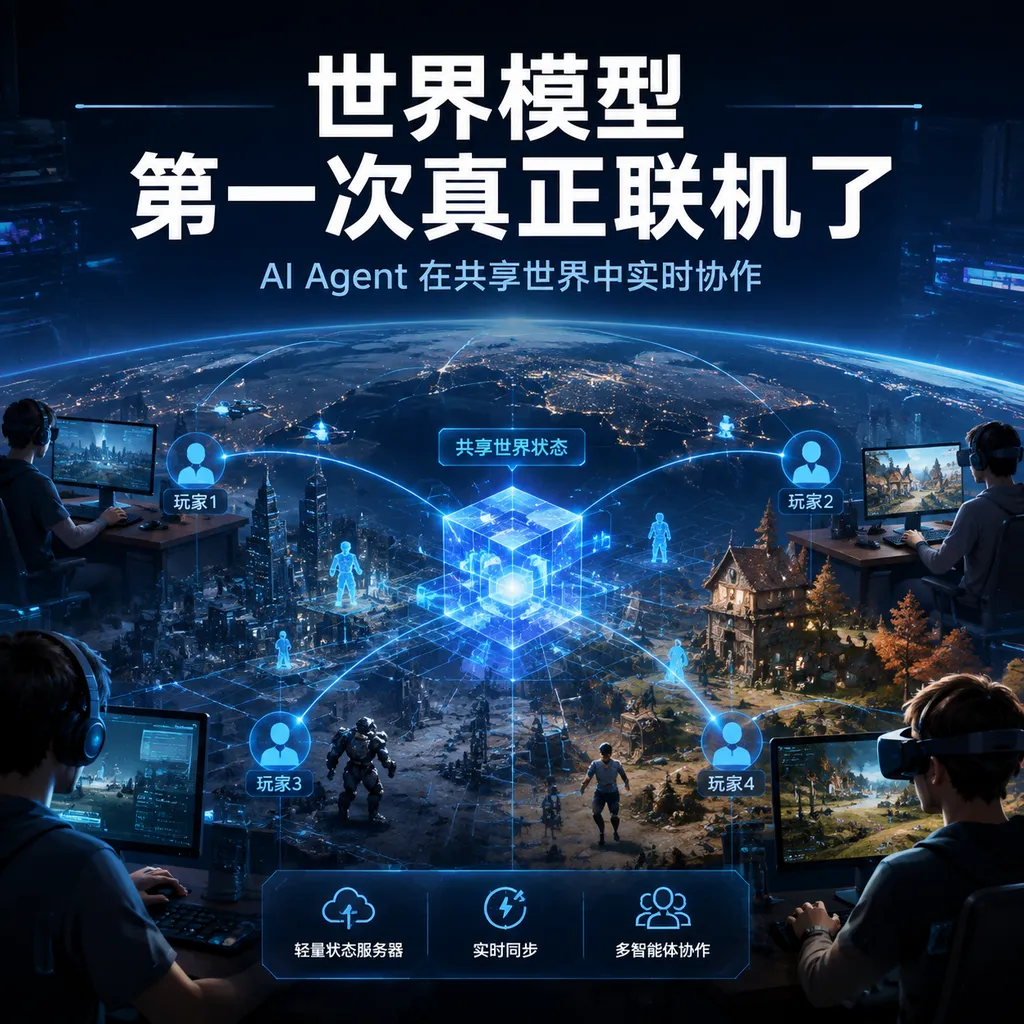
vor.tech 推出多人世界模型游戏:服务器只同步状态,每位玩家用本地 GPU 实时生成自己的第一人称画面。画质仍粗糙,但它首次跑通了生成式游戏从单人演示到多人共享世界的关键闭环。
世界模型第一次真正联机了
11 月 15 日,世界模型团队 vor.tech 开放了一款可实际联机的生成式 FPS 游戏:服务器负责同步玩家位置、生命值和动作等游戏状态,但不负责渲染最终画面;每位玩家的电脑则运行一套本地世界模型,根据共享状态、个人操作和历史帧,实时生成属于自己的第一人称视角。
这不是把 AI 生成的视频推流给多名观众,而是让多台 GPU 各自“想象”同一场比赛。
项目目前处于免费公开测试阶段,Windows 版本要求 NVIDIA RTX 3080 或更高规格显卡,同时提供实验性的 Mac 版本。开发团队承认,它现在只有一张小地图、手枪玩法,画面细节也远未达到原版《CS:GO》的水平,但多人可以进入同一局游戏,相互移动、瞄准和射击。(reddit.com)
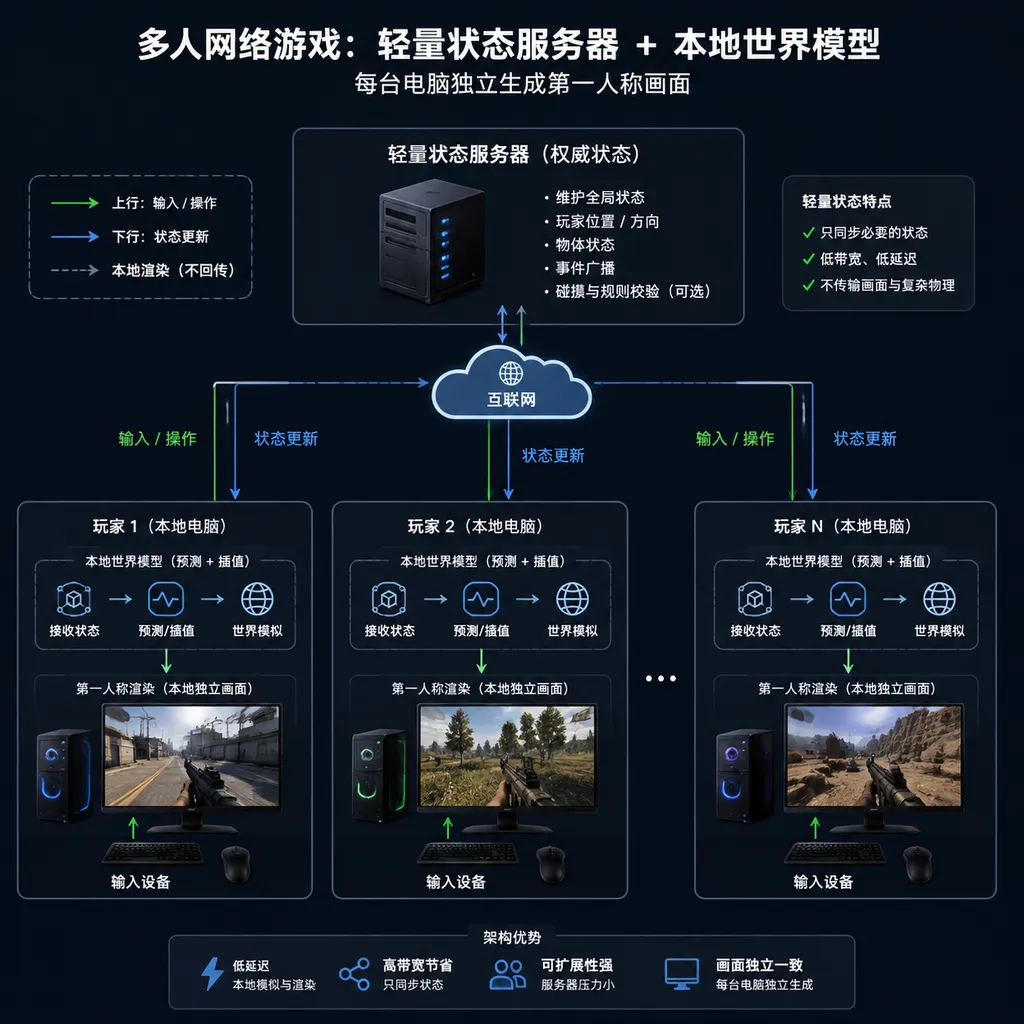
服务器不画画面,只负责让大家活在同一个世界
世界模型是能够根据环境状态、历史观察和动作,预测世界下一步变化的生成模型。 在游戏场景中,它不只是生成一段看起来像游戏的视频,还需要理解按键、鼠标移动、角色位置、武器状态和伤害结果,并迅速生成与操作相匹配的下一帧。
vor.tech 这次采用的方案可以概括成“中心化状态、分布式渲染”。轻量服务器维护一份权威游戏状态,并把相关状态发送给不同玩家;客户端收到状态后,将服务器状态、玩家动作以及此前生成的画面一起输入扩散 Transformer,由模型预测和绘制下一帧。
这一架构保留了传统多人游戏最重要的部分:所有玩家共享一套可同步、可验证的逻辑状态。模型可以把墙面画得模糊,甚至偶尔把枪的轮廓画歪,但它不能随意决定某个玩家是否中弹,因为生命值、位置和伤害等结果仍由共享状态约束。
换句话说,vor.tech 并没有让神经网络独自“梦出”整个游戏规则,而是把模型放在了渲染器的位置。它更像一个会根据游戏状态即时作画的神经图形客户端,而不是完全取代引擎的黑箱模拟器。
多人联机为什么比单人世界模型难得多
多人世界模型是能够在同一共享状态下,为多个独立玩家持续生成相互一致视角的世界模型。 它面对的问题,不只是多生成几路视频,而是确保不同视频中的事件具有因果关系。
单人世界模型只需要回答一个问题:玩家向左走之后,下一帧应该长什么样。多人游戏却必须同时回答更多问题:玩家 A 能否在自己的视角中看到玩家 B?A 开枪后,B 的画面是否在正确时间出现受击反馈?B 躲到墙后,A 的模型是否还会凭历史画面继续生成一个不存在的人?
如果让每个客户端完全独立生成世界,这些模型很快就会产生分歧。一个客户端可能认为敌人已经转过墙角,另一个客户端却仍然把敌人留在原地。传统多人游戏依靠服务器权威状态解决这一问题,vor.tech 也采用了类似原则,只不过客户端不再使用确定性的图形管线渲染状态,而是用生成模型把状态翻译成画面。
这种设计的价值在于,它没有强求多个生成模型逐像素保持一致。玩家 A 和玩家 B 本来就处在不同位置、拥有不同视角,因此两边的像素无需相同;系统真正需要保持一致的是更高层的事实,例如角色在哪里、谁开了枪、谁受到了伤害。
这是一次很务实的工程取舍。相比训练一个可以同时生成十路视角、内部完成全部跨玩家通信的巨型模型,把共享事实交给服务器、把视觉生成留在本地,更容易控制网络带宽和推理成本,也更接近现有游戏基础设施。
3958 小时训练数据,关键不是规模,而是对齐
多视角对齐数据是指同一时刻的多个玩家画面、动作输入和游戏状态能够准确对应的数据集。 这类数据是训练多人世界模型的基础,因为模型必须知道同一个事件在不同位置和视角下分别会呈现什么结果。
vor.tech 在 Reddit 发布帖中称,模型使用了约 3958 小时的 10 人《CS:GO》机器人对战数据,所有玩家视角和输入均以 16 Hz 对齐。当前 Hugging Face 数据集卡给出了更细的统计口径:数据包含 9515 场 5v5 机器人比赛、218768 个回合和 1.95 亿行状态事件,状态部分约对应 3390 小时游戏时间;视频部分包含 255712 段第一人称视频,合计约 3280 个 POV 小时,总体积约 1.07 TB。两个页面的小时数口径并不完全相同,可能分别统计了训练版本总量、游戏时长和单玩家视角时长。(reddit.com)
数据集的视频规格只有 256×256、16 FPS,场景也集中在 aim_map_usp_s 这一张地图。每个 16 Hz 时间点都记录了十名玩家的动作和状态,包括 WASD 移动、开火、换弹、跳跃、鼠标视角变化、坐标、朝向、生命值、护甲、武器与弹药数量。数据集还提供攻击者与受击者之间的伤害矩阵。(huggingface.co)
真正有价值的不是“几千小时”这个数字本身,而是帧、动作与状态之间的精确对应。普通游戏录像只能告诉模型画面发生了什么,却不能可靠解释画面为什么发生变化。vor.tech 的数据把 state[i] + action[i] → state[i+1] 这一关系显式保留下来,还对一帧渲染延迟进行了校正,使模型可以学习鼠标移动、射击操作和游戏状态之间的因果映射。(huggingface.co)
它和 Matrix-Game 4.0 不是同一种突破
神经渲染游戏是由传统代码维护规则和物理状态,再由生成模型将结构化画面转换成最终视觉效果的游戏。 2026 年 10 月发布的 Matrix-Game 4.0 已经展示了这条路线:游戏引擎处理玩法、物理和输入,因果视频模型把低多边形 RGB 画面实时转换成更精细的视觉结果。
Matrix-Game 4.0 的公开数据更亮眼。其官方 GitHub 显示,在 864×480 分辨率下,RTX 5080 稳态吞吐量最高可达 67 FPS,RTX 5070 Ti 最高可达 58 FPS,不过该数字不包含视频输入输出时间。它的重点是单卡高帧率神经渲染,而 vor.tech 这次的重点是多个客户端如何在共享状态下分别生成视角。(github.com)
| 方案 | 世界状态由谁维护 | 最终画面由谁生成 | 多人同步方式 | 当前优势 | 当前短板 | |---|---|---|---|---|---| | 传统多人游戏 | 游戏服务器与客户端引擎 | 固定图形管线 | 同步对象、物理和事件 | 画面稳定、延迟低、规则可靠 | 内容制作成本高,视觉资产固定 | | Matrix-Game 4.0 | 可执行游戏引擎 | 本地因果视频模型 | 当前重点不是多人联机 | 864×480 下可达数十 FPS,场景更完整 | 仍依赖结构化引擎画面,硬件要求较高 | | vor.tech 多人世界模型 | 轻量权威服务器 | 每位玩家的本地扩散 Transformer | 服务器同步状态,客户端独立生成视角 | 跑通多人共享生成世界 | 仅一张小地图、手枪玩法,细节和稳定性有限 |
这两条路线并不冲突。Matrix-Game 4.0 更像是把传统游戏的实时渲染器替换成视频模型,vor.tech 则进一步追问:当每个玩家都拥有一个不同的生成式渲染器时,大家还能不能玩同一场游戏?
答案目前是“可以,但只是刚刚可以”。
真正的突破不是画质,而是系统边界
vor.tech 这次最重要的进展,是证明多人生成式游戏可以不依赖服务器集中生成全部视频。 如果服务器要为十名玩家分别运行模型并生成十路画面,算力成本会随着玩家数量快速增长,视频流还会带来额外带宽和编码延迟。
把生成任务放到玩家本地之后,服务器只需要处理结构化状态和操作指令。理论上,新增一名玩家主要增加状态同步开销,而不会要求服务端再增加一整套视频生成算力。客户端承担了最昂贵的推理,这和传统 PC 游戏由玩家显卡负责渲染的商业结构很接近。
但本地生成也带来了新的问题。首先是硬件差异:RTX 3080 用户和更高端显卡用户可能拥有不同帧率与生成延迟,如何保证低性能客户端不会在竞技对抗中持续吃亏,需要新的延迟补偿机制。
其次是可信度。传统游戏可以检查客户端的位置、速度和射击行为,但世界模型还可能产生视觉幻觉。假如模型漏画了遮挡物,玩家可能看到原本不该看见的目标;如果不同版本的模型对暗处、烟雾或角色轮廓处理不同,生成质量本身就会变成竞技公平性的一部分。
再次是长期一致性。扩散 Transformer 会参考历史帧,而历史帧本身也是模型生成的。局部错误可能沿时间不断累积:墙上的纹理发生漂移,角色外观逐渐变化,武器和手臂短暂融合。权威状态可以保证玩家确实站在墙后,却不能自动保证模型每一帧都把墙画对。
这意味着,生成式多人游戏可能需要两层反作弊:一层验证动作和状态,另一层验证模型、权重及推理输出是否符合允许的视觉边界。这是传统游戏很少需要处理的新问题。
RTX 3080 能跑,但离大众化仍有距离
消费级本地推理是指模型直接在玩家个人电脑的 GPU 上运行,而不是依赖云端服务器完成生成。 vor.tech 将最低门槛放在 RTX 3080,说明团队已经把模型压缩到了 2020 年高端消费卡可以承受的范围,但这仍不是“所有老电脑都能玩”。(reddit.com)
RTX 3080 的门槛会直接限制测试人群,也让笔记本电脑、集成显卡和大多数掌机暂时无法参与。实验性 Mac 版本是一个积极信号,但项目尚未公开不同芯片、不同显存容量下的帧率和端到端输入延迟,因此现在还不能把它和成熟 FPS 游戏的体验放在同一维度比较。
数据本身也限制了模型能力。训练数据来自机器人,而不是人类玩家;地图只有一张,武器主要是 Glock-18 和 HK P2000,机器人也不会使用完整的移动与战术操作。模型学到的是一个非常窄的《CS:GO》子空间,而不是通用 FPS 规则。Hugging Face 页面还明确将数据限定为非商业研究使用,游戏画面版权归 Valve,项目也不受 Valve 官方认可。(huggingface.co)
因此,这个测试版更适合被视为一项系统验证,而不是一款准备挑战《CS2》的游戏产品。
生成式游戏终于从“能操作”走向“能共同操作”
交互式世界模型过去解决的是人在生成视频中行动,而多人世界模型要解决的是多个人在同一个生成世界中彼此影响。 后者是更接近真正游戏、虚拟社区和多智能体仿真的一步。
如果这套架构继续扩展,未来每位玩家看到的画面甚至不必采用完全相同的美术风格。服务器只维护“这里有一堵墙”和“敌人在坐标 X”,客户端可以把同一状态渲染成写实 FPS、低多边形动画或其他视觉风格。个性化渲染不再只是滤镜,而可能成为模型层面的实时重构。
它也可能改变游戏内容的生产方式。开发者可以先构建简单、低成本、可验证的状态空间,再用世界模型补足环境细节、动画和视觉表现。传统游戏引擎不会消失,但它可能从“负责每一个像素”退回到“负责世界中真正发生了什么”。
vor.tech 目前的画面不够精细、玩法不够丰富,硬件门槛也不低。可它已经跑通了一个重要闭环:十人对局数据训练世界模型,轻量服务器同步权威状态,多台本地 GPU 同时生成不同视角,玩家最终可以进入同一个 AI 生成的世界互相射击。
对世界模型行业来说,这比又一个画质更好的单人演示更值得关注。生成视频已经不稀奇,让不同的人在生成视频里真正碰见彼此,才是这次的新东西。
参考来源
- Reddit:vor.tech 多人世界模型游戏发布帖:项目团队介绍联机架构、硬件要求、开放测试状态与当前限制。
- Hugging Face:CS 5v5 世界模型训练数据集:包含比赛数量、视频规模、状态字段、动作字段、对齐方法和授权限制。
- GitHub:Matrix-Game 官方项目:用于比较引擎状态驱动的神经渲染路线、支持硬件和公开吞吐量数据。