一行权重,让推理模型提前收工
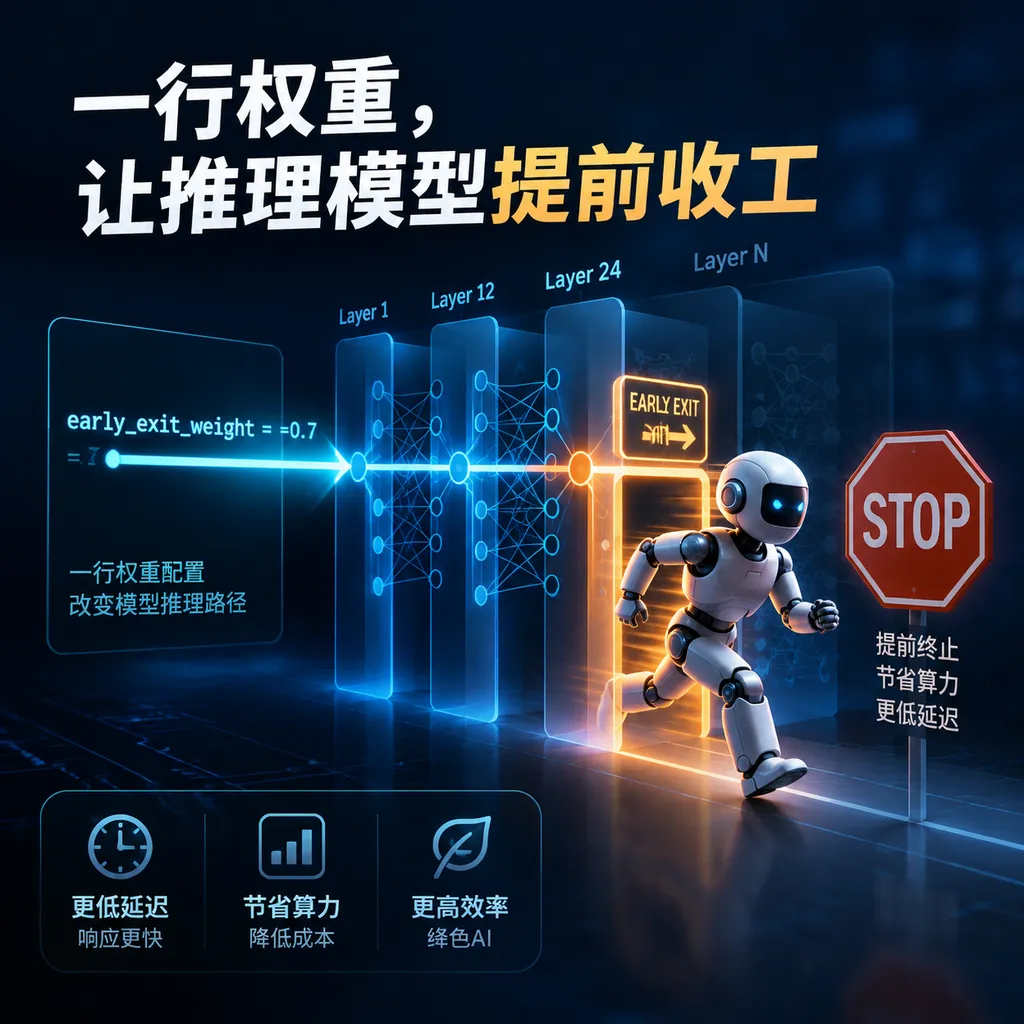
研究者把线性探针折叠进 `</think>` 对应的输出权重,让模型自行识别“答案已经稳定”的时刻。初步测试中,Qwen3.5-4B 推理 Token 减少 54%,但样本规模和跨领域泛化仍是明显短板。
一行权重,让推理模型提前收工
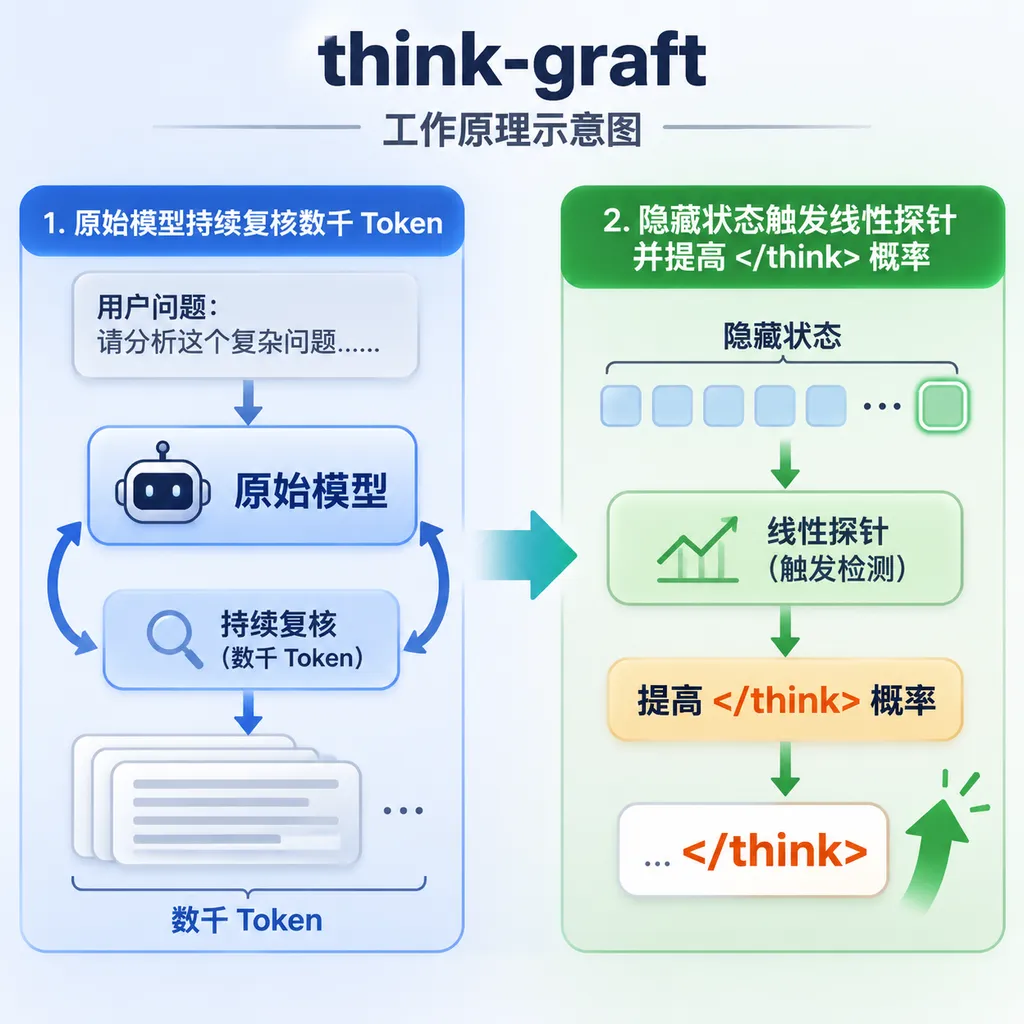
11 月 15 日,一名研究者公开了名为 think-graft 的实验:只修改推理模型输出层中 </think> 对应的权重,就能让模型在判断答案已经稳定后主动结束思考,不需要微调,也不需要为推理引擎增加新的控制代码。
这项实验最吸引人的地方,不是又提出了一套 Early Exit 框架,而是把原本需要在推理流程外部运行的“停止判断器”,直接塞回了模型权重里。修改后的模型仍是一份普通 GGUF 文件,可以在原版 llama.cpp 中运行。(reddit.com)
Early Exit 是一种根据当前任务难度和模型状态,动态提前终止后续计算的推理优化方法。 过去的 Early Exit 通常是在 Transformer 的中间层挂分类头,或者在生成过程中持续检查置信度;think-graft 则盯上了推理模型本来就会输出的结束标记 </think>。
一句话概括:不是从外面喊模型“别想了”,而是让模型内部代表“我已经想完”的信号变得更容易触发。
它到底改了什么
推理模型的输出层是一个把隐藏状态映射为词表概率的矩阵。 模型每生成一个 Token,都会先计算当前隐藏状态 h,再让词表中每个 Token 对应的权重行与 h 做内积,从而得到该 Token 的 Logit。
因此,</think> 是否出现,本质上由输出矩阵中的一行决定:
logit(</think>) = w · h
think-graft 的做法,是先找到一个能够识别“模型已经得到答案、正在重复检查”的线性方向 g,再把它乘以强度系数 β,叠加到 </think> 的权重行:
w' = w + βg
修改后,</think> 的 Logit 变成:
logit'(</think>) = w · h + β(g · h)
线性探针是一个利用隐藏状态预测特定属性的简单线性分类器。 当 g · h 较高时,说明当前隐藏状态更接近“答案已经稳定”;当模型仍在真正解题时,这个值应该较低,对正常 Token 分布的影响也相对有限。
这里有一个容易被标题掩盖的细节:所谓“免训练”并不意味着完全不需要数据,而是不进行梯度训练和参数微调。
研究者先让模型运行 24 道数学题,记录思考阶段每个 Token 对应的隐藏状态;随后人工标记正确答案首次出现后的段落边界,将其视为“已经完成、只是在复核”,其他位置则视为“仍在工作”。最后使用带收缩估计的线性判别分析,也就是 shrinkage LDA,通过闭式线性代数计算出方向 g。(reddit.com)
因此,更准确的表述应该是:这是一种无梯度、少样本拟合的权重编辑,而不是零数据魔法。
为什么一行权重就够了
think-graft 能够只动一个输出方向,是因为它不负责重新求解问题,只负责判断何时输出停止标记。
如果要改变模型的数学能力、代码能力或知识范围,一行输出权重显然不够。但“停止思考”是一个非常窄的动作,其执行接口已经存在于模型词表中:</think>。
这相当于一辆本来就有刹车的车。研究者没有重新设计发动机,也没有增加新的制动系统,只是把刹车踏板连接到了一个能够判断“已经到站”的传感器上。
这种设计还有一个工程优势:只有 </think> 的 Logit 被改变,其他 Token 之间的相对概率保持不变。 在模型真正输出 </think> 之前,原始模型与修改模型会沿着相同的生成轨迹运行。
研究者因此不必反复运行修改后的模型,就能基于原模型保存的隐藏状态,离线计算不同 β 值下 </think> 的准确概率,并搜索是否存在过早退出风险。最终在 Qwen3.5-4B 实验中选择的 β 为 14。
项目给出的一个案例很直观:模型在第 567 个 Token 已经出现正确答案,原始版本却一直思考到第 7415 个 Token;修改后,模型在约第 2000 个 Token 结束思考的概率达到 98%。(reddit.com)
初步结果很亮眼,但远未到下结论的时候
think-graft 的实验结果显示,推理模型中确实存在可被简单线性方向读取的“已经想完”信号。
在 8 道未参与拟合的 MATH-500 题目上,Qwen3.5-4B 原始模型与修改版本均答对 8 题,但总生成量从 34955 Token 降到 16080 Token,减少 54%;只计算思考阶段时,Token 降幅达到 60%。
在 3 道 AIME 2025 题目上,原始模型均在反复检查过程中耗尽 32768 Token 上限,最终成绩为 0/3;修改版本答对 2/3。
DeepSeek V4.1 Flash 的小规模实验同样给出了积极结果:7 道数学题中,原始版本答对 6 道,修改版本答对 7 道;在双方都答对的 6 道题上,Token 从 41559 降至 25112,减少约 40%。在一个构建网站的 Agent 任务中,思考 Token 从 13106 降至 2062,盲评得分则从 8.2 分上升到 9.5 分。(github.com)
| 模型与任务 | 原始版本 | think-graft | 变化 | |---|---:|---:|---:| | Qwen3.5-4B,8 道 MATH-500 | 8/8,34955 Token | 8/8,16080 Token | Token 减少 54% | | Qwen3.5-4B,3 道 AIME 2025 | 0/3,均耗尽 32K | 2/3 | 避免部分预算耗尽 | | DeepSeek V4.1 Flash,7 道数学题 | 6/7 | 7/7 | 小样本提升 1 题 | | DeepSeek Agent 网站任务 | 8.2 分,13106 思考 Token | 9.5 分,2062 思考 Token | 思考量减少 84% |
这些数字足够证明方法值得继续测试,却不足以证明它能够稳定改善推理模型。
项目目前每个设置基本只有一次运行,Qwen 的独立测试集只有 8 道 MATH-500 和 3 道 AIME,DeepSeek 数学测试也只有 7 道题。采样模型存在随机性,一道题的波动就可能明显改变准确率。
现阶段最可靠的结论不是“准确率提高了”,而是“输出层中的单个停止 Token 可以承载有效的状态依赖控制”。
它和 DEER、SyncThink 有什么区别
当前推理模型的 Early Exit 方法,大体可分为外部解码控制、内部激活监控和权重内置控制三条路线。
| 方法 | 停止信号 | 是否训练 | 是否修改权重 | 推理时额外逻辑 | 已报告效果 | |---|---|---:|---:|---:|---| | think-graft | 隐藏状态线性探针 | 无梯度拟合 | 是,只改停止方向 | 无 | Qwen 小样本 Token 减少 54% | | DEER | 转折点、试答与答案置信度 | 否 | 否 | 有,需要试答和回退 | CoT 减少 19.1%—80.1% | | SyncThink | 模型自身的推理切换信号 | 否 | 否 | 有,需要定制解码 | 平均 Token 2141 降至 656 | | NEAT | 退出相关神经元激活 | 否 | 否 | 需要监控内部激活 | 平均 Token 减少 22%—28% |
DEER 是一种在推理转折点生成试探答案,并根据答案置信度决定是否退出的动态框架。 它在 10 个推理基准和 11 个模型上报告了 19.1% 至 80.1% 的思维链长度降幅,同时准确率提高 0.3 至 5.0 个百分点。代价是推理系统必须识别转折点、生成试答、计算置信度,并在失败时回退继续思考。(huggingface.co)
SyncThink 是一种通过监控模型自身推理切换信号来结束冗余思考的无训练解码方法。 在三个 DeepSeek-R1 蒸馏模型的测试中,其平均 Top-1 准确率为 62.00%,高于完整 CoT 的 61.22%;平均生成量从 2141 Token 降至 656,延迟从 92.01 秒降至 28.68 秒。它不改权重,但仍需要在解码过程中运行监控逻辑。(huggingface.co)
NEAT 是一种通过追踪神经元级激活动态触发提前退出的方法。 论文在 6 个模型和 4 个推理基准上报告了 22% 至 28% 的平均 Token 降幅,同时维持准确率。它与 think-graft 都利用内部激活,但 NEAT 把监控留在推理系统中,think-graft 则把监控方向折叠进输出权重。(arxiv.org)
think-graft 的优势因此非常明确:部署简单。 一旦编辑完成,推理引擎不需要认识探针,不需要保存额外状态,也不需要支持回退或多次试答。
它的劣势也同样明确:控制策略被写死在权重中。 DEER 可以调整置信度阈值,SyncThink 可以替换监控策略,而 think-graft 如果要改变停止风格,通常需要重新计算探针并重新导出权重。
最大风险不是“停不下来”,而是“停早了”
Early Exit 的核心矛盾,是节省的计算来自删除原本用于复核和纠错的推理步骤。
推理模型的长思考确实充满重复,但重复并不总是无用。模型有时会先得到一个看似正确的答案,随后发现符号错误、边界条件遗漏或程序复杂度不成立。如果探针把“暂时确信”误判为“答案稳定”,Early Exit 会把本来能够自我修正的模型变成一个更自信的错误模型。
think-graft 的训练标签也带有明显的人为定义:正确答案已经在思考文本中出现,并不等于模型已经完成可靠推理。一道题可能在中途偶然写出正确数字,随后又发现推导不成立;代码任务更可能先给出表面可行方案,再在测试或依赖分析中暴露问题。
项目模型卡已经明确承认,该 Qwen 探针主要基于 22 条 MATH-500 思考轨迹拟合,当前验证也集中在数学领域,其他领域尚未测试。(huggingface.co)
跨领域泛化将决定这项技术是模型优化方案,还是只对特定数据分布有效的补丁。 数学题的“答案已经出现”较容易定义,但在代码生成、长文规划、搜索代理和工具调用中,完成状态更模糊。
例如,一个 Agent 已经写完页面,不代表任务结束:它可能还需要运行测试、检查移动端布局、验证链接,并根据报错修改文件。数学探针学到的“段落末尾加答案”模式,未必能识别这种开放式完成状态。
</think> 也未必真能让模型停止推理
输出 </think> 只是在文本格式上结束思考,并不保证模型内部已经切换到稳定的回答模式。
2026 年 9 月公开的一项研究发现,向推理过程强制插入 </think> 后,一些模型会在回答区域继续生成类似思维链的内容,甚至再次输出一个 </think>。研究者将这种现象称为“伪思维链终止”。
在 4 个推理模型、5 个基准和两类 Early Exit 方法上,提高后续 Token 对退出标记的注意力,可以减少重复出现的结束标记并缩短回答阶段;但提前截掉过多推理时,准确率仍可能下降。(arxiv.org)
这给 think-graft 提出了一个值得跟踪的问题:它提高的是模型主动选择 </think> 的概率,而不是从外部强行插入 Token,理论上可能比硬截断更自然;但模型是否真的完成内部模式切换,仍需要通过注意力、回答区行为和双 </think> 比例进行验证。
只看“思考 Token 变短”并不够。真正有价值的测试至少应同时报告最终答案准确率、回答阶段长度、二次 </think> 发生率、错误纠正次数,以及不同 β 下的风险—收益曲线。
这项实验真正值得关注的地方
think-graft 展示了一种“把推理策略编译进权重”的工程思路。
过去,模型优化通常有两种选择:要么重新训练模型,要么在外部推理框架里增加控制器。think-graft 提供了第三种可能——先从模型隐藏状态中识别一个可解释方向,再把这个方向写入已有 Token 的输出权重,让普通推理引擎天然执行这套策略。
这种方法未必只能用于停止思考。理论上,类似的权重编辑还可以改变模型请求工具、结束回答、切换语言或进入特定输出格式的倾向。它与传统提示词的区别在于,提示词通过上下文间接影响行为;权重编辑则直接改变特定动作在特定隐藏状态下的概率。
不过,越接近模型底层,越要警惕局部测试中的“看起来完全没副作用”。隐藏状态分布会随任务、语言、量化方式、上下文长度和采样参数变化。一个在 MATH-500 上干净分离的线性方向,到了真实 Agent 工作流中可能产生完全不同的触发边界。
对开发者而言,think-graft 目前更像一个值得复现实验的技术原型,而不是可以直接替换生产模型的通用优化。 它证明了停止时机可能比想象中更容易被线性读取,也证明了模型权重文件可以成为推理控制逻辑的载体。
如果后续能在更大测试集、更多领域和多次随机采样中保持 30% 以上的 Token 降幅,同时把准确率损失控制在 1 个百分点以内,这条路线会非常有竞争力。它省掉的不只是 Token,还包括改造 vLLM、llama.cpp 或其他推理框架的工程成本。
但在结果被独立复现之前,54% 和 84% 这些数字更适合被视为机会窗口,而不是性能承诺。
参考来源
- Reddit:Training-free early exit for reasoning models:作者于 2026 年 11 月 15 日发布的项目介绍、方法步骤与初步实验结果。
- GitHub:nextgen-user/think-graft:项目代码、完整实验日志、数学表达和可复现流程。
- Hugging Face:Qwen3.5-4B think-graft GGUF:编辑后模型、采样参数、测试结果及局限性说明。
- Hugging Face:Dynamic Early Exit in Reasoning Models:DEER 方法介绍及跨模型、跨基准的 Early Exit 结果。
- GitHub:iie-ycx/DEER:DEER 官方实现及针对 Qwen 模型置信度过高问题的调整。
- Hugging Face:SyncThink:通过推理切换信号减少 CoT Token 和推理延迟的方法。
- Hugging Face:NEAT:利用神经元激活动态实现免训练 Early Exit 的研究。
- GitHub:Spurious-CoT-Termination:分析
</think>未能真正终止推理及双结束标记问题的官方项目。