混元Hy4 Flash把成本打到5%
腾讯混元发布Hy4 Flash:总参数224B、每Token激活12B,支持多模态与100万Token上下文。它的重点不是刷新榜单,而是以超过150 tps的速度,把真实工作任务成本压至Hy4约5%。
混元Hy4 Flash把成本打到5%
腾讯混元在11月16日正式发布Hy4 flash,这是一款面向高频生产力任务的混合专家模型:总参数量224B,每个Token激活12B参数,支持多模态输入和100万Token上下文,官方解码速度超过150 tps。在腾讯自建的WorkIndex评测中,它完成单项任务的成本只有Hy4正式版的1/20,也就是约5%。
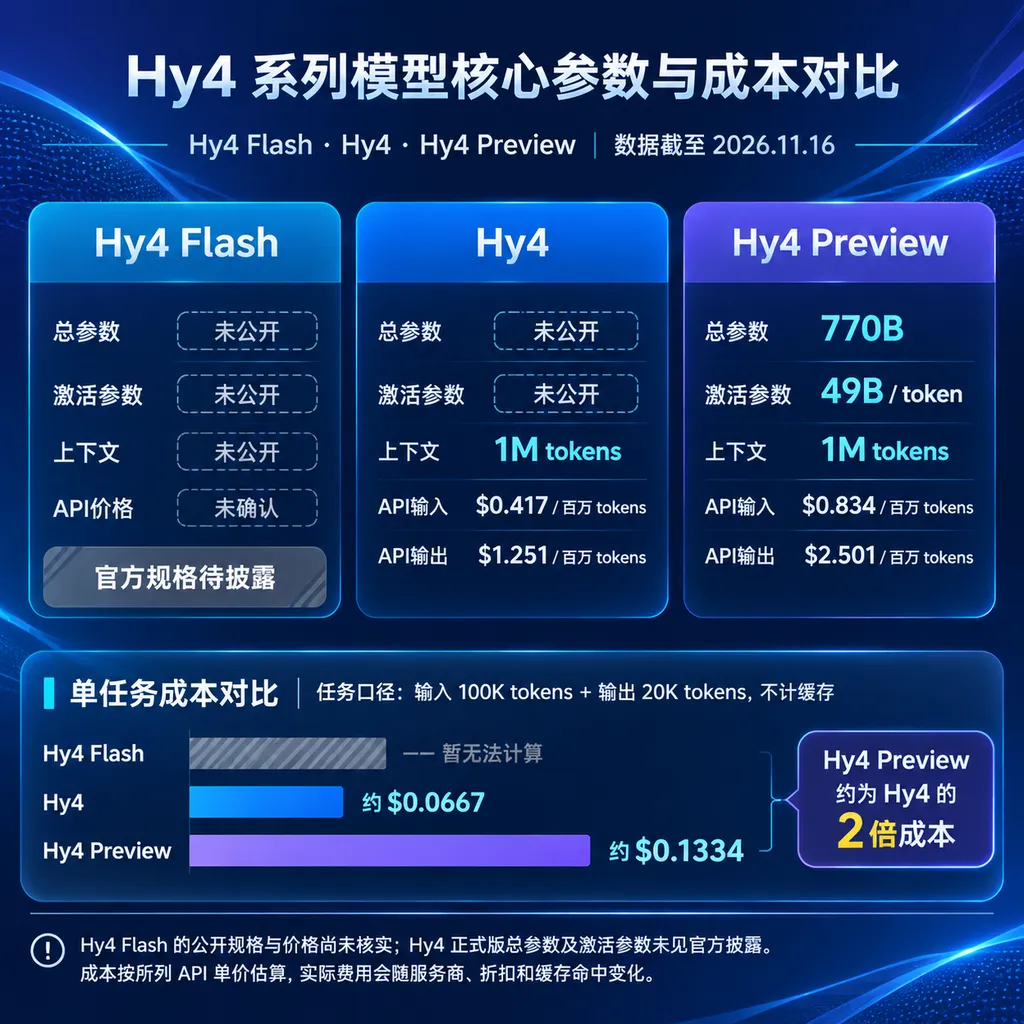
这次发布的重点并不是再造一个参数更大的旗舰模型,而是把Hy4已经具备的视觉、搜索、文档处理和Computer Use能力,塞进一个更快、更便宜的执行模型里。与总参数770B、激活49B的Hy4相比,Hy4 flash的总参数减少约70.9%,单Token激活参数减少约75.5%,但官方给出的综合任务效果仍略高于Hy4 preview。
224B不是运行时成本,12B才更接近
MoE是通过路由器为每个Token只选择部分专家参与计算的稀疏模型架构。 Hy4 flash虽然拥有224B总参数,但每个Token只激活12B参数,因此不能简单地把它当成一款224B稠密模型看待;从单Token计算量看,它更接近十几B级模型,但知识容量和功能覆盖又来自一个更大的参数池。
激活参数是模型处理单个Token时实际参与主要计算的参数规模。 Hy4 flash的12B激活参数只有Hy4的49B约24.5%,这直接降低了矩阵计算量、显存带宽压力和推理集群成本。对在线Agent而言,这种差异通常比总参数规模更重要,因为Agent一次任务可能连续生成数千甚至数万Token,还会多轮调用搜索、浏览器和办公软件。
| 模型 | 总参数 | 每Token激活参数 | 上下文 | 多模态输入 | 官方定位 | |---|---:|---:|---:|---|---| | Hy4 preview | 770B | 49B | 100万Token | 不支持视觉输入 | 前代预览旗舰模型 | | Hy4 | 770B | 49B | 100万Token | 支持 | 长程开发与高难度生产力任务 | | Hy4 flash | 224B | 12B | 100万Token | 支持 | 高频、低成本、低延迟任务 |
Hy4 flash还有64B参数来自Engram模块,这部分被计入224B总参数。Engram是一种查表式参数模块,它通过低成本的检索和映射扩充模型容量,而不是让所有知识都经过昂贵的神经网络逐层计算。 可以把它理解为模型内部增加了一套可训练的“快速索引”:常见模式不必每次都走完整计算路径,既保留容量,也减少算力开销。
这套设计的价值不只在实验室吞吐量,更在于大规模产品部署。腾讯已经把Hy4 flash接入WorkBuddy、元宝、企业微信、QQ、ima和Marvis等产品,同一个模型需要同时面对文档总结、图片理解、PPT生成、搜索整理和界面操作等不同负载,12B激活规模显然比49B更适合承担默认流量。
百万上下文保住了,但KV Cache被砍了
百万上下文是指模型一次请求最多能够处理约100万个Token的输入与输出窗口。 这个容量足以装入数十万字文档、大型代码仓库、多轮检索结果,或者由截图、表格和文本组成的复杂工作空间,但能“装下”并不等于能“便宜地处理”。
长上下文模型最现实的成本来自KV Cache。KV Cache是模型保存历史Token注意力中间状态的缓存,它避免模型在生成每个新Token时重新计算全部上下文。 上下文越长、并发越高,KV Cache占用的显存就越大;对于百万Token任务,它甚至可能比模型权重更早成为部署瓶颈。
腾讯称,Hy4 flash通过混合注意力、LatentMoE和Engram等架构,把KV Cache缩小到Hy3的1/24、Hy4的1/6。换句话说,在相同显存容量和上下文长度下,服务端理论上可以容纳更多并发会话,或者用更少的高带宽显存维持同等规模的长文档任务。
混合注意力是把完整注意力与局部、稀疏或其他低成本注意力机制组合使用的架构。 完整注意力擅长捕捉跨越很远的关联,但成本会随着上下文长度迅速增加;局部或稀疏注意力则把多数计算限制在更小范围内。二者混合的目标,是在关键层保留全局理解,在其他层减少不必要的全量扫描。
LatentMoE是把MoE路由和计算放到更紧凑潜在表示中的稀疏架构。 腾讯目前没有在本次发布信息中披露完整实现细节,但从官方给出的KV Cache数据看,它承担的任务并不只是减少激活参数,也包括压缩长上下文推理时需要保存和搬运的中间状态。
这里需要给百万上下文降降温。模型拥有100万Token窗口,并不意味着它在100万Token任意位置都能保持同等召回率,也不意味着企业应该把整个知识库不加筛选地塞进提示词。真正影响长上下文体验的仍是目标信息召回、跨文档证据关联、视觉内容解析和长任务状态保持,而这些能力需要独立评测,不能由窗口长度单独证明。
成本降到5%,不等于Token单价只有5%
单任务成本是完成一项端到端工作所消耗的模型费用、输出Token和运行时间的综合结果。 它与每百万Token报价不是同一个概念:一个模型即使Token单价不变,只要输出更短、推理更快、工具调用次数更少,最终完成任务的成本仍然可以明显下降。
腾讯在WorkIndex上的结果显示,Hy4 flash单项任务成本分别为Hy4 preview的1/13、Hy4的1/20,以及DeepSeek-V4.1-Flash-1017 max档忙时成本的1/8。按比例换算,Hy4 flash约为Hy4 preview成本的7.7%、Hy4的5%,以及对比版DeepSeek模型的12.5%。
| WorkIndex对比对象 | Hy4 flash单任务成本比例 | 换算结果 | |---|---:|---:| | Hy4 preview | 1/13 | 约7.7% | | Hy4 | 1/20 | 5% | | DeepSeek-V4.1-Flash-1017 max档忙时价格 | 1/8 | 12.5% |
Hy4 flash的成本优势来自预训练、后训练和推理三个阶段的共同优化,而不是单纯降价。预训练阶段通过稀疏架构减少实际计算和缓存;后训练阶段以Hy4作为教师进行自蒸馏,尽量把旗舰模型的能力迁移到更小的激活规模;强化学习则把端到端任务输出长度压缩了50%。
输出长度压缩50%是这次发布中很容易被低估的数据。Agent经常会生成冗长计划、重复复述网页内容,或者在工具调用之间输出大量中间说明,这些Token既增加费用,也拉长用户等待时间。如果任务结果质量不下降,输出从例如8000 Token缩短到4000 Token,输出费用和解码耗时都可能接近减半。
不过,输出更短不天然代表模型更聪明。压缩思维链和中间文本有可能让结果更直接,也可能隐藏推理缺口;真正应该观察的是任务成功率、事实准确率和最终交付物质量。腾讯称Hy4 flash在综合效果上略优于Hy4 preview,但没有给出这一差距的绝对分数,因此现阶段更合理的结论是“效果大致守住、成本显著下降”,而不是它全面超过了大模型旗舰版本。
Hy4正式版目前公开标准价格为每百万Token输入6元、输出18元、缓存命中输入0.3元。Hy4 flash的发布信息强调API价格显著降低,并给出WorkIndex单任务成本比例,但参考资料没有披露完整的长期标准价目表,因此不能把“Hy4成本的5%”直接换算成其Token单价。
| 项目 | Hy4公开标准价格 | Hy4 flash当前信息 | |---|---:|---:| | 每百万输入Token | 6元 | 长期标准价未在参考资料中明确 | | 每百万输出Token | 18元 | 长期标准价未在参考资料中明确 | | 每百万缓存命中输入Token | 0.3元 | 未明确 | | 限时活动 | TokenHub另有Hy4活动安排 | 2026年11月30日前API限时5折 |
价格口径必须区分标准单价、缓存价、限时折扣和任务成本。尤其是0.3元属于Hy4的缓存命中输入价格,并不是普通输入价格;而WorkIndex的1/20则是完成整个任务后的综合成本比例,也不是把6元或18元直接除以20得到的正式报价。
150 tps意味着它更像执行层模型
解码速度是模型在生成阶段每秒输出的Token数量,通常以tps衡量。 腾讯称Hy4 flash解码速度超过150 tps,如果这一数字能在真实并发和长上下文环境中保持,它已经足以显著改善搜索整理、PPT大纲、文档改写和简单前端生成的等待体验。
Hy4 flash在推理阶段组合使用了megakernel、4bit量化和dflash。Megakernel是把多个推理计算步骤融合进更少GPU内核调用的优化方式,主要作用是减少调度、访存和中间结果写回的开销。 对12B激活的MoE模型来说,计算单元本身变小后,路由和内核启动等固定开销会更加显眼,算子融合因此尤为重要。
4bit量化是用约4位精度存储或计算部分模型权重的压缩方法。 与常见的16位权重相比,理论权重存储量可下降约75%,但实际节省比例还会受到量化参数、未量化层、KV Cache和运行时缓冲区影响。量化的难点是保持精度,尤其是视觉理解、长上下文和工具调用对异常值较敏感,不能只看显存数字。
dflash是腾讯此次披露的推理加速组件之一。 目前公开参考信息没有给出它的完整技术定义、适用硬件和独立性能增益,因此更稳妥的理解是:150 tps来自模型架构、量化、内核融合和运行时协同,而不是某一个单点技术的结果。
这种优化路线说明Hy4 flash更适合充当产品里的默认执行层。简单检索、文档处理和界面操作由Flash承担,只有长程软件工程、复杂数学、模型研发等高难任务再升级到Hy4,可以同时控制平均成本和能力上限。这与越来越多AI产品采用的“快模型分流、强模型兜底”路线一致。
盲测接近Claude Haiku 5.5,但证据仍偏内部
腾讯为Hy4 flash组织了85名WorkBuddy内部用户盲测,覆盖27类、共259个日常工作任务。官方称其用户满意度接近Claude Haiku 5.5,同时单任务成本低于所有参评模型,任务完成时长也最短。
这组测试比单纯公开榜单更接近真实办公场景,因为它关注最终产物、单轮输出长度和端到端耗时,而不是只统计选择题或代码单元测试。然而,它仍然属于腾讯内部构建和组织的评测:任务分布、评分量表、模型具体版本、Claude对比价格、并发设置以及完整原始结果都未在参考信息中公开。
WorkIndex的价值在于提出了一个更符合Agent时代的评价方式。对深度搜索任务来说,模型多拿两分榜单成绩但要输出三倍Token、等待两倍时间,商业价值未必更高;对PPT和文档任务来说,能否一次生成可用产物,比回答某一道基准题更重要。
但WorkIndex暂时不能替代第三方基准。开发者还需要观察Hy4 flash在长上下文信息召回、视觉幻觉、网页操作成功率、代码可执行率和高并发吞吐方面的独立结果,尤其要验证官方所称的150 tps是在何种芯片、量化配置、上下文长度和并发条件下获得。
真正有用的场景,是高频但不值得上旗舰的任务
Hy4 flash最适合的并不是最难任务,而是数量大、流程长、每一步难度中等的日常工作。腾讯明确推荐的场景包括深度搜索、文档处理、PPT生成、简单前端展示和Computer Use,这些任务共同特点是输入材料多、工具调用频繁、对速度敏感,但通常不要求模型完成前沿数学证明或数小时的软件工程规划。
- 深度搜索: 读取多个网页和文档,去重信息、建立引用关系并输出结构化报告。
- 文档处理: 在几十万字材料中找条款、比较版本、提取表格和整理摘要。
- PPT生成: 从研究材料中形成大纲、页面文案和图表建议,并根据反馈快速重写。
- 简单前端: 生成活动页、数据看板或交互原型,而不是维护大型工程的长期依赖关系。
- Computer Use: 理解截图和界面状态,执行点击、输入、复制及跨应用搬运信息。
长程软件工程仍然应该优先交给Hy4等能力上限更高的模型。软件工程Agent需要持续理解仓库状态、运行测试、定位错误并多轮修改,任何一次错误都可能在后续步骤中放大;为了节省单轮成本而降低规划和纠错能力,最后可能产生更高的返工费用。
腾讯要卖的不是“小模型”,而是任务经济性
Hy4 flash的核心竞争力不是224B总参数,也不是100万Token窗口,而是把能力、速度和任务成本放进同一个优化目标。过去模型厂商更愿意展示MMLU、数学或代码跑分,现在腾讯用WorkIndex强调“完成一个工作任务要花多少钱、多久、输出多少”,这更贴近企业实际采购逻辑。
这条路线也暴露了大模型产品竞争的下一阶段:旗舰模型负责抬高上限,Flash模型负责承担流量。Hy4提供长程开发和复杂推理能力,Hy4 flash则用12B激活参数、缩小6倍的KV Cache和超过150 tps的速度,把这些能力送进聊天产品、办公软件和企业工作流。
截至11月16日,Hy4 flash已经上线腾讯云TokenHub、WorkBuddy、元宝、企业微信、QQ、ima和Marvis,并计划接入OpenRouter。用户可在2026年11月30日前限时免费使用WorkBuddy中的Hy4 flash,腾讯云TokenHub API同期提供限时5折活动。
现阶段最值得验证的不是它能不能答出更难的题,而是它能否稳定跑完更长的活。如果Hy4 flash确实能在接近Hy4 preview效果的同时,把任务成本压到Hy4的5%、输出长度减少50%,它会比一次榜单领先更有商业价值;如果长任务中频繁漏信息、工具操作失败或需要旗舰模型返工,那么纸面成本优势也会被迅速吃掉。
参考来源
- IT之家:腾讯混元Hy4 flash模型发布,224B总参数、12B激活 —— 汇总模型架构、WorkIndex成本、盲测结果、上线产品与限时活动信息。
- 知乎:腾讯混元Hy4正式版发布及价格口径分析 —— 补充Hy4参数、视觉能力、标准价格与缓存价格的区别。