duetto让音乐模型接上爵士
duetto 把预训练音乐 Transformer 变成实时爵士搭档:不改模型权重,只在采样时通过硬约束、概率偏置和乐句引用控制输出。
不训练新模型,先把旧模型管起来
近日,一款名为 duetto 的实时爵士合奏工具公开了代码和演示,它能在 MIDI 键盘演奏者身边承担独奏、和弦伴奏与 walking bass 等角色。演奏者弹奏时,duetto 可以同步 comping;演奏者停下来时,系统则接过空间开始独奏。
**duetto 是一个面向 MIDI 键盘的实时爵士合奏系统。**它没有重新微调底层音乐模型,而是直接使用 Thickstun 等人在 2023 年提出的预训练 Anticipatory Music Transformer,再在每次生成音符之前修改模型输出的 logits,以控制接下来允许出现什么音、什么音更可能出现。
截至 2026 年 11 月 16 日,开发者已经在 GitHub 仓库放出项目代码,并通过 Reddit 的 Machine Learning 社区介绍技术路线。项目代码可供非商业用途免费使用,但这种限制意味着它更准确的定位是“源码可用”,而不是可以不加区分地称为符合 OSI 定义的开源软件。
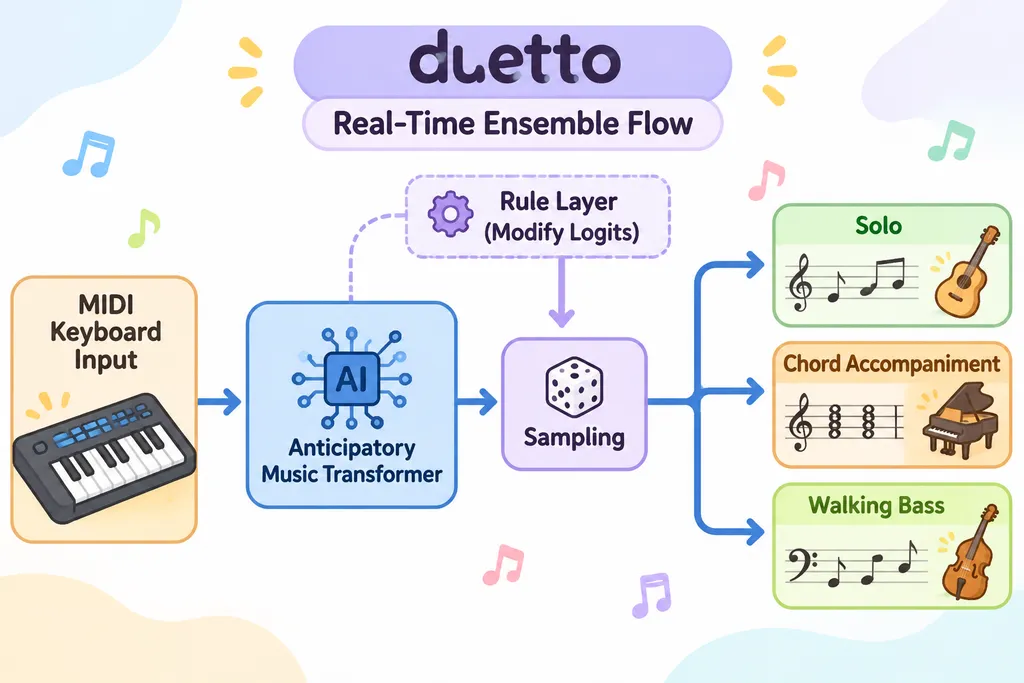
**duetto 最值得关注的地方不是又生成了一段爵士乐,而是把离线音乐生成模型改造成了可以被乐手打断、接话和约束的实时伙伴。**这条路线与继续堆训练数据、微调参数不同:底层模型负责提供音乐语言能力,外部控制层负责告诉它“这一拍应该做什么、不应该做什么”。
采样时控制,像给模型加一位现场乐队指挥
**采样时控制是指在不修改模型权重的情况下,于每一步生成时直接调整候选结果的概率分布。**语言模型生成文字时会为下一个 token 计算概率,音乐 Transformer 也会为下一个音符事件计算 logits;duetto 所做的,就是在真正抽样之前插入一层规则。
**duetto 把人类演奏和模型输出写进同一条事件序列。**在这条序列里,一个音符主要由起始时间、持续时长和音高描述,模型一次延续一个事件。人的 MIDI 输入不是生成结束后再混入的独立轨道,而是上下文的一部分;模型刚刚听到的演奏,会影响后续音符概率。
这种统一事件序列很重要。传统伴奏器通常按照预先编排好的 pattern 工作,能够稳定跟拍,却很难真正回应演奏者刚才弹出的旋律;纯生成模型则可能有变化,却容易无视乐手、和声与乐器职责。duetto 试图站在两者中间:让 Transformer 提供变化,让规则层守住合奏边界。
**规则层的第一种手段是硬掩码,也就是把不允许出现的候选直接设为不可采样。**例如,某只“虚拟手”还没轮到进入时,相关事件会被屏蔽;超出乐器音域的音高会被排除;walking bass 如果在不合适的拍点触发,也可以被禁止。
**规则层的第二种手段是软偏置,也就是提高合适候选的概率,但不把其他候选完全封死。**当前和弦的构成音可以获得加权,强拍上的导向音可以获得额外偏好,正在引用某段乐句时,下一个目标音也可以被推高概率。
硬掩码像交通法规,软偏置则像乐队领队的眼神。前者避免明显错误,后者塑造风格和方向;如果只有硬规则,音乐容易变成机械的和弦练习,如果只有概率偏置,模型又可能在实时演奏中突然跑出音域、错过低音落点,或者与演奏者抢占同一片空间。
“不微调”不等于“没有工程量”
**duetto 的无微调方案意味着底层 Anticipatory Music Transformer 的参数保持不变。**项目不需要为独奏、comping 和 walking bass 分别准备训练任务,也不需要重新制作大规模配对数据,把“输入旋律—目标伴奏”灌进模型。
**无微调真正省掉的是模型训练成本,而不是音乐系统设计成本。**开发者仍然要定义每个角色何时进入、位于什么音域、如何识别当前和弦、重拍应该优先哪些音,以及在人类继续弹奏或突然停下时如何切换行为。这些问题不在神经网络权重里自动消失,只是从训练阶段转移到了推理和产品层。
这一区别对 AI 应用开发者很有启发。许多垂直产品并不缺一个更大的基础模型,真正缺的是可验证的约束、状态机和实时交互策略。只要底模已经学会足够多的领域模式,采样时控制往往比再训一个专用模型更快,也更容易解释和调试。
**采样时控制的另一个优势是规则修改可以立即生效。**如果 walking bass 的音域不合理,开发者可以改动掩码;如果模型在某个和弦上过分偏爱根音,可以调整构成音与导向音的偏置。相比之下,微调后的行为往往分散在大量参数中,出现问题后难以定位究竟是哪批数据或哪段训练导致。
不过,这种方法并非免费午餐。规则越多,系统越像一个复杂的专家系统;规则之间还可能冲突,例如“优先延续乐句”与“当前和弦变化后优先落导向音”可能同时争夺下一音。工程上必须明确优先级,否则 logits 在多轮修改后可能只剩极少数候选,生成结果也会变得僵硬。
Anticipatory Music Transformer 提供了什么
**Anticipatory Music Transformer 是一种面向符号音乐续写与填充的预训练 Transformer。**它的核心能力不是把一句文字直接变成完整音频,而是在已有音符及异步控制信息的条件下,补全或继续音乐事件。
所谓异步控制,是指控制内容不必与模型正在生成的音符同时出现。例如,人类旋律可以先被指定,模型随后在其他声部和时间位置补上伴奏;创作者也可以接受、拒绝或修改模型提出的音符,再把结果作为后续生成的上下文。
**duetto 对底模的改造重点从“乐谱填空”转向“实时轮流说话”。**原模型已经具备根据音乐上下文预测后续事件的能力,duetto 则进一步规定谁在什么时候说话、以哪个音域说话,以及当前和声下哪些表达更合适。
这种思路与大型语言模型上的约束解码颇为相似。一个通用语言模型不必为了输出合法 JSON 而重新训练,系统可以在解码时限制下一个 token;duetto 只是把“合法格式”换成了拍点、和弦、音域和声部职责。区别在于,音乐的错误往往会在几十毫秒到几百毫秒内被耳朵察觉,实时调度的容错空间比普通文本生成更小。
乐句引用不是复制粘贴,而是概率牵引
**duetto 的乐句素材来自 Weimar Jazz Database 中的爵士独奏转录。**项目会使用经过切分的乐句,并在生成过程中通过概率偏置引导模型朝乐句的后续音符移动。
这并不是把数据库中的一整段 solo 机械贴到当前和弦上。按照开发者公开的方案,模型仍然逐事件生成,只是“被引用乐句的下一个音”获得更高概率;最终结果还要同时接受当前上下文、和声条件、音域限制和角色规则的共同影响。
**概率牵引比硬编码播放更适合即兴场景。**如果乐手突然改变节奏密度,或者上下文使原乐句不再自然,模型仍有机会偏离素材;如果完全锁死目标序列,系统就会退化为带触发器的 MIDI 片段播放器,而不是能根据现场内容继续生成的伙伴。
这项设计也带来一个值得持续观察的问题:系统何时是在引用一种爵士语汇,何时又过度接近数据库中的具体转录?目前公开介绍主要聚焦生成机制,并未给出大规模相似度分析、乐句复现率或版权风险评估。对于研究原型这不是致命缺口,但如果进一步产品化,素材来源、授权范围和输出相似度会成为必须正面处理的问题。
与实时音频模型不是同一条赛道
**duetto 属于符号音乐系统,而不是端到端音频生成器。**它输出的是音符级事件,通常还需要软音源、硬件音源或数字音频工作站把 MIDI 渲染成钢琴、贝斯和其他实际声音。
符号路线的优势是控制精确。音高、时值、拍点、音域和和弦音都能直接约束,错误也容易追踪;音频路线的优势则是音色、演奏技法和空间感可以一并生成,但精确控制某一个音落在哪一拍通常更困难,计算量也往往更高。
下面的比较不能被当作同一基准上的跑分,但可以说明几条音乐生成路线的取舍:
| 项目或模型 | 生成层级 | 控制方式 | 是否需要微调 | 实时定位 | 已公开的成本或性能信息 | |---|---|---|---|---|---| | duetto | MIDI/音符事件 | 采样前硬掩码、logits 偏置、角色规则、乐句引用 | 否,直接使用预训练 AMT | 面向键盘实时合奏,可独奏、comping、walking bass | 非商业用途免费;目前未见统一延迟、硬件占用或听感评测数据 | | Anticipatory Music Transformer | 符号音乐事件 | 异步控制、续写与 infilling | 已完成预训练 | 原始定位更偏交互式创作与填充 | 研究模型,duetto 将其作为底模使用 | | MusiConGen | 音频音乐 | 文本、和弦、节奏与 BPM 条件 | 需要高效微调 | 更偏受控生成,而非乐手间逐音符对话 | 论文强调可在消费级 GPU 上微调,但不能直接与 duetto 的 MIDI 延迟比较 | | Magenta RealTime 2 | 流式音频 | 文本、音频与 MIDI 条件 | 使用专门训练的实时架构 | 面向可演奏的实时音频生成 | 公开报道给出的控制延迟约为 200 毫秒,音频帧约 40 毫秒 |
duetto 目前缺少可复核的端到端延迟数字。“实时”是项目的产品目标和演示状态,但开发者尚未在公开材料中给出从 MIDI note-on、模型采样、事件调度到最终发声的中位延迟、P95 延迟,也没有列出标准硬件上的吞吐量。
这个缺口不能靠演示视频替代。爵士合奏对延迟极为敏感,而且 MIDI 输入延迟、模型推理延迟、音频缓冲和软音源延迟会叠加;在 160 BPM 下,一拍约为 375 毫秒,十六分音符约为 93.75 毫秒,几十毫秒的抖动就可能改变律动感。后续如果项目要证明其“实时”能力,至少应公开延迟分布、测试硬件、缓冲设置与连续演奏稳定性。
真正有价值的是可控,而不是生成得更多
**duetto 的产品判断是正确的:实时合奏首先要解决控制权,而不是无限生成。**演奏者不需要模型持续输出一堵音符墙,而是需要它知道什么时候让位、什么时候填充、什么时候稳住低音,以及什么时候接过独奏段落。
很多音乐生成产品仍然以“一次提示生成几十秒成品”为核心,这适合配乐草稿,却不适合现场合作。现场乐手关心的是能否抢拍、是否听到和声变化、能不能留白,以及系统出错后能否在下一拍恢复。duetto 把这些问题放进采样过程,而不是期待底模凭概率自行领会,这是它最务实的一点。
**duetto 的短板也同样明确:它目前更像技术原型,而不是成熟的虚拟乐队产品。**公开材料没有展示跨风格泛化、复杂转调处理、速度突变、断奏与踏板信息响应,也没有提供系统化的人类乐手盲测。演示中的《Autumn Leaves》能够说明系统跑通,却不足以证明它在不同标准曲、不同水平演奏者和长时间现场环境中的稳定性。
MIDI 输入也限制了部分音乐信息。音高、力度和时值容易数字化,但爵士演奏里的触键质感、微小时值偏移、音色变化、踏板细节和乐手之间的动态呼吸,并不都能被基础音符事件完整表达。对于电钢琴练习、教育和编曲草稿,这种取舍完全合理;对于追求真实乐队互动的专业舞台,它仍然需要更丰富的感知与音频层。
这条路线可能比专门微调更快落地
**duetto 证明了预训练模型的“最后一公里”可以发生在解码器外部。**当开发者掌握明确的领域规则时,不一定要为每种角色重新训练模型,而可以把可靠约束写成采样策略,让同一个底模在不同职责之间切换。
这种架构还具有较好的可组合性。未来系统可以增加节奏密度控制、演奏者意图识别、段落结构跟踪和动态难度调整,而不必每增加一个旋钮就重训模型。对教育产品而言,它甚至可以限制伴奏只使用某些和弦转位;对现场演出而言,则可以为贝斯、和弦与独奏设置不同的冒险程度。
**最值得期待的下一步是让规则从固定逻辑升级为可评估的实时策略。**系统可以根据演奏者的音符密度决定是否留白,根据近期冲突次数降低活跃度,或者在检测到乐句结束时再接管独奏。这样的策略未必需要更大的 Transformer,却能显著改善“像不像一个会听人的乐手”。
总体来看,duetto 不是一次基础模型突破,而是一项有明确产品洞察的推理层工程。它提醒行业:音乐生成的下一阶段不只是把歌曲做得更长、更像录音室成品,而是让模型在正确的时刻做正确的事,并把最终控制权留给演奏者。
参考来源
- duetto GitHub 仓库:项目代码、使用许可与实现说明,代码对非商业用途免费开放。
- Reddit:Steering a pretrained music transformer at sampling time into a real-time jazz partner:开发者对采样时控制、角色约束、乐句素材和实时合奏方式的介绍。