扫完12.7万篇论文,26%改动没用
SciMe Atlas 汇总 12.7 万篇 AI 论文的消融实验发现,26% 的模型改动按论文自己的数字也未带来明确收益。更值得警惕的是,66% 的论文至少包含一项无效改动。
截至 2026 年 11 月 17 日,一项针对 126,758 篇 AI 论文的系统性统计给模型研发泼了一盆冷水:研究者从论文消融实验中提取了 621,064 项被实际测量过的改动,其中 16% 让结果变差,10% 没有明确效果,合计 26% 未能按照论文自己报告的指标带来收益。
消融实验是通过移除、加入或替换模型组件,观察指标变化,从而判断某项设计是否真正有效的实验方法。 它本应回答论文中最朴素的问题:性能提升究竟来自新模块、新损失函数或新训练策略,还是来自更多数据、更大算力和更长训练时间?
这份名为 SciMe Atlas 的统计由 Latentic Labs 团队制作,覆盖 2016—2026 年间 ICML、NeurIPS、ICLR、CVPR、AAAI、ICCV、ECCV、TPAMI、IJCV 和 JMLR 等主要会议与期刊。团队称其完整读取了 126,758 篇论文,并在其中 110,393 篇论文里找到 621,064 项“被加入且被测量”的改动,包括增加一层网络、替换损失函数、扩大数据量、调整学习率、提高采样温度以及增加 LoRA 秩等。
这不是又一个评价“哪篇论文最强”的排行榜,而是一张相当罕见的失败地图。它没有用统一基准重新训练所有模型,而是直接整理作者在论文表格和消融章节中公开的数字,因此统计的是“作者自己的实验是否支持作者尝试过的改动”。
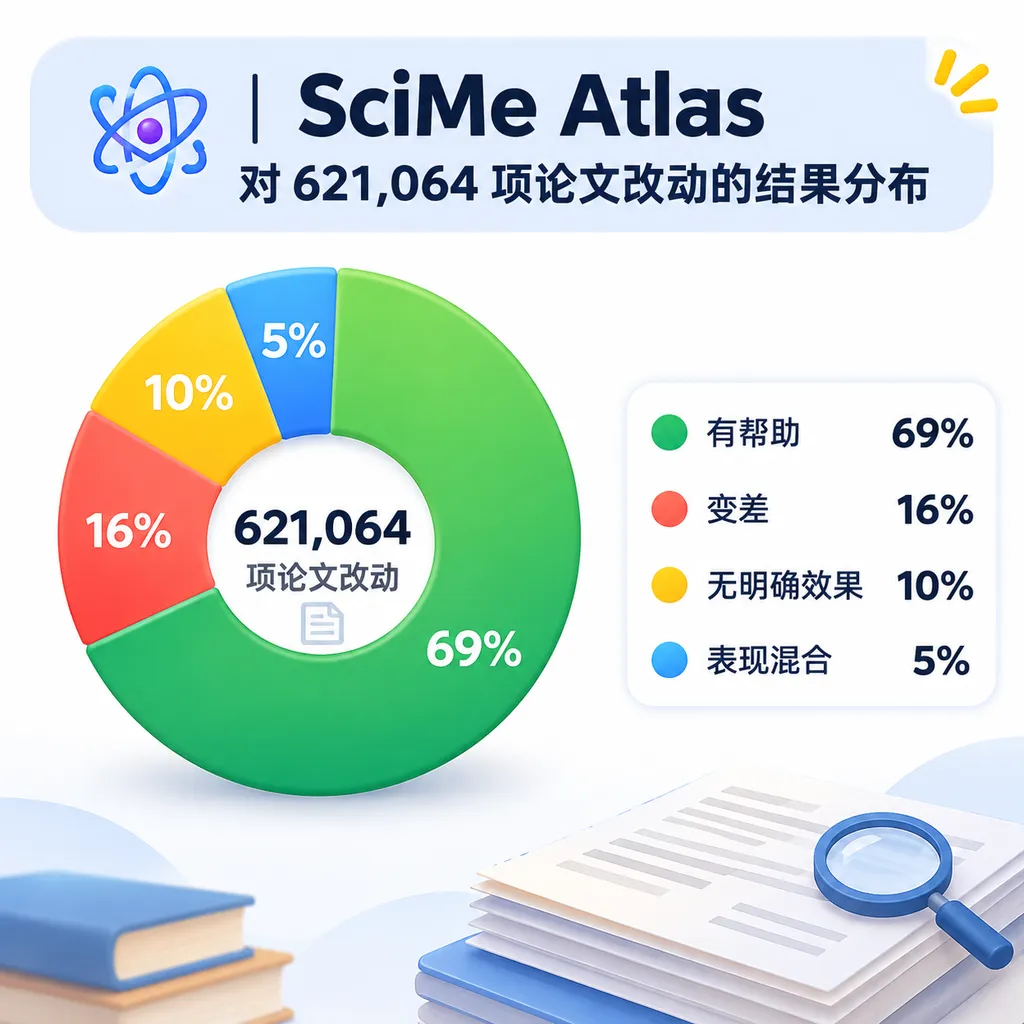
621,064 次改动里,约四分之一没有正收益
这批论文改动只有 69% 被归类为明确有帮助。 剩余改动中,10% 没有清晰效果,16% 导致结果下降,另有 5% 呈现混合结果,例如在一个数据集上提高、在另一个数据集上降低,或者准确率上升但延迟、显存和稳定性恶化。
按 621,064 项改动粗略折算,26% 的“无明确收益或负收益”对应约 161,477 项改动。这个数字不能被理解为 16 万个已经由独立团队证伪的科研结论,因为它没有进行外部复现;但它至少说明,即使使用原作者选择的数据集、训练设置和评价指标,也有大量尝试无法给出正向结果。
| 结果分类 | 占全部改动比例 | 对研发工作的含义 | |---|---:|---| | 明确有帮助 | 69% | 至少在论文报告的设置中产生正向变化 | | 无明确效果 | 10% | 变化接近噪声、缺乏统计显著性,或结论不一致 | | 表现变差 | 16% | 按作者报告的主要数字导致指标下降 | | 混合结果 | 5% | 收益依赖数据集、任务、指标或计算预算 | | 无明确收益或变差合计 | 26% | 不能仅凭“论文采用了该设计”推定它有效 |
66% 的论文至少报告了一项没有帮助的改动。 这个比例比“26% 的改动无效”更值得开发者留意,因为它意味着失败尝试并非集中在少数质量较差的论文中,而是广泛分布在主流研究工作里。一篇论文完全可能同时包含真正有效的核心创新、收益很小的配套模块,以及会拖累部分任务的超参数选择。
论文最终保留下来的完整方案也不等于每个组件都在贡献性能。 现实中的研究流程通常是先完成大量试验,再选择一个整体表现较好的组合写入主表;消融表则尝试拆解各组件贡献。组件之间存在交互时,单独加入 A 没用、单独加入 B 没用,却可能在 A 与 B 同时存在时有效,反过来也可能出现两个单独有效的模块组合后互相抵消。
更大 LoRA rank 和更高学习率,并不天然更好
参数规模或数值更大是一种搜索方向,不是一条可靠规律。 SciMe Atlas 公布的常见失败项显示,提高采样温度、增大 LoRA rank 和提高学习率,是最容易被“越大越好”直觉误导的几类操作。
| 常见改动 | 被归类为无帮助的比例 | 已披露样本信息 | 应如何理解 | |---|---:|---:|---| | 提高采样温度 | 52% | 122 篇论文 | 更多随机性可能增加多样性,也会损害准确性和可控性 | | 增大 LoRA rank | 46% | 原帖未披露完整分母 | 容量增加不等于有效信息增加,还可能提高过拟合与训练成本 | | 提高学习率 | 46% | 原帖未披露完整分母 | 更新更激进,但可能越过最优区域或造成训练不稳定 | | 增加对比学习损失 | 4% | 1,317 篇论文 | 在被统计的常见改动中,无帮助比例相对最低 |
采样温度是控制生成概率分布平滑程度的参数,温度越高,低概率 token 越容易被选中。 在创意写作、候选生成或自一致性推理中,提高温度可能扩大搜索空间;但在代码生成、结构化抽取和事实问答中,它也可能直接增加格式错误、幻觉和不可复现性。52% 的无帮助比例并不是说高温度永远错误,而是说明它必须与任务目标、采样次数和评测方法一起讨论。
LoRA rank 是低秩适配器中控制增量矩阵表达容量的秩参数。 更大的 rank 可以容纳更复杂的权重更新,但同时会增加可训练参数、显存占用和通信成本。如果数据量有限,或者任务与基座模型已有能力高度重合,rank 从 16 增至 64 可能只是给优化器增加更多自由度,而不是增加更多有效监督信号。
学习率是每一步参数更新幅度的核心超参数。 提高学习率有时可以加快收敛,也可能导致损失震荡、灾难性遗忘或最终泛化变差。尤其在大模型微调中,同一个学习率不能脱离 batch size、优化器、warmup、梯度裁剪、参数精度和训练步数单独比较。
对比学习损失是在表示空间中拉近正样本、推远负样本的训练目标。 统计显示,增加这类损失在 1,317 篇论文中只有 4% 被归为无帮助,是常见改动里表现较稳的一类。不过,这也不能直接推出“加对比损失就会涨点”,因为采用它的任务类型、基线强度和发表选择偏差都可能影响结果。
机器学习论文比视觉论文更常写出负结果
不同研究社区报告无效改动的习惯并不相同。 在这份数据里,机器学习会议和期刊有 31% 的改动被报告为无效果或负效果,计算机视觉场会对应比例为 22%,两者相差 9 个百分点。
| 论文领域 | 无效果或负效果占比 | 与视觉场会的差值 | |---|---:|---:| | 机器学习场会 | 31% | +9 个百分点 | | 计算机视觉场会 | 22% | 基准 |
31% 对 22% 的差距不能简单解释为机器学习研究“更不靠谱”。 更合理的解释至少有三种:机器学习论文可能测试了更广的优化与训练变量;视觉论文可能围绕成熟架构做更集中的组合;不同社区也可能有不同的篇幅限制、消融规范和负结果披露习惯。没有控制年份、任务类型和论文篇幅之前,这一数据只能说明报告结构存在差异,不能直接给研究质量排名。
负结果披露得更多,反而可能代表论文更诚实。 如果一个研究团队尝试了十种设计,只发表其中两种成功方案,读者看到的是接近 100% 的成功率;另一个团队把八项失败消融也写进附录,表面上的“无效比例”更高,却提供了更多可复用信息。因此,这张失败地图更适合用来寻找工程先验,不适合拿来给会议或作者贴标签。
26% 可能仍然低估了真实失败率
公开论文中的消融结果存在明显的发表偏差。 发表偏差是正向、显著和新颖结果更容易被写入论文并获得发表,而无效结果更容易被丢弃的现象。团队在项目推进中运行过的失败实验,通常远多于论文附录能够容纳的数量。
一项没有提高指标的尝试,可能在内部实验记录里就被终止,根本不会进入投稿版本。即使进入论文,作者也倾向于展示最能解释最终方案的几组消融,而不是完整公开数百次超参数搜索。因此,26% 更接近“作者愿意公开的改动中,没有收益的比例”,而不是实验室全部尝试的真实失败率。
这份统计也不能替代独立复现。 Atlas 使用的是论文作者报告的数字,而不是在统一代码、统一数据和统一算力下重新运行 62 万项实验。训练随机种子、数据清洗、基线调参力度、硬件差异和未公开技巧都可能影响结果,论文里的 0.2 个百分点提升也可能落在方差范围内。
自动抽取论文表格还可能引入分类误差。 不同论文对指标方向的定义并不一致:准确率越高越好,错误率和困惑度则越低越好;有些表格使用箭头标记,有些只在正文解释;有些消融同时改变多个变量。若没有逐项人工校验,模型或规则系统可能把相关性误当成单一改动的因果效果。
“混合结果”尤其不该被粗暴地当成成功或失败。 一个方法如果把准确率提高 0.5 个百分点,却让推理延迟增加 40%、显存增加 30%,对追求榜单的论文可能是成功,对线上服务则可能完全不可接受。反过来,准确率下降 0.1 个百分点但吞吐翻倍,也可能是很划算的工程改动。
对开发者最有用的,不是嘲笑论文,而是调整验证顺序
这组数据给开发团队的第一条建议是:把论文模块视为待验证假设,而不是标准答案。 “某顶会论文使用了它”只能说明该方案值得进入候选列表,不能省略本地基线、成本核算和任务内评测。
一个更可靠的复现顺序可以分成四层:
- 先复现基线。 如果基线指标、吞吐或损失曲线与论文差距明显,后续模块比较没有可信基础。
- 一次只改一个主要变量。 同时更换损失函数、数据配比和学习率,即使结果上涨也无法判断贡献来源。
- 至少运行多个随机种子。 当提升幅度接近训练方差时,单次最好结果没有决策价值。
- 同时记录质量与成本。 除主指标外,还应记录训练时长、峰值显存、推理延迟、吞吐量和输出 token 消耗。
第二条建议是优先验证失败率高、成本又高的改动。 增大 LoRA rank、提高学习率或扩大采样温度都很容易操作,但正因为操作简单,团队更容易跳过严谨评估。对于 rank 翻倍这类方案,应先比较同等训练步数和同等数据下的收益,再计算每增加 1 GB 显存或每增加 1 小时训练带来的指标变化。
第三条建议是把消融表从论文附件变成研发账本。 一张有效的内部消融表至少应包含改动描述、基线版本、数据版本、随机种子、主要指标、置信区间、训练成本、推理成本和最终决策。没有这些字段,三个月后团队往往只记得“好像试过”,却不知道失败来自方法本身还是实现问题。
第四条建议是为负结果设置可检索标签。 失败实验如果只留在聊天记录和临时日志里,下一位工程师很可能再次支付相同的 GPU 成本。按模型版本、数据集、超参数、任务和失败类型建立索引,比继续收集“最新论文列表”更能形成团队壁垒。
这项统计真正揭示的是 AI 研发的基本面
AI 研究不是一条由论文标题串起来的单向进步曲线。 论文天然会突出创新与正向结果,但真实研发更像高维搜索:大部分方向没有明显收益,一部分方向只在特定条件下有效,少数方向才能稳定迁移到不同模型和任务。
26% 不是一个用来证明“论文没用”的数字。 相反,论文愿意报告无效或负向消融,能够帮助后来者缩小搜索空间。真正的问题是,行业长期更愿意传播“提升了多少”,却很少结构化记录“在哪些条件下没有提升”。
SciMe Atlas 的价值在于把分散的消融实验变成可查询的工程经验。 如果后续公开抽取方法、误差评估、年份分布和各类改动的完整样本量,这类数据库有机会成为模型研发的“失败先验”:在烧掉一轮 GPU 预算之前,先看看相似改动过去到底有多大概率奏效。
对开发者来说,最现实的结论只有一句:论文提供的是候选方案,不是免检方案。下一次看到“只改 100 行代码就提升 3%”时,先确认基线是否公平、提升是否超过方差、成本是否同步增加,以及这项改动在作者自己的其他数据集上有没有失败。
参考来源
- Reddit:We logged 621k changes from 127k papers' ablations:Latentic Labs 团队披露 SciMe Atlas 的覆盖范围、结果分类、场会差异及常见无效改动统计,并说明项目由其团队建设。