商汤用9B参数挑战27B模型
商汤正式发布 SenseNova Loop-9B,以参数共享换取 56 层计算深度,最高支持 512K 上下文。官方 AWQ 4bit 权重约 4.9GB,基础部署显存低于 10GB,但速度与真实能力仍待社区验证。
9B 参数不变,模型把中间层跑了两遍
商汤科技在 11 月 17 日晚间正式发布并开放 SenseNova Loop-9B,这是一个通过循环复用模型层参数、用更多计算深度换取更高参数效率的 90 亿参数多模态模型。它支持文本和图像输入、文本输出,最长上下文从 Preview 版本的 256K 扩展至 512K tokens,并在发布首日同步提供官方 AWQ 4bit 量化版本。
SenseNova Loop-9B 的重点不是又做了一个能塞进消费级显卡的 9B 模型,而是尝试回答一个更有价值的问题:模型能力能否不再随着存储参数量近似线性增长。商汤给出的办法,是让一部分参数在同一次前向传播中被重复使用,相当于让模型用同一组神经网络层“多想一遍”。
官方数据显示,SenseNova Loop-9B 的 4bit 量化权重约为 4.9GB,常规部署显存需求可以控制在 10GB 以内。作为参照,一个 27B 模型仅按每个参数 4bit 计算,理论权重体积就约为 13.5GB,尚未计入量化元数据、运行时缓冲区、激活值和 KV 缓存;9B 模型的理论 4bit 权重体积则约为 4.5GB,与商汤公布的 4.9GB 成品基本吻合。
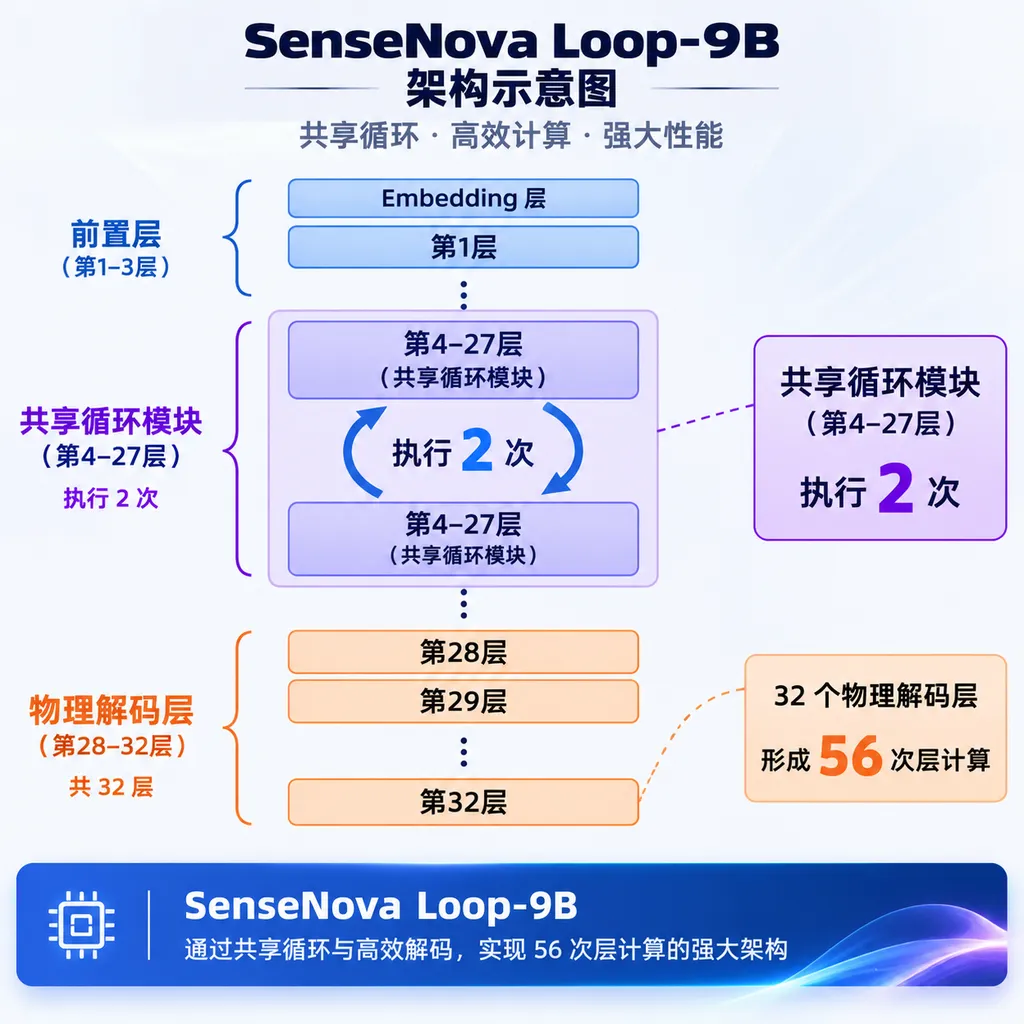
Loop 架构是什么:存一份参数,做两遍计算
Looped Transformer 是一种重复执行共享网络层、以计算次数换取参数效率的 Transformer 变体。传统稠密模型通常让输入依次经过不同权重的解码器层,而 Loop 模型会让部分层共享权重并重复执行,因此不会按计算深度同比增加参数量。
SenseNova Loop-9B 共有 32 个物理解码器层,其中第 4 至第 27 层组成一个包含 24 层的共享循环模块。首尾 8 层各执行一次,中间 24 层执行两次,因此一次前向传播实际完成的层计算次数为:
- 首尾非循环层:8 次;
- 中间循环模块:24 × 2 = 48 次;
- 总计算深度:8 + 48 = 56 次。
这套设计可以简单理解为“32 层权重、56 层工作量”。模型磁盘体积和权重显存主要由 9B 参数决定,但推理时的计算量并不会像普通 9B 模型那样轻,因为共享的中间层仍然需要实打实地运行第二遍。
参数量与计算量因此必须分开看。SenseNova Loop-9B 确实只需要保存约 9B 参数,但“9B 参数”不等于“普通 9B 模型的速度”;它更接近一个用较小权重存储空间承担更深计算流程的模型,其优势首先体现在显存占用和分发成本,而不必然体现在首 token 延迟或每秒生成速度。
| 项目 | SenseNova Loop-9B | 常规 9B 稠密模型 | 常规 27B 稠密模型 | |---|---:|---:|---:| | 参数规模 | 约 9B | 约 9B | 约 27B | | 物理解码器层 | 32 层 | 因模型而异 | 因模型而异 | | 实际层计算 | 56 次 | 通常不重复 | 通常不重复 | | 4bit 理论权重体积 | 约 4.5GB | 约 4.5GB | 约 13.5GB | | 官方量化权重体积 | 约 4.9GB | — | — | | 主要取舍 | 小权重、较深计算 | 权重与计算相对均衡 | 更高显存和存储需求 |
mHC 解决的是“多跑一遍以后,信息怎么不跑乱”
mHC 是 Manifold-Constrained Hyper-Connections 的缩写,即流形约束超连接,它通过受约束的可学习映射组织多路残差信息。Loop 模块会让同一组权重多次处理信息,如果只是机械地重复执行,模型容易出现特征混合不足、信号传播不稳定或不同迭代轮次趋同等问题。
SenseNova Loop-9B 使用双流 mHC 在循环模块中维护两条残差流,并学习如何对两路信息进行路由和融合。它类似于给重复经过同一组处理工位的数据增加两条传送带:工位没有增加,但模型可以决定哪些信息继续保留、哪些信息交叉混合,以及下一轮计算更应该关注哪一部分。
Preview 阶段的消融实验已经显示,mHC 并非只为架构命名增加新缩写。商汤此前公布的结果称,引入 mHC 后,GPQA Diamond 提高 4.42 分,TeamBench 提高 13.34 分;前者侧重高难度科学推理,后者更接近多步骤 Agent 协作任务,这说明更稳定的信息传递可能是循环架构能否处理复杂任务的关键变量。
不过,消融实验只能说明 mHC 相对于同一模型的简化版本有效,不能直接证明 Loop-9B 已经全面达到 27B 模型水平。跨模型比较还会受到训练数据、后训练方法、工具环境、提示词模板和评测采样参数影响,社区复现仍然比单一榜单数字更重要。
三层线性注意力配一层全注意力,目标是把长上下文成本压下来
混合注意力是在线性注意力与全注意力之间交替安排计算的架构方案。SenseNova Loop-9B 以四层为一组,采用三层线性注意力加一层全注意力的配置,试图同时保留长序列效率与关键位置之间的精确交互能力。
全注意力可以直接建模任意 token 之间的关系,但标准实现的注意力计算量会随序列长度呈平方增长。线性注意力通过状态压缩或核化计算降低长序列成本,却可能损失一部分精确检索能力;商汤的 3:1 混合配置,本质上是让多数层负责便宜地传递长程信息,再定期用全注意力层进行更完整的全局校正。
SenseNova Loop-9B 的最大上下文长度达到 512K tokens,但“支持 512K”不代表任何 10GB 显卡都能直接装下 512K 上下文。模型权重只是显存账单的一部分,随着上下文增长,KV 缓存、激活值和运行时工作区会继续占用显存。
官方给出的更具参考价值的数据是:使用 4bit 权重量化和 8bit KV 缓存时,256K 长上下文推理约需 15GiB 显存。这个数字意味着两个不同的部署档位:10GB 以内主要描述量化模型在较短或常规上下文下的基础部署门槛,15GiB 则对应 256K 长上下文场景;如果实际使用 512K,上下文缓存与运行框架带来的额外开销仍需单独评估。
| 部署场景 | 权重量化 | KV 缓存 | 上下文长度 | 官方显存数据 | |---|---|---|---:|---:| | 基础本地部署 | AWQ 4bit | 视框架配置 | 常规上下文 | 低于 10GB | | 长上下文部署 | 4bit | 8bit | 256K tokens | 约 15GiB | | 最大上下文能力 | 未限定 | 未限定 | 512K tokens | 官方未公布统一显存值 |
这组数据让 Loop-9B 更适合 12GB、16GB 显存设备和小型私有化服务器,而不是只有 8GB 显存的老显卡。4.9GB 权重文件虽然能放进 8GB 显存,但模型运行还要给 KV 缓存和框架工作区留空间,能加载权重与能稳定完成真实任务并不是一回事。
官方跑分接近27B,但“27B级能力”需要限定场景
SenseNova Loop-9B 在 Agent、代码与数据分析任务上展示了接近 Qwen3.8-27B 的官方评测结果。商汤公布的两项直接对比中,Loop-9B 在 NL2Repo 获得 41.36 分,比 Qwen3.8-27B 的 44.60 分低 3.24 分;在 AIDABench 获得 65.31 分,比后者的 65.01 分高 0.30 分。
| 评测项目 | SenseNova Loop-9B | Qwen3.8-27B | 分差 | 结果判断 | |---|---:|---:|---:|---| | NL2Repo | 41.36 | 44.60 | -3.24 | Loop-9B 接近但仍落后 | | AIDABench | 65.31 | 65.01 | +0.30 | Loop-9B 略高 |
NL2Repo 是面向自然语言到代码仓库级任务的评测,考查的不只是补全一段函数,还包括理解项目结构、跨文件定位和执行修改。AIDABench 则聚焦 AI 数据分析能力,通常更强调数据理解、分析过程与结果生成;这两类任务都比普通问答更容易体现模型的多步骤推理和工具使用能力。
“9B 冲击 27B”目前最准确的含义,是 Loop-9B 在部分 Agent 和数据分析基准上进入了 27B 模型的竞争区间。它并不意味着模型在知识覆盖、数学、代码生成、视觉理解、长文本召回、多语言和实际 Agent 成功率上都等价于 27B,更不能从两项官方数据外推为全面替代。
这也是看待官方跑分时最需要保持的克制。AIDABench 的 0.30 分领先幅度很小,可能落在不同提示词、采样设置或工具执行波动范围内;NL2Repo 的 3.24 分差距则仍然清晰存在,说明 Loop-9B 的参数效率值得肯定,但当前还没有形成对更大模型的稳定全面优势。
10GB 显存是它最现实的卖点,循环架构才是长期看点
SenseNova Loop-9B 对开发者最直接的价值,是把较强的代码、Agent 和多模态能力压缩进 10GB 左右的基础部署预算。对于无法把业务数据送上公有云的团队,这意味着一张 12GB 或 16GB 显卡就有机会承载文档分析、代码仓库辅助、内部数据问答和轻量视觉 Agent,而不必先搭建多卡推理环境。
官方 Day 0 提供 AWQ 4bit 版本也降低了试用成本。AWQ 是一种面向大语言模型的权重量化方法,它通过保护对输出更重要的权重通道,在压缩至 4bit 的同时尽量减少能力损失;相比只发布 BF16 原始权重、让社区自行制作量化文件,官方量化版本通常更容易复现官方部署配置。
Loop 架构的长期意义则高于这次具体跑分。大模型过去常以增加参数规模换能力,但端侧、私有化和边缘部署更在意“需要存多少权重”;如果共享参数可以通过重复计算逼近更大模型,厂商就能在显存与计算时间之间提供新的交换方式。
循环复用的代价同样不能被 4.9GB 权重文件掩盖。中间 24 层需要执行两遍,意味着模型即使节省了权重读取和显存,也未必能达到普通 9B 模型的生成吞吐;在并发在线服务中,更多串行层计算还可能拉高单请求延迟,最终的每秒 token 数、首 token 延迟和单位请求能耗需要在不同推理框架上实测。
正式版比 Preview 更完整,但社区还要补三类测试
SenseNova Loop-9B 正式版补齐了 Preview 阶段最明显的产品缺口,包括将最大上下文扩展至 512K、继续提升 Agent 与数据分析能力,以及首日提供官方 AWQ 4bit 权重。相比 10 月底发布的 Preview,这次版本更接近可以进入真实项目验证的模型,而不只是架构概念展示。
社区接下来最值得验证的是速度、长上下文和泛化能力三件事:
- 速度测试:在相同 GPU、相同量化精度和相同上下文下,对比普通 9B、Loop-9B 与 27B 模型的首 token 延迟和生成吞吐。
- 长上下文测试:分别验证 32K、128K、256K 和 512K 下的有效召回率,而不是只确认推理框架能够成功分配显存。
- 任务泛化测试:除官方强调的 Agent 与数据分析外,还应覆盖数学、通用代码、中文写作、视觉问答、事实准确率和工具调用稳定性。
开发者还应在部署前核对模型卡中的许可证、支持的推理框架、聊天模板和图像预处理方式。SenseNova Loop-9B 已开放模型权重与相关代码,但“开放下载”并不自动等于可以无条件用于所有商业场景,具体用途应以正式仓库中的许可证文本为准。
判断:不是免费的27B,而是一笔新的算力交易
SenseNova Loop-9B 不是把 27B 模型免费压缩成了 9B,而是用重复计算换取了更低的参数存储与显存门槛。它减少的是必须常驻设备的权重规模,付出的则是更深的计算路径,以及可能更高的延迟和能耗。
这笔交易对本地部署依然有吸引力。显存通常是开发者能否启动模型的第一道硬门槛,而推理速度还能通过量化、算子优化、投机解码和更强计算设备继续改善;一个跑得稍慢但能装进单卡的模型,在很多私有化场景中比根本装不下的 27B 更有用。
商汤这次真正值得关注的成果因此不是“AIDABench 高了 0.30 分”,而是把 Looped Transformer、双流 mHC、混合注意力和官方 4bit 量化组合成了一个可下载、可部署的 9B 模型。至于它能否成为真正的 27B 替代品,答案不会来自发布会上的两张榜单,而要看社区在同一硬件、同一任务和同一推理预算下的复现结果。
参考来源
- IT之家:商汤发布 SenseNova Loop-9B,部署显存需求低至 10GB 内——包含正式版发布时间、架构、上下文、量化体积与官方评测数据。
- Hugging Face:SenseNova Loop-9B 模型检索页——用于查找官方模型卡、权重文件、许可证及后续更新,下载前应核对发布组织信息。