AI编程最贵的不是成功,是失败
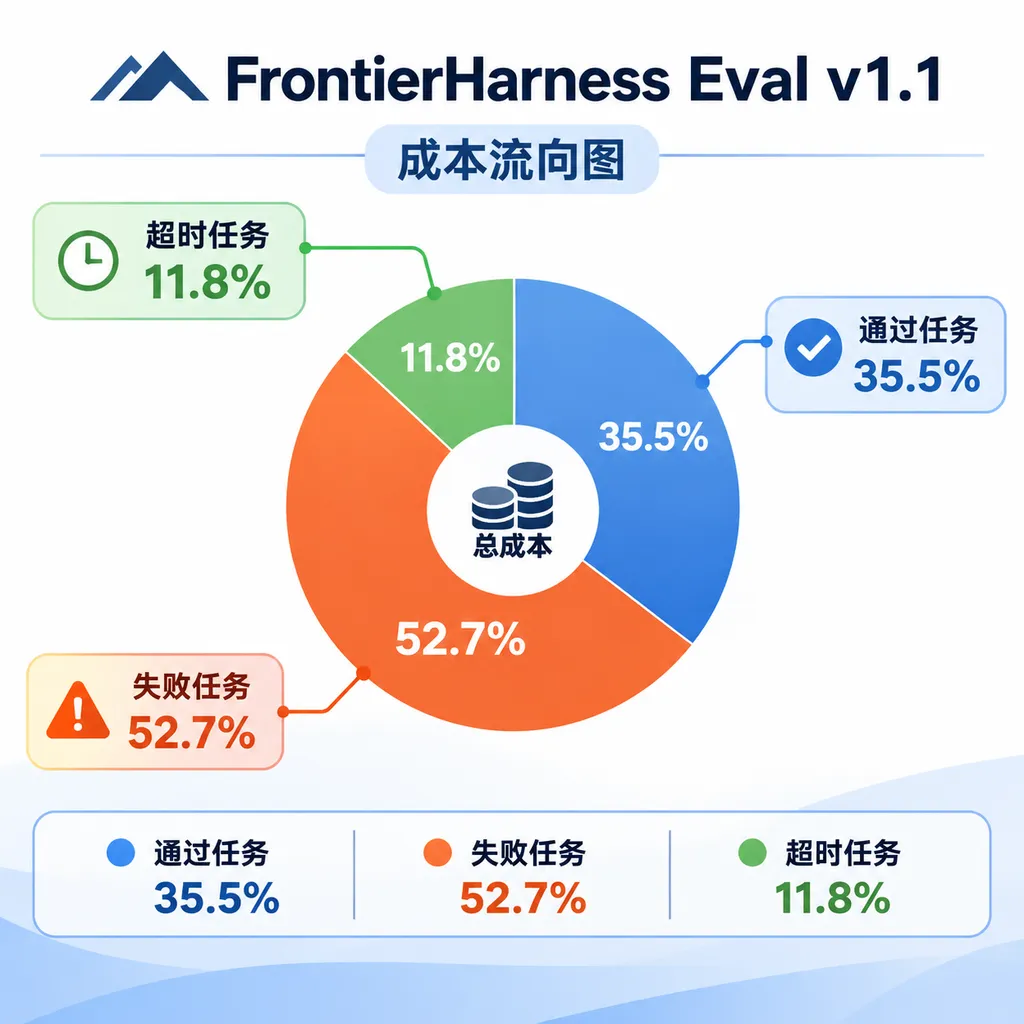
FrontierHarness Eval v1.1复盘27280次编程Agent运行:64.5%的推理成本流向失败或超时任务。真正决定账单的,不只是模型价格,而是Agent是否会及时验证、止损和退出。
AI编程最贵的不是成功,是失败
11月17日公布的一组大规模评测数据,揭开了编程Agent账单里最难看的部分:在27280次运行中,64.5%的推理成本花在了没有通过验证的任务上。
这不是几十个Demo的抽样,而是一场消耗约830亿Token的完整矩阵实验。FrontierHarness Eval v1.1测试了22种Agent配置、5个开放权重模型和62个终端任务,每个组合重复4次,规模达到上一版的76倍。结果显示,52.7%的成本流向明确失败的运行,另有11.8%消耗在超时任务上。换句话说,每花100元推理费用,大约64.5元没有换来一个通过验证的结果。(runta.com)
编程Agent是能够读取代码、调用终端工具、修改文件并根据测试结果持续迭代的软件开发智能体。 它与普通代码补全最大的区别,是会形成一个包含“观察、思考、操作、再观察”的循环,因此一次任务可能触发数十甚至数百轮模型请求。
真正值得开发者警惕的,不是Agent会失败,而是它经常在已经偏离正确路径之后继续昂贵地失败。
27280次运行,测的不是谁最聪明
FrontierHarness Eval是一个比较“模型与Agent框架组合效率”的评测,而不只是测试基础模型的代码能力。
Agent Harness是包裹在模型外部、负责提示词、工具调用、上下文管理、文件编辑、测试执行和退出策略的运行框架。 同一个模型放进不同Harness,就像同一名工程师被安排进不同的开发流程:有人先读需求再测试,有人上来就改文件,还有人会在错误方向上连续工作几十轮。
本次评测使用了GLM-5.3、GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017、Muse Spark Open和Kimi-K3五个模型,任务限时从15分钟到8小时不等。每次运行都在新的隔离环境中开始,避免前一次任务残留的文件或状态影响结果;同时,评测对216条疑似利用外部答案或规避任务要求的轨迹进行了审计,其中163条涉及在线查找答案,并将这些运行记为0分。(runta.com)
| 指标 | 结果 | 对开发者意味着什么 | |---|---:|---| | Agent运行次数 | 27280次 | 已能观察到框架、模型和任务之间的系统性差异 | | 推理Token | 约830亿 | Agent评测已进入需要计算成本工程的规模 | | Harness配置 | 22种 | 外层执行框架不是可忽略的包装 | | 模型数量 | 5个 | 同一Harness无法保证在不同模型上都高效 | | 终端任务 | 62个 | 覆盖的不是单一代码补全,而是可执行工程任务 | | 未通过运行成本占比 | 64.5% | 成本控制的重点应从“成功有多便宜”转向“失败能否尽早停止” | | 明确失败成本占比 | 52.7% | 大量预算花在最终未通过验证的修改上 | | 超时成本占比 | 11.8% | 循环、等待和无效重试仍是主要成本漏洞 |
这组数据最重要的价值,是把行业常见的“通过率排行榜”改写成了“完成一个有效结果到底要付多少钱”。
传统评测只记录成功或失败,类似只看出租车是否到达目的地,却不统计它绕了多少公里、等了多少红灯。对Agent产品来说,这种评测远远不够,因为两个框架即使通过率接近,也可能在步骤数、上下文长度和失败成本上相差数倍。
64.5%不等于模型能力差
64.5%的失败成本不能简单理解成“模型浪费了三分之二算力”,因为部分失败探索确实是复杂任务的必要成本。
软件工程天然需要试错。Agent可能先定位错误文件,提出一个假设,修改代码,运行测试,再根据报错修正方案。一次失败的测试并不一定浪费,它可能帮助模型排除错误路径。问题在于,当前Harness往往无法区分“有信息增益的失败”和“原地打转的失败”。
评测显示,成本与步骤数的相关性明显高于初始提示词长度、工具数量和缓存命中率。22种Harness中,每次成功所需步骤数与每次成功成本的秩相关系数为+0.51,而另外三项因素的相关性仅在-0.03到+0.02之间。平均每次运行会发送200万至480万输入Token,而最大的第一次请求只有21365 Token,占总输入量不到1%。(runta.com)
Agent步骤是轨迹中一次模型决策、工具调用或环境反馈形成的执行节点。 每增加一步,系统通常都需要重新发送大部分已有上下文,因此后期的一次错误决策,成本可能远高于任务刚开始时的一次错误决策。
这意味着,开发者把系统提示词从10000 Token压缩到5000 Token,可能只省下账单的零头;如果Agent仍然要循环80轮,省下来的提示词很快就会被重复上下文吞掉。
一个典型反例是mini-SWE-agent。它的首次请求只有882 Token,是参评框架中最小的,但平均每次成功需要38个步骤,最终成本排名只排到22种配置中的第17位。简单框架不自动等于便宜框架,短提示词也不自动等于高效率。(runta.com)
更贵,并没有买来更高通过率
更高推理成本没有稳定换来更高通过率,这是本次评测最反直觉的结果之一。
在五个模型上,Harness的单任务成本与通过率之间的秩相关系数只有-0.39到+0.22。每个模型通过率最高的Harness,在成本排名中仅位列第5至第20;其中四个模型上,单次通过最贵的Harness,实际通过率反而低于最便宜的Harness。(runta.com)
| 常见判断 | 评测结果 | 更准确的结论 | |---|---|---| | 多思考几轮通常更容易成功 | 步骤越多,成本越高,但通过率没有同步上升 | 额外步骤只有在产生新证据时才有价值 | | 工具越多,Agent能力越强 | 工具数量与每次通过成本几乎无相关性 | 工具选择稳定性比工具数量更重要 | | 系统提示词越短越省钱 | 首轮输入通常不到总输入的1% | 应优先减少无效循环和重复读取 | | 缓存命中率高就一定便宜 | 大多数Harness缓存命中率都很高,成本仍有明显差异 | 缓存只能降低单步价格,不能阻止步骤膨胀 | | 选择最强模型即可 | 同一Harness换模型后,成本排名可能大幅变化 | 模型和Harness必须作为组合评测 |
缓存尤其容易制造一种虚假的安全感。
本次评测中,缓存输入承担了42%的推理成本,输出Token占33%,其他输入占25%。缓存输入价格只有普通输入的2%至20%,确实很便宜,但一次缓存命中率很高的300步失败,仍然可能比一次20步完成的低缓存任务更贵。(runta.com)
所以,缓存优化更像给一辆绕路的汽车换上便宜燃料:每公里便宜了,但它依然在绕路。
同一个Harness,换模型可能从第一掉到第十六
Agent框架不存在脱离模型的固定排名,这是这次评测对“最佳编程Agent”讨论最直接的修正。
Codex CLI在GLM-5.3上的单任务成本排名第一,但换成Kimi-K3后跌到第16;DeepSeek Harness Creator在Muse上排名第一,在GLM-5.3-Flash上却跌至第21;OpenCode v1在DeepSeek模型上最便宜,在Muse上只排第13。不同模型之间的成本排名平均相关系数只有0.26,而同一模型不同重复运行之间可以达到0.71。(runta.com)
模型—Harness适配是模型行为特征与Agent执行策略之间的匹配程度。 它包括模型对工具描述的理解方式、输出格式稳定性、上下文缓存机制、代码编辑偏好、错误恢复能力和终止判断方式。
一种Harness可能为某个模型设计了非常合适的工具说明和上下文结构,换一个模型后,这些设计反而会诱发更多试探、重复读文件或无效调用。评测的方差分析显示,模型本身解释了92.8%的总体成本差异,但在模型固定之后,Harness之间剩余差异的68%来自特定模型与Harness组合,或包含在组合噪声中。(runta.com)
这给开发团队一个很现实的提醒:模型升级不能只跑一次准确率回归测试,还必须重新测试步骤数、单任务成本、超时率和失败成本。
如果团队从模型A迁移到模型B,却沿用原来的Agent框架、提示词和退出策略,最终结果可能不是更便宜,而是模型单价降低30%,平均步骤数却增加一倍。
失败任务为什么停不下来
大量失败任务不是被超时强制终止,而是Agent主动提交了一个自信但错误的答案。
在五个性价比最高的Harness中,68%至82%的失败运行以正常最终回答结束,而不是触发时间上限。也就是说,Agent并不知道自己没有完成任务,甚至会给出“已经验证”“测试通过”之类的总结,但外部验证器仍然判定失败。(runta.com)
这暴露了编程Agent当前最薄弱的一环:生成代码已经很强,判断代码是否真的正确却没有同步跟上。
TestPrism的研究从另一个角度印证了这个问题。该测试集包含来自17个来源的300个测试任务和3000个候选实现,要求Agent生成的测试既能在原始错误代码上失败,又要接受所有正确实现、拒绝所有错误实现。14种Coding Agent配置中,最强配置在单一参考答案上的成功率达到59.67%,但更严格的联合成功指标只有28.00%。(arxiv.org)
联合成功函数是同时检查测试能否发现原始缺陷、接受全部正确实现并拒绝全部错误实现的评估指标。 它比“能否让一个参考实现通过”更接近真实软件工程,因为同一需求通常存在多种合法实现。
两组结果指向同一个结论:Agent不是单纯缺少写代码的能力,而是缺少可靠的自我验收能力。
如果测试用例本身有漏洞,Agent就可能通过修改代码去迎合一组错误测试;如果终止判断只依赖模型自己的总结,它又可能在关键边界条件尚未验证时宣布完成。此时增加推理预算,往往只是让错误方案获得更多润色,而不是让它变正确。
开发者该如何减少失败账单
降低编程Agent成本的第一原则,是为失败建立明确的止损机制,而不是简单压低模型单价。
1. 同时记录成功成本和失败成本
团队不应只统计平均Token或单次调用价格,而应至少拆分四个指标:每次通过成本、每次失败成本、超时成本占比和失败前平均步骤数。
| 建议指标 | 定义 | 用途 | |---|---|---| | Cost per Pass | 总推理成本除以通过任务数 | 衡量获得一个可用结果的真实价格 | | Failure Spend Ratio | 失败与超时成本除以总成本 | 判断预算是否被无效任务吞噬 | | Steps to First Valid Test | 从启动到首次通过关键测试的步骤数 | 识别定位和修改阶段是否过长 | | Repeated Error Ratio | 相同错误连续出现的次数占比 | 发现Agent是否陷入循环 | | False Completion Rate | Agent宣布完成但验证器失败的比例 | 衡量自我验收是否可信 | | Timeout Recovery Rate | 接近超时后成功收敛的任务比例 | 判断延长预算是否真正有效 |
2. 对重复错误设置硬退出条件
Agent连续两到三次遇到相同测试失败、重复读取同一文件或生成高度相似的补丁时,系统应暂停自动循环,要求它重新规划或把任务升级给人工。
继续运行不是免费的耐心,而是一种高成本决策。尤其在上下文已经膨胀到数十万Token后,后续每一步都会携带大量历史信息,错误循环会产生复利式账单。
3. 把独立验证放在最终回答之前
Agent在提交结果前,应强制执行与自身修改逻辑相对独立的验证流程,例如完整回归测试、静态分析、类型检查、性能测试和关键行为断言。
验证器不能只问模型“你是否完成了”,而应检查可执行证据。对数据库、并发、权限、序列化和性能相关任务,单元测试通过也不足以代表任务完成,还需要加入领域约束和非功能指标。
4. 给简单任务和复杂任务设置不同预算
固定的最大步骤数容易出现两种浪费:简单任务被允许绕路几十轮,复杂任务又在即将收敛时被突然截断。
更合理的方法是根据仓库规模、涉及文件数、测试耗时和历史成功率动态分配预算。对于低复杂度任务,可以设置较短的首次验证窗口;对于长任务,则按阶段释放预算,只有完成定位、形成可验证假设或减少失败测试数量后,才允许进入下一阶段。
5. 换模型时重新评测Harness
模型迁移测试至少应覆盖20至50个内部真实任务,而不是只比较公开Benchmark得分。
开发团队需要记录每个模型与Harness组合的通过率、成本、步骤数、平均耗时和失败类型。FrontierHarness的结果已经说明,同一框架在不同模型上的成本排名可能相差15至20位,沿用旧配置并不稳妥。(runta.com)
6. 优先减少步骤,而不是继续裁剪提示词
提示词当然需要简洁,但它不是当前Agent成本的主要矛盾。
更值得优化的是文件定位是否准确、是否重复运行无关测试、补丁失败后是否真正改变策略,以及每次工具调用是否产生新信息。一个能够在20步内承认失败的Agent,通常比一个缓存命中率95%、但循环100步的Agent更适合生产环境。
编程Agent需要一套“失败工程”
本次评测最有价值的结论,不是哪一个Agent框架排第一,而是行业需要开始系统设计失败路径。
过去一年,编程Agent产品主要在优化成功体验:更大的上下文、更丰富的工具、更长的自主运行时间和更多子Agent。FrontierHarness Eval v1.1表明,这些能力如果缺少验证和退出机制,可能会把Agent从“偶尔犯错的助手”变成“能够长时间、自动化、昂贵地犯错的系统”。
当前排名也不应被当成永久结论。五个模型的推理价格相差20倍以上,部分最佳组合的统计优势并不牢固。例如,重采样4000次后,Codex CLI与GLM-5.3组合有99.6%的概率保持最佳性价比,但其他四个模型上的最佳组合胜出概率仅为25%至53%,小幅差距很可能只是并列。(runta.com)
真正可复用的结论只有三个:模型和Harness必须成对评测,步骤数比初始提示词长度更能解释成本,失败任务必须具备独立验证和主动止损能力。
64.5%的失败成本也不意味着企业应该停止使用编程Agent。它意味着团队不能再用“买了多少Token”衡量投入,而要用“获得了多少经过验证的工程结果”计算产出。
下一阶段的竞争不会只是哪个模型更会写代码,而是谁能让Agent更早发现自己写错了。
参考来源
- FrontierHarness Eval公开评测仓库:包含评测方法、任务定义和可复现脚本,是理解Harness评测流程的主要技术资料。
- Harbor Agent评测框架:用于在隔离环境中运行和评估不同Agent及模型组合的开源框架。
- FrontierHarness v1.1社区讨论:评测启动阶段关于运行规模、模型选择和重复次数的开发者讨论。
- 100个失败Agent项目复盘:从项目落地角度总结评估黑盒、工具设计和成本失控问题。
- AI编程失败案例剖析:讨论AI生成代码在复杂项目中的验证、性能和工程决策缺陷。