微软代码模型双线出击
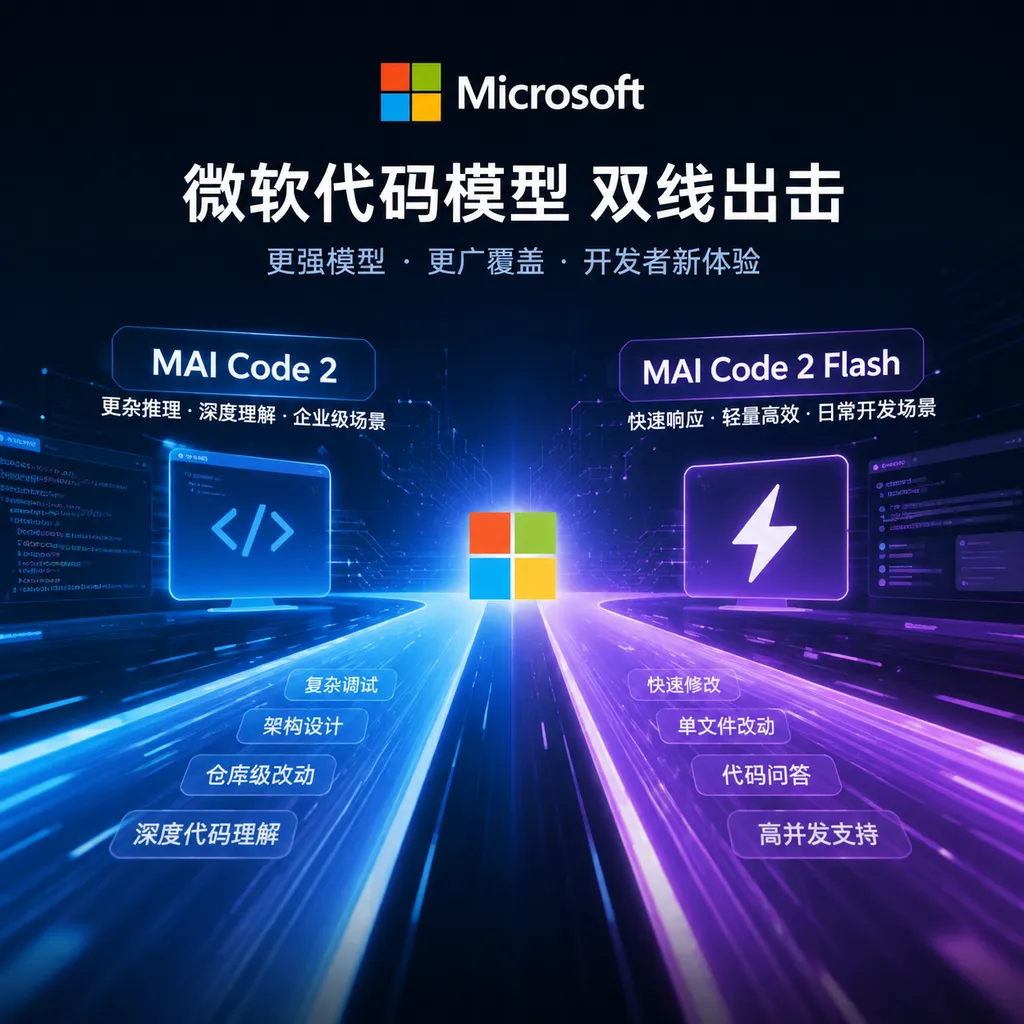
微软发布 MAI Code 2 与 Code 2 Flash,以高性能模型处理复杂工程任务,以低延迟模型承接高频开发需求,正式补齐自研代码模型的产品梯队。
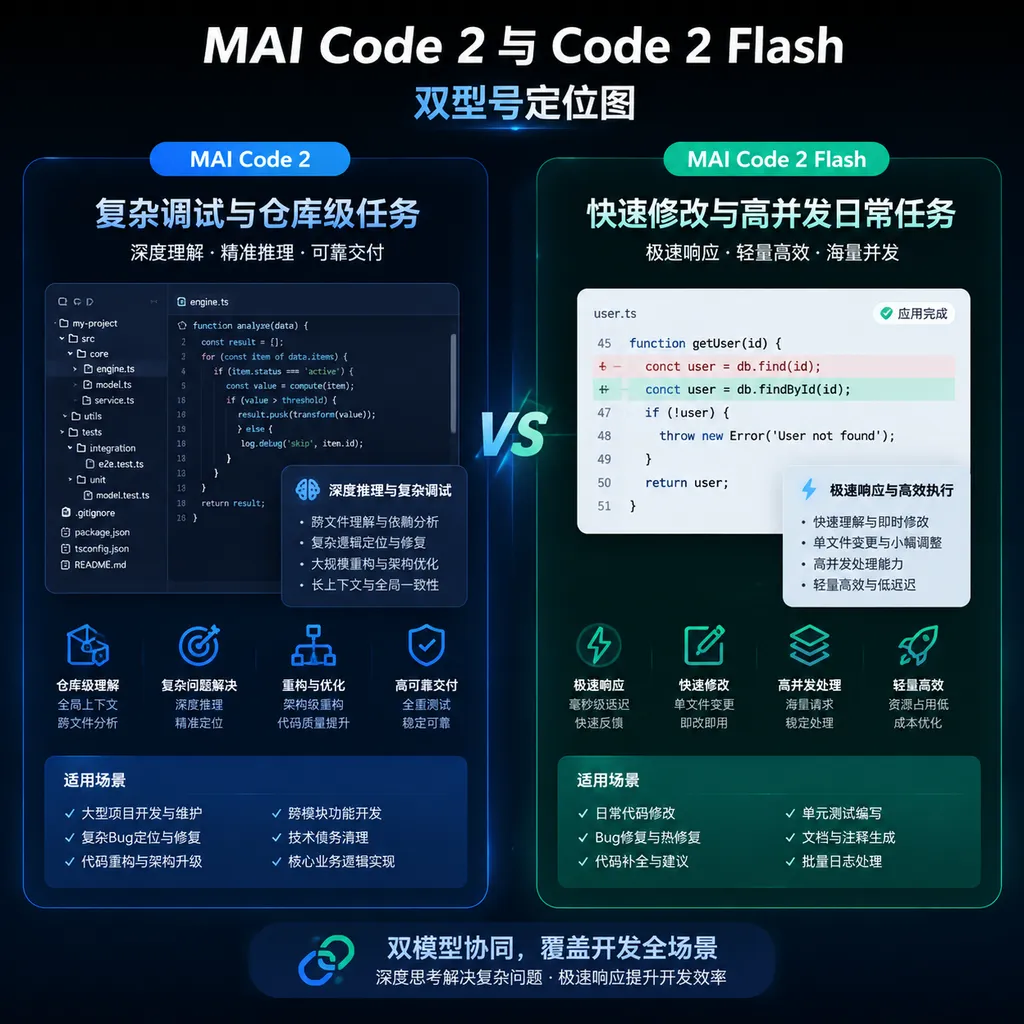
微软在 11 月 17 日发布 MAI Code 2 与 MAI Code 2 Flash,并于当天将两款模型接入 GitHub Copilot。与此前主要强调速度和成本的 MAI-Code-1.1-Flash 不同,新一代产品第一次形成了清晰的双型号布局:MAI Code 2 负责复杂调试、多文件实现和仓库级推理,Code 2 Flash 则负责代码解释、定向修改、常规修复和快速迭代。(microsoft.ai)
**MAI Code 2 是微软面向复杂软件工程任务打造的高性能自研代码模型。**它不是简单的代码补全工具,而是针对 Agentic Coding,也就是能够读取仓库、调用终端、修改多个文件、运行测试并根据结果继续修正的智能体式开发流程进行训练。
**MAI Code 2 Flash 是微软面向高并发、低延迟和低成本任务设计的轻量代码模型。**它与 Code 2 共享模型家族、训练方法和工具使用能力,但规模更小,适合企业每天大量发生、单次难度相对有限的开发请求。
这次不是一次普通的 Flash 升级
**微软此次真正补上的,是 MAI 代码模型在高性能档位的空缺。**今年 6 月发布的 MAI-Code-1-Flash,以及 8 月推出的 1.1-Flash,都把重点放在“更小、更快、更便宜”上;它们适合代码解释、补全、CLI 操作和局部修改,却很难被视为 Claude Opus、GPT 高性能代码模型的直接替代品。
**MAI Code 2 改变了微软自研模型只能承担轻量任务的印象。**微软给它划定的场景包括深度调试、多文件功能实现、大规模重构、仓库级推理、测试驱动验证,以及从截图和原型图生成前端界面。这意味着它面对的不再是“帮我写一个函数”,而是“进入一个陌生仓库,找到问题、修改代码、跑完测试并交付可合并结果”。(microsoft.ai)
**Code 2 Flash 则不是 Code 2 的廉价残次版,而是微软专门为吞吐量优化的另一条产品线。**两者的关系更像服务器 CPU 与移动端高能效芯片:底层能力和指令体系接近,但资源预算、任务长度和服务成本完全不同。
| 项目 | MAI Code 2 | MAI Code 2 Flash | |---|---|---| | 核心定位 | 复杂、长链路软件工程 | 高频、低延迟日常编码 | | 典型任务 | 深度调试、多文件实现、重构、仓库级推理 | 代码解释、定向编辑、常规修复、快速迭代 | | 活跃参数 | 约 770 亿 | 约 120 亿 | | 总参数规模 | 约 2.8 万亿 | 约 3980 亿 | | 模型结构 | 稀疏 MoE Transformer、集成视觉编码器 | 稀疏 MoE Transformer、集成视觉编码器 | | 上下文窗口 | 约 105 万 Token | 约 105 万 Token | | 最大输入 | 92.2 万 Token | 92.2 万 Token | | 最大输出 | 12.8 万 Token | 12.8 万 Token | | 推荐用户 | 复杂项目、专业开发者、企业研发团队 | 高频调用、快速交互、成本敏感型团队 |
**稀疏 MoE 是一种每次只激活部分专家网络的模型架构。**MAI Code 2 虽然总参数约为 2.8 万亿,但一次推理只激活约 770 亿参数;Code 2 Flash 总参数约 3980 亿,每次激活约 120 亿。这样既可以保留较大的知识容量,又能避免每次请求都运行全部参数。(microsoft.ai)
**超过 100 万 Token 的上下文窗口,让两款模型能够一次读取大型仓库中的更多代码和文档。**不过上下文容量并不等于模型能稳定理解全部内容,微软也明确提示,当智能体会话变得很长时,模型仍可能重复调用工具、忽略已有代码、偏离指令,或者在完成验证前提前停止。
跑分说明了什么
**微软最值得关注的数据不是某个单项第一,而是 Code 2 与 Flash 在不同任务中的分工。**在使用 GitHub Copilot CLI、关闭子智能体并统一采用最高推理强度的测试中,Code 2 在 DeepSWE 1.1 和 TerminalBench 2.1 上明显领先 Flash,但 Flash 在 SWE Atlas 上反而略高。
| 基准测试 | MAI Code 2 | Code 2 Flash | 主要测试内容 | |---|---:|---:|---| | DeepSWE 1.1 | 73.2% | 59.9% | 跨语言、跨文件的软件工程任务 | | TerminalBench 2.1 | 84.6% | 78.3% | 沙箱终端中的多步骤执行任务 | | SWE Atlas | 43.1% | 44.8% | 仓库问答、测试编写与重构 |
**DeepSWE 1.1 是衡量模型能否在真实代码库中完成长链路工程任务的基准。**Code 2 在这一项目中领先 Flash 13.3 个百分点,说明规模和推理预算对于复杂修改仍然重要。
**TerminalBench 2.1 是衡量模型能否在 Linux 终端中规划、执行并验证多步骤任务的基准。**Code 2 得分为 84.6%,Flash 为 78.3%,差距只有 6.3 个百分点,表明轻量型号并没有因为成本更低而失去基本的工具调用能力。
**SWE Atlas 的结果则提醒用户,模型越大并不意味着每类任务都更好。**Flash 得分为 44.8%,比 Code 2 高出 1.7 个百分点;对于仓库问答、测试编写或目标明确的重构任务,较短的推理链和更聚焦的输出可能反而更有效。上述数据来自微软模型卡中的统一评测配置,仍需结合具体代码库验证。(microsoft.ai)
微软把价格压到了什么程度
**MAI Code 2 的竞争策略不是绝对最强,而是在接近前沿模型性能的情况下显著压低单次任务成本。**微软称,在 DeepSWE 1.1、TerminalBench 2.1、SWE Atlas 和 FrontierCode 1.1 四项日常企业编码基准的平均结果中,Code 2 达到 GPT-6.1 Sol 约 98% 的性能,成本约为后者的 40%;相较 Claude Opus 5.5,它达到约 96% 的性能,成本只有 5%。(microsoft.ai)
**GitHub Copilot 当前为两款模型提供了截至 2027 年 5 月 17 日的推广价格。**MAI Code 2 每百万输入 Token 为 0.50 美元、缓存输入为 0.025 美元、输出为 2.50 美元;Code 2 Flash 分别为 0.05、0.005 和 0.25 美元。推广期结束后,两款模型的公开价格均计划翻倍。(docs.github.com)
| 模型 | 输入价格/百万 Token | 缓存输入 | 输出价格/百万 Token | 当前定位 | |---|---:|---:|---:|---| | MAI Code 2 | 0.50 美元 | 0.025 美元 | 2.50 美元 | 高性能复杂编码 | | Code 2 Flash | 0.05 美元 | 0.005 美元 | 0.25 美元 | 低延迟高频编码 | | GPT-6 Luna | 0.10 美元 | 0.01 美元 | 0.50 美元 | 轻量通用模型 | | Claude Haiku 5.5 | 0.10 美元 | 0.01 美元 | 0.50 美元 | 轻量快速模型 | | Claude Opus 5.5 | 4.00 美元 | 0.20 美元 | 20.00 美元 | 高性能复杂推理 |
**“成本只有竞品的多少”指的是完成任务的综合成本,不只是 Token 标价的简单比例。**综合成本还会受到模型输出长度、失败重试次数、工具调用次数和推理强度影响。例如 Code 2 Flash 的 Token 标价约为 GPT-6 Luna 的一半,但微软给出的任务级成本比例为 65%,两者并不矛盾。
**Code 2 Flash 的推广价只有上一代 MAI-Code-1.1-Flash 的四分之一左右。**后者在 GitHub Copilot 中的价格为每百万输入 Token 0.20 美元、输出 Token 1.20 美元;新模型不仅输入价格下降 75%,输出价格也下降约 79.2%。微软正在用非常激进的价格,推动自研模型成为 Copilot 的默认工作负载,而不只是模型选择器里的备选项。
前端能力是一个意外重点
**MAI Code 2 不只强调后端逻辑,还专门优化了仪表盘、数据可视化和前端界面生成。**在覆盖用户界面、游戏、数据图表、3D 场景和 SVG 的盲测中,258 名评测者有 67% 更偏好 Code 2 生成的结果,而不是 GPT-6 Sol 的结果。(microsoft.ai)
**视觉编码是指模型直接理解截图、设计稿、图表或界面原型,并将其转换为可运行代码。**Code 2 与 Flash 均集成视觉编码器,因此开发者可以让模型分析错误截图、读取架构图,或者根据 UI 原型修改前端,而不必先把所有视觉信息翻译成文字。
**这项能力对微软尤其重要,因为它可以同时服务 GitHub Copilot、Power Apps、Excel 和 PowerPoint。**微软已经从 Code 2 Flash 进一步优化出 MAI Work Flash,用同一套基础模型服务 Microsoft 365 和 Fabric IQ。换句话说,代码模型的成本优化最终会被复用到表格、演示文稿、数据查询和企业自动化,而不只体现在 IDE 里。
谁现在可以使用
**两款模型已在 GitHub Copilot 正式上线,但覆盖的套餐不同。**MAI Code 2 面向 Copilot Pro、Pro+、Max、Business 和 Enterprise;Code 2 Flash 的覆盖面更广,包括 Free、Student 以及全部付费套餐。GitHub 表示,两款模型目前面向符合条件的年度订阅用户开放。(github.blog)
**支持的入口已经覆盖微软主要开发工具链。**开发者可以在 VS Code、Visual Studio、JetBrains IDE、Xcode、Eclipse、Copilot CLI、GitHub 网站、GitHub Mobile、Copilot cloud agent 和 Copilot app 的模型选择器中使用它们。
**Code 2 Flash 还进入了 Microsoft Foundry 的限量预览。**Foundry 中提供的是托管模型服务,支持文本和图像输入,并可通过兼容 Responses 规范的接口接入应用;MAI Code 2 暂未宣布通过 Foundry 向所有开发者开放。因此对多数用户来说,GitHub Copilot 仍是体验 Code 2 的主要入口。
**上一代 MAI-Code-1.1-Flash 将于 2026 年 12 月 18 日退出全部 GitHub Copilot 场景。**企业管理员需要在此之前检查模型策略,并将固定使用旧型号的团队工作流切换到最新 Flash 模型。(github.blog)
双线布局比单一旗舰更实际
**微软的目标不是靠 MAI Code 2 赢下一张排行榜,而是控制 Copilot 每一次推理的成本和体验。**GitHub Copilot 每天面对的是数量巨大的代码解释、补丁生成、测试修复和仓库问答请求,如果所有任务都交给最昂贵的前沿模型,企业很难长期承担费用,微软自己的毛利空间也会受到挤压。
**Code 2 与 Flash 的组合,本质上是一套模型路由架构。**复杂重构、疑难调试和长链路任务可以交给 Code 2;代码解释、格式调整、小范围修复和快速试错则交给 Flash。未来如果 Copilot 能够根据任务难度自动路由模型,开发者甚至不需要手动选择,就能在速度、质量和成本之间取得更合理的平衡。
**这套布局也在降低微软对外部模型供应商的结构性依赖。**Copilot 仍会提供 OpenAI、Anthropic、Google 等公司的模型,但只要大量日常请求能够转向微软自研模型,微软就可以掌握更完整的训练反馈、推理基础设施和产品定价权。
**对开发者而言,MAI Code 2 最值得测试的不是单轮代码生成,而是补丁能否真正进入主分支。**模型生成代码的速度已经不是主要问题,更重要的指标是它能否理解项目约束、复用现有模块、跑通测试、避免引入安全漏洞,并减少人工返工。
**Code 2 Flash 则可能是本次发布中更具商业影响力的型号。**它的绝对性能不如 Code 2,但价格低一个数量级,并向 Copilot Free 和 Student 用户开放;对于高频调用的团队,成本差异很可能比少数复杂基准上的得分差异更重要。
仍然需要保持谨慎
**微软明确表示,两款模型尚未针对基础科学研究和超长周期智能体任务进行优化。**这意味着它们适合数分钟到数小时的软件工程工作,却不应被理解为可以长期无人监督地负责完整项目。
**百万 Token 上下文也不能消除智能体漂移。**模型卡指出,长会话中仍可能出现重复工具调用、未充分利用现有代码、偏离用户指令和验证不完整等问题;更高推理强度还会增加延迟与 Token 消耗,而且不保证结果一定更好。(microsoft.ai)
**非英语和小众技术栈的表现仍缺乏充分验证。**对于中文注释较多的仓库、内部 DSL、老旧框架或安全关键系统,团队仍需建立代码审查、测试和权限隔离流程,不能因为模型在公开基准上得分较高就直接允许其自动合并代码。
OpenAI Hub 观点
**MAI Code 2 家族标志着微软的自研代码模型从“补充运力”进入“正面竞争”阶段。**Code 2 已经具备承担复杂工程任务的基本资格,Flash 则通过极低价格守住高频流量,两者共同构成一套比单一旗舰模型更适合企业部署的产品组合。
**真正决定它们能否成功的,不是微软公布的 98% 或 96%,而是 Copilot 用户是否愿意长期保留这些模型生成的代码。**如果 Code 2 能在真实仓库中减少返工,Flash 能在高并发场景中保持稳定,微软就可能把 Copilot 从“调用多家模型的开发工具”,逐步变成“由微软自研模型驱动、外部模型补充”的平台。
**对于开发者,现阶段最合理的策略是按任务分级,而不是追求一个万能模型。**涉及架构调整、跨文件调试和复杂测试时优先尝试 Code 2;面对代码解释、小型补丁、重复修改和快速迭代时优先使用 Flash。微软这次发布的核心价值,正是让这种分级第一次有了足够明确的性能和价格基础。
参考来源
- GitHub Copilot 模型与价格:查看 MAI Code 2、Code 2 Flash 及主要竞品的最新 Token 价格。
- GitHub Copilot 支持的 AI 模型:查看两款模型的上线状态、客户端支持和扩展上下文能力。
- GitHub Copilot 模型对比:了解 Code 2 与 Flash 的官方推荐任务和能力定位。
- GitHub Copilot 模型托管说明:了解微软模型在 Copilot 中的托管方式与企业数据处理范围。