GitHub用AI漏洞降噪
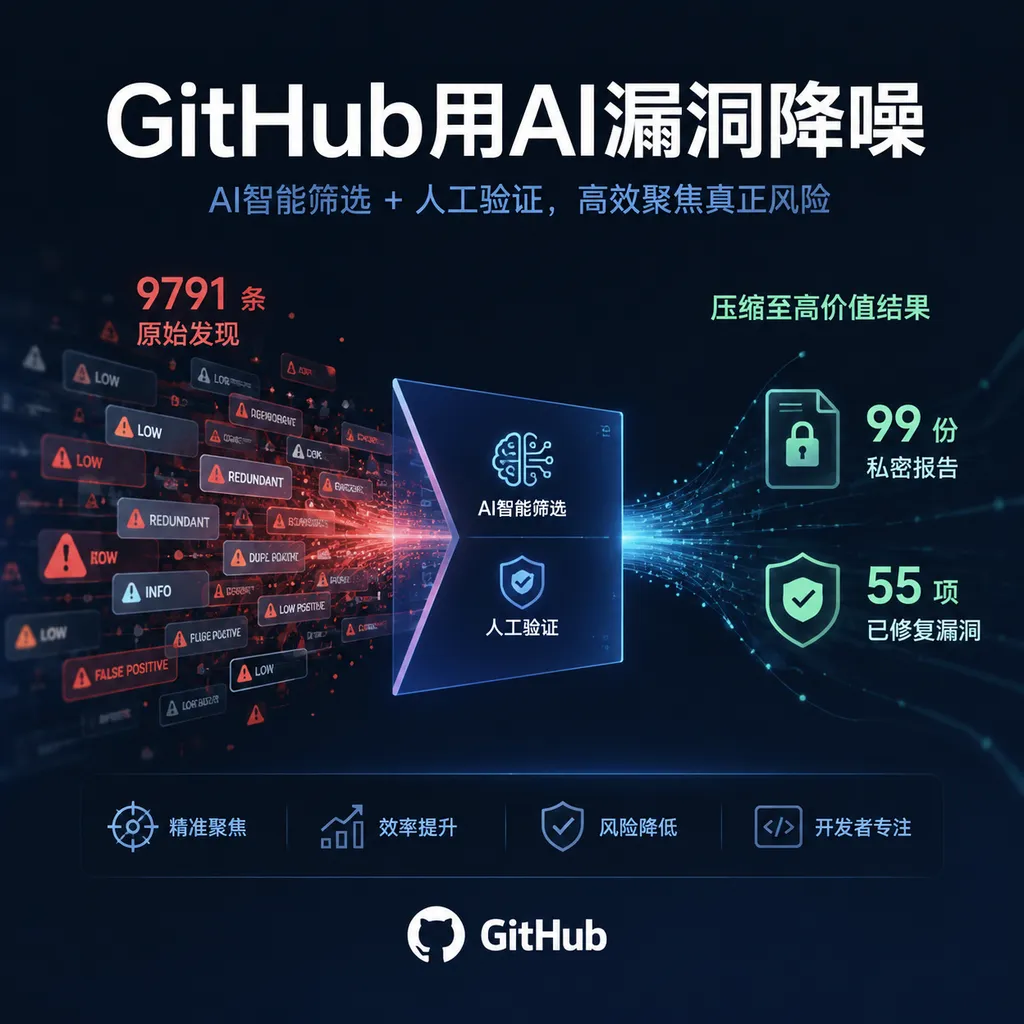
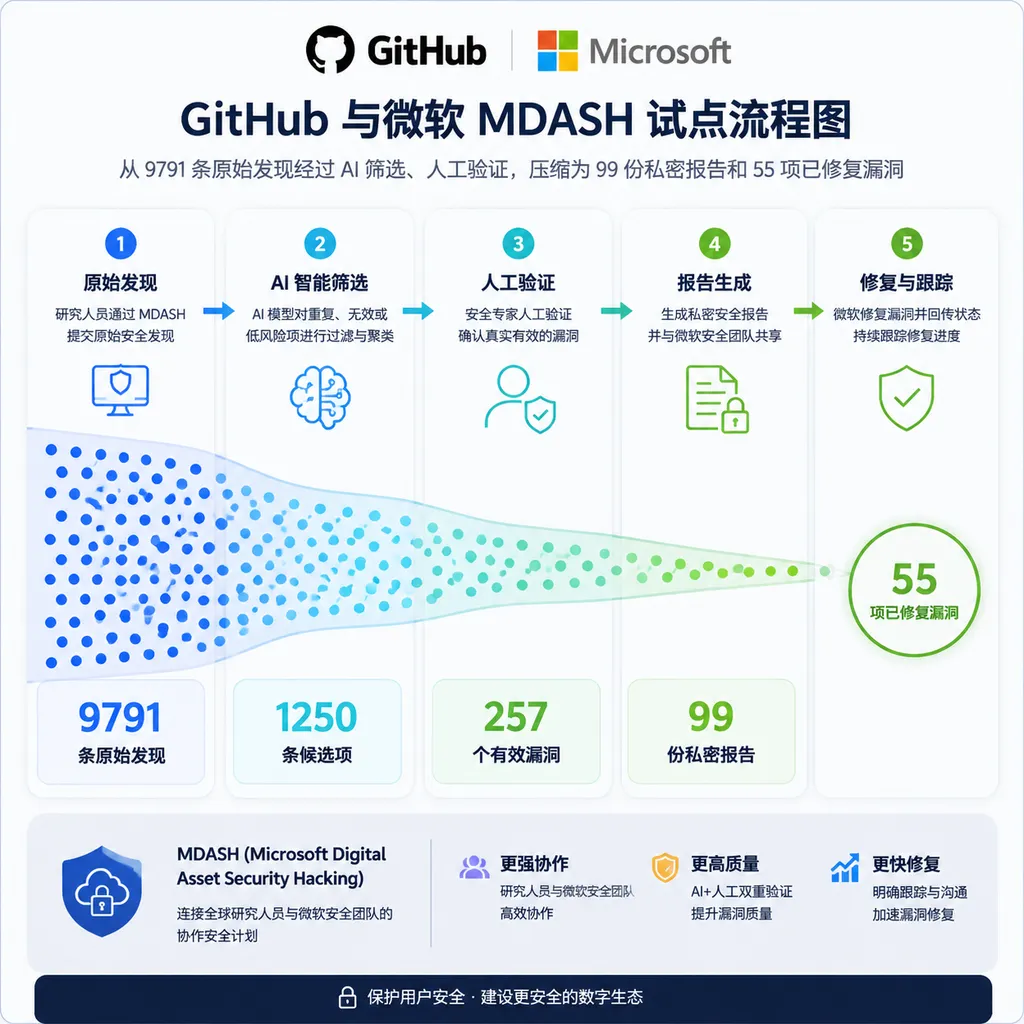
GitHub与微软通过MDASH试点,将9791条AI漏洞线索压缩为99份经过验证的私密报告,其中55项已修复。试点证明,AI安全工具的真正价值不在发现更多问题,而在交付可验证、可合并的修复方案。
GitHub用AI漏洞降噪:9791条线索,最终只交付99份报告
GitHub与微软今天公布了代号为MDASH的开源安全试点结果:系统在6个广泛使用的开源项目中发现9791条潜在问题,经过AI去重、风险筛选和人工验证后,最终只向维护者提交了99份私密漏洞报告。截至2026年11月15日,其中55项已经修复,14项修复已经进入正式发布版本。(github.blog)
这组数字最值得关注的不是AI发现了近万个问题,而是GitHub主动丢掉了其中约99%。
换算下来,只有约1.01%的原始发现进入维护者的待办列表;99份正式报告中已有55份得到修复,修复率约为55.6%。这说明GitHub和微软正在重新定义AI漏洞扫描的交付标准:扫描器不能把模型生成的全部怀疑都扔给维护者,而应该对报告的真实性、影响范围和修复可行性负责。
MDASH不是一个单独找漏洞的模型
Codename MDASH是微软开发的多模型代理式代码扫描系统,通过多个模型和100多个专业安全代理协作,完成代码风险排序、漏洞发现、证据验证、重复项合并和修复建议生成。
它与传统静态分析工具最大的区别,是不只检查某段代码是否匹配已知危险模式,而是尝试理解数据如何进入程序、权限如何传递、不同函数如何组合,以及攻击者能否真正到达有问题的代码路径。微软目前将其定位为Microsoft Defender中的代理式代码扫描器,并以预览形式提供相关能力。(learn.microsoft.com)
MDASH的技术流程可以概括为四步:
- Prepare:确定高风险代码。 系统结合调用图、代码复杂度和历史修改等信息,对文件和函数进行风险排序。
- Scan:让专业代理分工审查。 注入、内存安全、身份验证绕过等不同类型的代理分别检查对应攻击面。
- Validate:验证漏洞是否成立。 系统利用污点分析、类型解析和多个模型之间的交叉判断,补充漏洞证据并排除误报。
- Dedup:合并重复发现。 多个代理发现同一根因时,系统把它们压缩成一项可处理的问题,而不是生成多份相似报告。
这种架构更像一支分工明确的安全团队,而不是一个把整个代码仓库塞进上下文窗口、然后要求模型“找漏洞”的聊天机器人。一个代理负责寻找未经验证的输入,另一个代理检查权限边界,还有代理负责判断攻击路径是否真实存在;最后,再由其他模型和分析工具交叉检查结论。
GitHub真正解决的是报告洪水
AI漏洞报告洪水是指大量自动生成、质量不稳定的安全报告集中涌向项目维护者,导致维护者需要花费更多时间排查误报、重复项和无法复现的问题。
这个问题在2026年已经从风险变成现实。根据GitHub安全公告数据库团队披露的数据,2026年第一季度,GitHub上的私密漏洞报告数量较2025年第四季度增长超过4倍;同期,提交给GitHub CVE编号授权机构的CVE ID申请量从约1100件增加到超过4000件。维护者接受报告的比例则从约32%下降到约27%,说明有效报告确实增加了,但审核压力也在快速上升。(ithome.com.tw)
传统安全扫描工具至少输出的是相对稳定的规则匹配结果,而生成式AI能够用自然语言批量包装尚未验证的猜测。报告看起来可能很专业,包含攻击描述、影响分析甚至概念验证,但底层问题可能只是模型误解了调用关系,忽略了上游校验,或者把理论上危险、实际上无法触达的代码当成漏洞。
这也是为什么“模型发现漏洞数量”正在变成一个越来越没有意义的指标。一个系统如果找到10000条候选问题,却需要项目维护者自己判断其中哪100条是真的,本质上只是把昂贵的推理和验证成本转移给了开源社区。
试点把验证责任留在发送方
GitHub MDASH试点的核心规则,是任何未经验证的AI发现都不能直接发给维护者。
整个流程由三层系统共同完成。第一层是微软MDASH及其使用的MAI Cyber模型,负责扫描代码、提出漏洞假设并生成建议修复;第二层是GitHub Security Lab基于定制Copilot能力构建的分流代理,负责去重、检查有效性并筛选高影响问题;第三层是微软FORGE Lab的安全研究人员,对剩余发现逐项进行人工验证。(github.blog)
验证通过后,报告才会通过GitHub的私密漏洞报告机制发送给维护者,并附上概念验证、具体代码位置和建议修复方案。漏洞细节、讨论记录和补丁都留在GitHub现有协作流程内,避免维护者在邮件、第三方平台和代码仓库之间来回搬运信息。
| 环节 | 主要执行者 | 交付内容 | 维护者是否需要参与 | |---|---|---|---| | 原始扫描 | MDASH、MAI Cyber | 数千条候选问题与初步修复建议 | 否 | | AI分流 | GitHub Security Lab代理 | 去重、有效性检查、影响筛选 | 否 | | 人工验证 | 微软FORGE Lab研究人员 | 可复现漏洞、攻击证据、风险判断 | 否 | | 私密报告 | GitHub安全协作流程 | 概念验证、代码位置、建议补丁 | 是 | | 最终修复 | 项目维护者 | 审核、修改、测试和发布补丁 | 是 |
这个流程把维护者放在最终决策者的位置,而不是免费测试员的位置。维护者仍然决定是否修复、如何修复以及何时发布,但不再需要从数千条未经验证的扫描结果中寻找真正的问题。
6个项目给出了比跑分更可信的答案
这次试点覆盖AutoGPT、Caddy、Express、FastMCP、ImageMagick和Netty,项目类型横跨AI代理、Web服务器、Node.js框架、MCP服务器框架、图像处理软件和Java网络框架。(github.blog)
项目选择本身很有代表性。Express和Netty位于大量互联网服务的底层,ImageMagick长期处理来自外部的不可信文件,Caddy直接暴露在网络边界,FastMCP则属于快速扩张的MCP工具链。相比只在专门设计的漏洞基准上跑分,这些真实项目更能检验AI安全系统是否理解复杂代码、项目约定和实际威胁模型。
| 试点指标 | 结果 | 意义 | |---|---:|---| | 参与项目 | 6个 | 覆盖网络、图像、AI代理和开发框架 | | 原始候选问题 | 9791条 | 展示多代理扫描的发现规模 | | 最终私密报告 | 99份 | 约占原始结果的1.01% | | 已修复问题 | 55项 | 占正式报告约55.6% | | 已进入发布版本 | 14项 | 修复已经开始覆盖下游用户 | | 人工验证团队 | 7名研究人员 | 关键结论仍需要专业人员把关 |
Caddy收到的22份报告全部在一周内完成修复,说明经过筛选的报告可以直接进入项目开发节奏,而不必经历漫长的真实性争论。AutoGPT的一份报告在相关代码上线三天后到达,维护者一天内完成了更完整的修复,并在不到一周内将其部署到生产环境。(github.blog)
ImageMagick的案例更能体现报告质量的价值。这个由两人维护的项目同样收到22份报告,其中一项问题因为准确指出漏洞类型和代码位置,维护者只用了约15分钟就完成修复;其维护者表示,普通安全公告通常需要30分钟到1小时才能阅读、理解并完成修复。(github.blog)
这些反馈说明,安全报告的最佳衡量单位不应该是“发现数量”,而应该是维护者从打开报告到合并补丁所需的时间。把平均处理时间从一小时压缩到15分钟,对一个只有两名维护者的项目而言,比再提高几个百分点的扫描召回率更有价值。
AI没有取代人工审核,反而暴露了审核成本
MDASH试点并没有证明AI已经能够独立完成开源漏洞研究,因为最终99份报告仍经过7名微软FORGE Lab研究人员逐项检查。
GitHub披露,研究人员平均需要为每个项目投入约两天验证时间。六个项目只是很小的样本,而开源生态包含数以百万计的活跃仓库,因此当前流程还无法无成本地扩展到整个GitHub。(github.blog)
这恰恰是本次试点最诚实的部分。很多AI安全产品会强调自动发现、自动验证和自动修复,却很少说明报告发布之前到底有多少人工参与。GitHub此次明确保留人工审核环节,意味着多模型辩论、污点分析和类型解析虽然能够显著压缩候选结果,但仍不足以承担最终披露责任。
人工审核也不是一个等待模型进步后就能完全删除的临时步骤。漏洞是否成立不仅取决于代码,还取决于项目威胁模型、部署方式、兼容性要求和维护者对风险的接受程度。模型可以证明某条攻击路径在技术上存在,却未必理解某个行为是不是项目刻意保留的设计。
MDASH与传统扫描器不是替代关系
传统静态应用安全测试是基于规则、数据流和程序结构发现代码风险的分析方法,优势是速度快、结果稳定、适合持续集成,缺点是难以理解跨模块业务逻辑和复杂攻击链。
MDASH更适合寻找规则难以覆盖的逻辑漏洞、组合型攻击路径和未知漏洞,但它的成本、延迟和不确定性也明显更高。微软文档显示,MDASH会记录扫描消耗的Token,并区分已经验证、需要人工检查和低优先级的发现,这意味着它并不是一个可以无限制运行的免费检查步骤。(learn.microsoft.com)
| 对比维度 | 传统静态分析 | 单模型AI扫描 | MDASH式多代理流程 | |---|---|---|---| | 核心机制 | 规则匹配、数据流分析 | 大模型阅读代码并推理 | 专业代理分工、模型交叉验证、工具验证 | | 扫描速度 | 快 | 中等 | 相对较慢 | | 结果稳定性 | 高 | 较低 | 高于单模型,但仍需验证 | | 逻辑漏洞能力 | 有限 | 较强 | 更强,适合复杂攻击链 | | 重复与误报 | 可预测 | 容易产生大量噪音 | 通过分流和去重压缩 | | 修复建议 | 模板化 | 可生成补丁 | 可结合漏洞证据生成补丁 | | 最佳用途 | 每次提交和CI检查 | 辅助代码审查 | 高价值仓库的深度安全审计 |
更现实的落地方式,是让传统工具负责每次提交的低成本筛查,让MDASH一类代理系统定期检查高风险模块,再由安全研究人员处理少量高置信度问题。用昂贵的多代理系统扫描每一行普通业务代码并不划算,但用它审查解析器、身份验证、网络协议和文件处理模块,可能明显提高投入产出比。
私密报告是AI漏洞研究的最低安全线
私密漏洞报告是研究人员在不公开漏洞细节的情况下,将问题直接提交给项目维护者的协作机制。
AI能够快速生成漏洞描述,也意味着错误报告和真实漏洞都可能更快公开传播。如果系统在补丁准备完成之前自动创建公开Issue,攻击者可能通过描述、调用路径或概念验证迅速复现漏洞,而下游项目仍然来不及更新依赖。
GitHub因此把私密报告设为试点的固定环节,并要求维护者预先同意扫描。这个规则看似保守,实际上非常必要:未经项目许可的大规模AI扫描不仅会制造维护负担,还可能违反项目安全政策,甚至在真实服务上触发危险测试。
这套做法也给独立安全工具划出了一条清晰标准:在发送AI生成的报告之前,至少应该完成去重、可达性检查、人工复现、私密披露和修复建议。缺少其中任何一项,都不应该把后续验证成本交给维护者。
GitHub正在把安全竞争从发现转向修复
GitHub此次试点真正有价值的地方,是承认“找到更多漏洞”已经不再等于“让软件更安全”。
生成式AI正在把漏洞发现的边际成本快速压低,但修复仍然受到维护者时间、测试资源、版本兼容性和发布周期限制。供给无限增长、处理能力基本不变的结果,只会是报告队列越来越长。
MDASH试点给出的解法不是再训练一个更会找漏洞的模型,而是在模型和维护者之间增加完整的责任链:AI负责搜索,分流代理负责降噪,研究人员负责验证,平台负责私密协作,维护者负责最终决策。每一层都减少下一层需要处理的信息量。
GitHub接下来计划把这些经验带入私密漏洞报告和安全公告流程,并为GitHub Secure Open Source Fund的往届项目提供经过验证的AI安全扫描。该基金目前已覆盖216个项目和300多名维护者,累计推动修复超过4000个漏洞,相关软件下载量每月超过200亿次。(github.blog)
这仍然只是一次早期试点。样本只有6个项目,人工审核成本也没有消失,但它至少证明了一件事:开源维护者不需要一台更高产的报警器,而需要一套能把9791条怀疑压缩成99项行动、并把其中55项真正关闭的系统。
对于AI安全行业而言,下一阶段最重要的指标可能不再是基准测试分数,也不是发现了多少个疑似漏洞,而是三个更朴素的问题:有多少报告经过了验证,有多少补丁被维护者接受,又有多少修复最终进入了用户正在运行的软件。
参考来源
- iThome:AI开始进入漏洞研究与通报生态:整理MDASH、GitHub私密漏洞报告增长和AI辅助漏洞研究的行业背景。
- GitHub:AutoGPT项目:本次MDASH试点参与项目之一。
- GitHub:Caddy项目:本次试点中收到22份报告并快速完成修复的Web服务器项目。
- GitHub:Express项目:参与试点的Node.js Web框架。
- GitHub:FastMCP项目:参与试点的MCP服务器开发框架。
- GitHub:ImageMagick项目:参与试点的图像处理项目,由小型维护团队负责。
- GitHub:Netty项目:参与试点的Java网络应用框架。