AI写得更快,审查却堵了
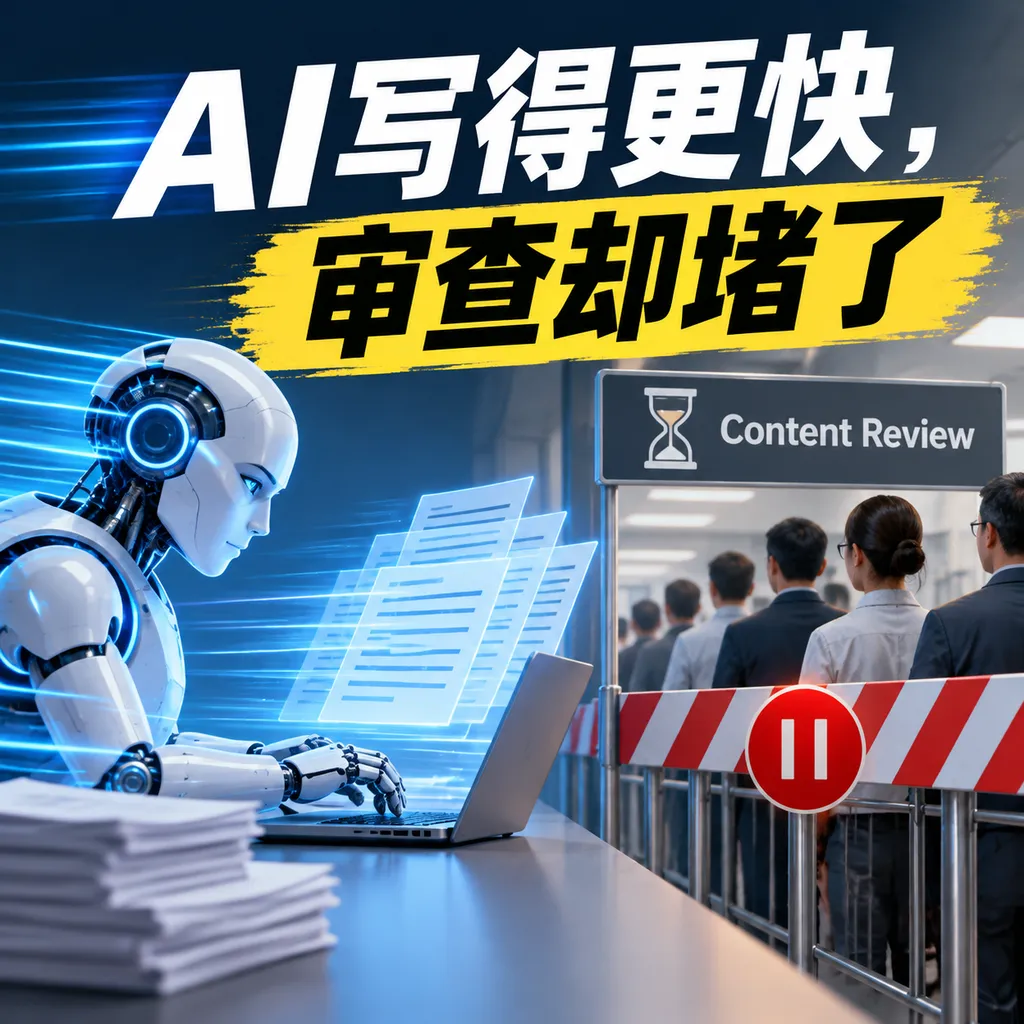
哈佛最新研究显示,AI 编程 Agent 让代码和 PR 数量快速增长,但交付增幅远未同步,代码审查正成为研发团队的新瓶颈。
AI 写得更快,审查却堵了
哈佛研究人员最新修订的一份工作论文指出,AI 编程 Agent 显著提高了代码产量,却没有带来同等幅度的软件交付增长,新增产能大量堆积在代码审查环节。
截至 2026 年 11 月 18 日,这份题为《Artificial Intelligence in the Firm: Bottlenecks in Software Production》的论文已经更新至 11 月版本。研究覆盖 655 家企业、720,542 名员工和约 4.45 亿条工作事件,数据横跨 2021 年 1 月至 2026 年 8 月,包括 GitHub 代码活动、Jira 任务和日历协作记录。(econjobmarketcandidates.com)
**AI 编程 Agent 是能够自主读取代码仓库、规划修改、调用开发工具、运行测试并提交代码变更的软件代理。**它和早期的代码补全工具不是同一种生产资料:补全工具加快一名工程师敲代码的速度,Agent 则允许一名工程师同时启动多个任务流,把代码生产从串行劳动变成并行调度。
问题是,人类 Reviewer 并没有因为 Agent 增加而自动扩容。
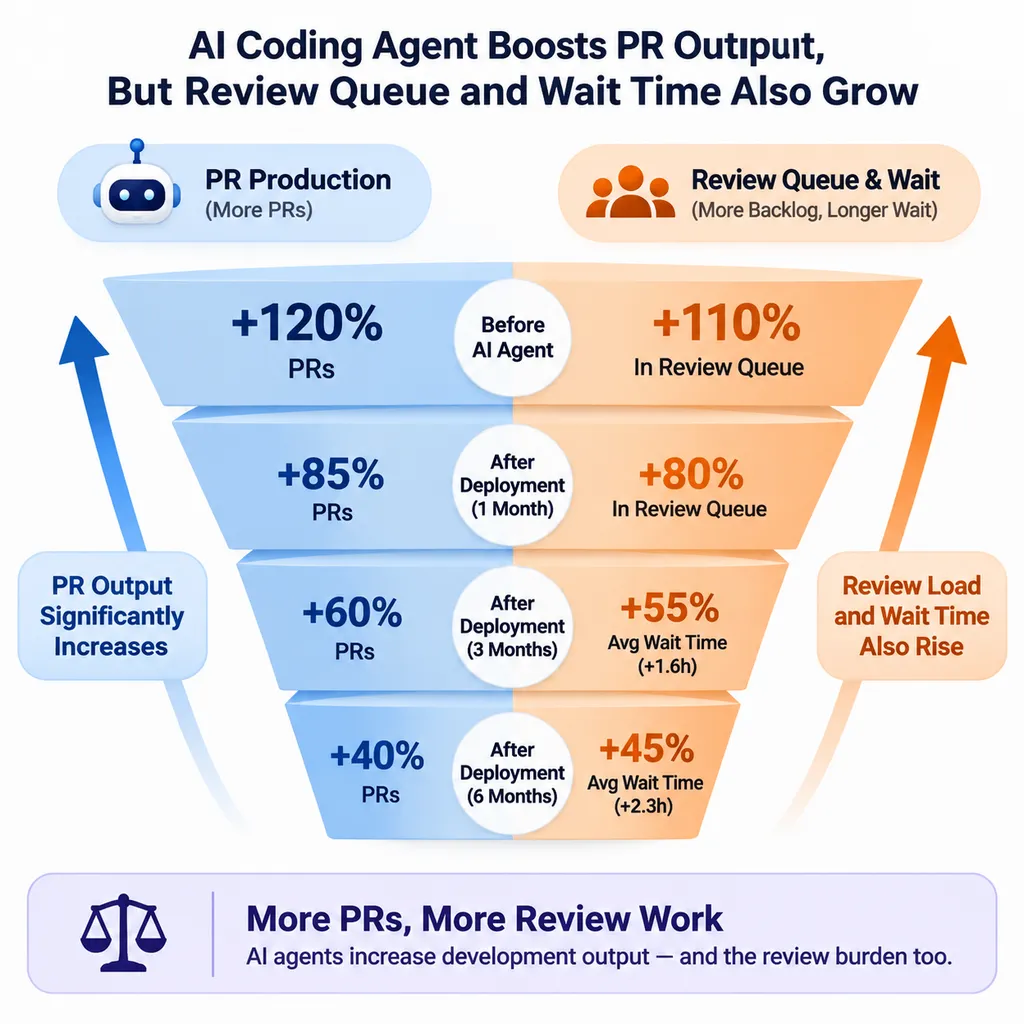
代码多了 44%,完成任务只多了约 14%
研究中最值得关注的不是 Agent 能写多少代码,而是这些代码最终有多少变成了可部署的软件。
企业采用 AI 编程 Agent 约 12 个月后,每名员工新增代码行数提高 44.0%,Commit 数提高 36.0%,创建的 Pull Request 数提高 35.7%;但合并的 PR 只提高 26.0%,解决的 Jira Issue 仅提高 13.7%,而且后者没有达到传统统计显著性标准。(crewmark.ai)
| 指标 | 采用 Agent 后的变化 | 说明 | |---|---:|---| | 新增代码行数 | +44.0% | 代码生产速度明显提升 | | Commit 数 | +36.0% | 修改频率和任务并行度上升 | | 创建 PR 数 | +35.7% | 更多代码进入审查队列 | | 合并 PR 数 | +26.0% | 审查与修复消化了部分增量 | | 已解决 Jira Issue | +13.7% | 最终任务产出远低于代码增幅 | | PR 提交至批准时间 | +56.1% | 代码在审查环节停留更久 | | 审查队列等待时间 | +59.9% | Reviewer 响应能力成为稀缺资源 | | 活跃审查时间 | +58.5% | 单个变更需要更多理解和核验 | | 每个变更的评论数 | +38.6% | 沟通、质疑和返工同步增加 |
这组数据说明,AI 的确提高了局部生产率,但局部生产率并不等于系统吞吐量。
一条软件交付流水线通常包括需求定义、方案设计、编码、代码审查、测试、安全检查、部署和线上验证。Agent 只要把编码阶段从 8 小时压缩到 2 小时,代码就会更早、更密集地涌向下游;如果 Reviewer、测试环境和发布制度没有变化,节省的 6 小时不会全部变成交付收益,而会变成等待队列。
这更像高速公路扩建了入口车道,却没有增加收费站窗口。车进入得更快,不代表离开得更快。
真正稀缺的资源变成了“确认代码正确”
**代码审查是团队在合并代码前,对其正确性、可维护性、安全性和业务一致性进行验证的过程。**传统 Review 往往建立在一个隐含前提上:提交代码的人理解需求、经历过实现过程,也知道为什么选择当前方案。
AI 生成的代码打破了这个前提。
Reviewer 面对人类同事提交的 PR,可以结合对方的经验、历史讨论和团队分工推测其设计意图;Reviewer 面对 Agent 提交的 PR,则必须重新建立这条因果链:Agent 如何理解需求、读取了哪些上下文、忽略了哪些限制,以及测试通过究竟证明了什么。
因此,AI 代码最危险的地方通常不是语法错误,而是“看起来完全合理”。它可能成功编译、通过已有测试、使用标准设计模式,却在业务边界、权限控制、并发状态或数据迁移上做出错误假设。
微软开源的 CABRA 评测框架也指向类似问题:当任务需要跨函数追踪、运行时分支判断或在大量干扰代码中定位语义差异时,Agent 的准确率会随理解复杂度上升而下降。Agent 往往擅长找到并修改代码,却未必真正掌握代码为什么存在。(github.com)
这意味着,仓库中的隐性知识正在成为 Agent 的能力上限。
老工程师知道某个字段不能改名,是因为三年前还有一个没有文档的外部系统依赖它;老工程师知道某段重复代码不能抽象,是因为两个业务分支正在逐渐分化;Agent 能看到代码、测试和文档,却看不到没有被记录的事故复盘和口头约定。
AI 审查 AI,不是简单地再加一个模型
**验证债务是团队生成代码的速度超过验证能力后,逐渐积累的未确认风险和审查工作。**它和技术债不同:技术债是已知设计缺陷对未来开发的拖累,验证债务则是团队不知道某段代码是否真正正确,却因为队列压力暂时选择合并。
用另一个 AI Reviewer 检查 Agent 代码,可以缓解验证债务,但不能自动消除它。
生成 Agent 和审查 Agent 可能共享类似的模型偏好、训练数据和推理盲区。一个模型因为缺少业务上下文做出错误假设,第二个模型也可能认为这个假设“很常见、很合理”,然后给出通过意见。两个概率系统彼此认可,并不等于确定性证明。
AI Review 更适合承担可重复、可标准化和高覆盖率的初筛工作,包括总结 Diff、识别常见安全模式、检查异常处理、发现测试缺口、定位重复实现,以及把大型 PR 拆成便于阅读的逻辑模块。PR-Agent 等开源项目已经能够在 Pull Request 中自动生成描述、提出改进建议,并根据团队规则定制审查重点。(github.com)
人类 Reviewer 则应该把注意力留给模型最难判断的部分,包括需求是否正确、架构边界是否被破坏、数据含义是否变化、风险是否可接受,以及这段代码是否值得长期维护。
| 审查层级 | 更适合的执行者 | 重点问题 | |---|---|---| | 格式与基础规则 | Linter、类型系统 | 是否符合明确、确定的规则 | | 已知漏洞模式 | SAST、依赖扫描工具 | 是否命中可机器识别的风险 | | 行为正确性 | 单元测试、契约测试、端到端测试 | 输入输出是否符合可执行规范 | | Diff 解释与初筛 | AI Reviewer | 哪些文件变化最大、可能遗漏什么 | | 业务与架构判断 | 资深工程师、领域负责人 | 修改是否真正解决问题、是否引入长期风险 | | 上线效果 | 灰度发布、监控与回滚机制 | 真实环境是否出现预期外行为 |
这套分层机制的关键,是不要让同一种验证方式承担所有责任。
团队需要限制 PR 流量,而不是鼓励 Agent 无限开工
Agent 带来的第一个管理错觉,是任务启动成本接近于零,所以任务应该尽可能并行。
一名工程师可以同时让 Agent 修改接口、补测试、升级依赖、重构模块和排查 Bug,但 Reviewer 仍然需要逐个恢复上下文。并行任务越多,团队在不同 PR 之间切换的成本越高,冲突、重复修改和过期分支也越多。
限制在制品数量是比追求 PR 数量更有效的做法。团队可以给每名工程师或每个模块设置未审查 PR 上限,在旧 PR 获得结论前,不允许 Agent 持续制造新 Diff。这个规则看似压低了 Agent 利用率,实际上提高了整条流水线的完成率。
小 PR 也比大 PR 更适合 Agent 时代。
一个 PR 应该只证明一个明确命题,例如“修复重复扣款时的幂等判断”,而不是同时重构支付模块、替换 ORM、补充日志并升级依赖。变更越聚焦,Reviewer 越容易判断需求、代码和测试是否形成闭环,Agent 也越容易根据反馈进行局部修正。
高质量交付不应只有 Diff,还要有证据包
Agent 提交代码时只给出 Diff,已经不足以支持高效审查。
团队可以要求每个 Agent PR 同时附带一份结构化证据包,包括任务目标、关键假设、影响模块、没有修改的范围、测试执行结果、已知风险和回滚方式。证据包的作用不是让 Agent 多写一段总结,而是迫使它显式暴露自己的推理边界。
一份实用的 Agent 交付清单至少应回答以下问题:
- 这次修改试图满足哪一条验收标准?
- Agent 读取了哪些代码、文档和历史决策?
- 哪些行为通过自动化测试得到证明?
- 哪些结论只是基于假设,尚未得到验证?
- 是否修改了接口、数据库结构、权限或并发逻辑?
- 如果上线失败,最小回滚路径是什么?
这套机制会让 Review 从“阅读几百行陌生代码”变成“检查证据是否足以支持结论”。
仓库是否容易被机器理解,将成为新的工程竞争力
AI 编程工具之间的模型差距会不断缩小,但不同代码仓库对 Agent 的友好程度不会自动趋同。
测试完善、模块边界清晰、架构决策有记录的仓库,会让 Agent 更容易定位修改范围,也让 Reviewer 更快验证结果。依赖混乱、命名模糊、测试脆弱的仓库,即使接入更强的模型,也只会更快地产生难以确认的代码。
团队应该把过去只服务于人的工程规范,升级为同时服务于人和 Agent 的机器可读约束,包括维护清晰的贡献指南、目录职责、接口契约、CODEOWNERS、架构决策记录和可重复测试环境。
这种投入的收益不只体现在生成阶段,也体现在审查阶段。Agent 越能解释自己依据了哪些规则,Reviewer 越不需要从零猜测它的意图。
衡量 AI 效率,也要从“产量”切换到“交付”
代码行数、Commit 数和 PR 数正在成为越来越危险的 AI 效率指标。
这些数字主要衡量代码进入系统的速度,却无法说明代码是否被接受、是否反复返工、是否增加 Reviewer 负担,更无法说明功能是否安全到达用户手中。一个团队的 PR 数增长 40%,如果审查等待时间增长 60%,这不叫效率提升,只是库存增加。
更合理的指标应该覆盖完整交付链路:
- 从任务开始到生产部署的 Lead Time;
- PR 首次响应时间和总审查时间;
- 每个 PR 的人工审查分钟数;
- 首轮通过率和修改轮次;
- 上线后缺陷率与回滚率;
- 自动化测试发现缺陷的比例;
- Reviewer 在架构和业务问题上的时间占比。
管理者真正需要回答的问题,也不再是“团队生成了多少 AI 代码”,而是“每交付一个正确变更,需要消耗多少稀缺的人类判断”。
程序员的角色正在从生产者变成验证者
AI 编程 Agent 没有降低高级工程能力的重要性,反而把它从实现细节推向了问题定义和结果验证。
未来更有价值的工程师未必是亲手写代码最多的人,而是能够把模糊需求变成可验证规格、识别系统边界、设计失败场景,并建立自动化证据链的人。初级工程师的成长路径也需要调整:如果基础编码大量交给 Agent,他们必须通过阅读、测试和质疑 Agent 产出来建立判断力,而不能只学会接受生成结果。
这场变化对团队提出了一个更难的问题:当写代码越来越便宜时,谁来承担“证明代码正确”的成本?
哈佛研究给出的答案并不是停止使用 Agent,而是不要把编码速度误认为交付速度。AI 已经把软件工程中最昂贵的环节,从实现逐渐推向验证;下一轮研发工具竞争,争夺的也不会只是更高的代码生成量,而是谁能用更少的人类注意力,建立更可信的交付证据。
参考来源
- 知乎:AI 编程真正的瓶颈,正在从“写代码”转向“验证代码”:从工程实践角度讨论隐性知识、测试和验证能力的重要性。
- GitHub:Microsoft CABRA:微软用于评估 Coding Agent 代码理解能力与复杂度退化的开源框架。
- GitHub:GitHub Copilot Coding Agent Dataset 2026:记录 Agent 运行时间、Token、工具调用和缓存行为的公开数据集说明。
- GitHub:PR-Agent:面向 Pull Request 描述、审查和改进建议的开源 AI Review 工具。