Cerebras拆开推理,吞吐翻5倍
Cerebras将大模型推理的预填充与生成阶段分配给不同硬件,实测每兆瓦吞吐提升至5倍。它优化的不只是芯片性能,而是整个推理集群的调度与功耗经济性。
Cerebras拆开推理,吞吐翻5倍
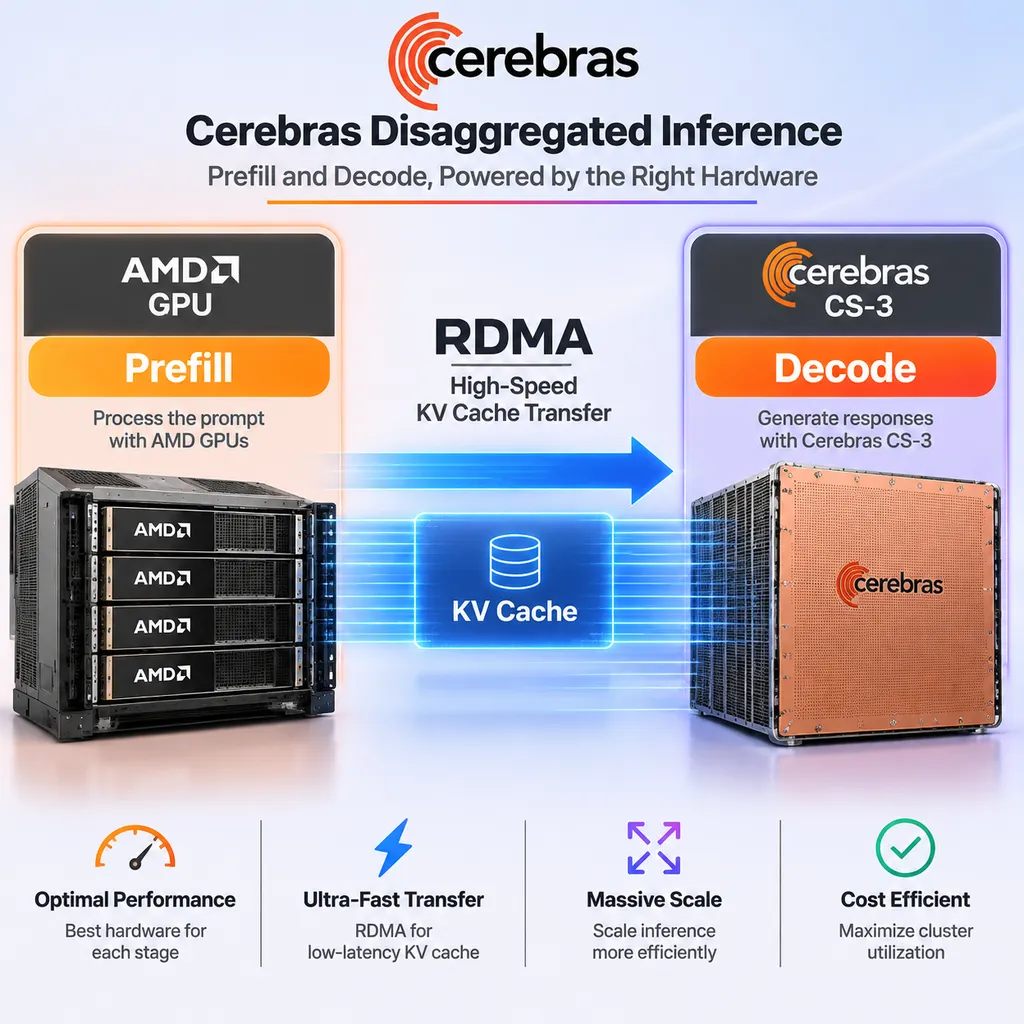
Cerebras在11月17日正式推出Disaggregated Inference,将大模型推理中的预填充与生成阶段拆到两组硬件上运行,并已在Cerebras Inference Cloud投入生产。官方称,AMD Instinct GPU负责处理输入提示,Cerebras CS-3负责生成输出,在保持原有Token生成速度的同时,每兆瓦吞吐量达到纯CS-3方案的5倍。(cerebras.ai)
这不是一次模型升级,也不是简单地把服务器数量翻倍,而是对推理集群工作方式的重新分工。Cerebras真正想解决的问题是:既然读取提示词和逐Token生成答案是两类完全不同的任务,为什么还要强迫同一块芯片轮流完成?
先把推理拆成两件事
Disaggregated Inference,即分离式推理,是把大模型推理的预填充阶段与解码阶段放到独立计算资源池中执行的系统架构。
一条大模型请求看起来只是“输入问题、输出答案”,但底层实际上包含两种计算特征差异很大的工作。
**Prefill,即预填充,是模型一次性读取全部输入Token,并计算注意力状态与KV Cache的阶段。**这一阶段包含大量矩阵乘法,可以并行处理,主要受计算能力、FLOPS和计算核心利用率限制。提示词越长,Prefill的计算压力越明显。
**Decode,即解码,是模型基于已有KV Cache逐个生成输出Token的阶段。**由于下一个Token依赖上一个Token,Decode无法像Prefill一样大规模并行,通常主要受内存容量、内存带宽和访问延迟限制。
两者的差别,可以类比为餐厅的备菜与出餐。Prefill要一次处理大量原料,适合拥有大量厨师和操作台的备菜团队;Decode则要按照订单顺序持续出菜,更依赖食材能否迅速送到手边。让同一批厨师在备菜与出餐之间不断切换,系统利用率很难达到最佳状态。
| 推理阶段 | 主要任务 | 计算特征 | 核心瓶颈 | 关键体验指标 | |---|---|---|---|---| | Prefill | 读取完整提示词、建立KV Cache | 高度并行、计算密集 | 算力、矩阵乘法吞吐 | TTFT首Token延迟 | | Decode | 逐Token生成输出 | 串行、访存密集 | 内存带宽、KV Cache读取 | ITL或TPOT生成间隔 |
**TTFT,即Time to First Token,是从请求发出到用户看到第一个输出Token的时间。**它决定应用是立即开始回应,还是长时间停留在加载状态。
**ITL,即Inter-Token Latency,是连续两个输出Token之间的时间间隔。**它决定文字流是否平滑,也是代码助手、语音交互和实时Agent能否保持互动感的关键指标。
传统推理服务器通常让Prefill与Decode共享同一组GPU。问题在于,当一个长上下文请求进入Prefill时,它可能占用大量计算资源,并打断正在持续生成Token的其他请求,造成输出速度抖动以及P95、P99尾部延迟恶化。
Cerebras的方案怎么工作
Cerebras此次生产方案的核心分工非常明确:AMD Instinct GPU处理Prefill,CS-3晶圆级系统处理Decode,两个资源池之间传递KV Cache。
**KV Cache是注意力机制保存历史Token键值状态的中间数据,用于避免模型在生成每个新Token时重新计算完整上下文。**在分离式推理中,Prefill节点计算完KV Cache后,必须将其准确而快速地交给Decode节点,后者才能继续生成答案。
Cerebras为此提供了名为KV Portal的软件接口,通过RDMA传输KV Cache等中间状态。RDMA允许设备直接访问远端内存,减少CPU介入和多次数据复制,但它并不能让传输成本归零;KV Cache体积、网络带宽、拓扑距离和拥塞情况,都会影响分离方案能否兑现收益。(cerebras.ai)
Cerebras同时提供两种集成路径:一套端到端软件栈负责请求路由、资源池健康管理、Prefill引擎和Decode引擎;另一套Decode-only SDK则允许基础设施厂商保留自己的调度框架与Prefill引擎,只接入Cerebras的Decode能力和KV Portal。
端到端方案的优势是部署更快,Decode-only SDK的优势则是控制权更强。对于已经采用vLLM、SGLang或自研推理平台的云厂商而言,后一种方式显然更现实,因为它不要求客户把整个Serving Stack推倒重来。
| 方案 | Prefill硬件 | Decode硬件 | KV传输 | 主要特点 | |---|---|---|---|---| | Cerebras生产部署 | AMD Instinct GPU | Cerebras CS-3 | KV Portal + RDMA | 每兆瓦吞吐达到纯CS-3方案的5倍 | | AWS合作架构 | AWS Trainium | Cerebras CS-3 | EFA高速网络 | 计划通过Amazon Bedrock提供服务 | | 常规GPU分离部署 | GPU Prefill池 | GPU Decode池 | NIXL、Mooncake等 | 可独立优化TTFT与ITL | | 传统聚合部署 | 同一GPU池 | 同一GPU池 | 无跨池传输 | 架构简单,但阶段之间会互相干扰 |
今年3月,AWS与Cerebras已经公布了类似路线:AWS Trainium处理Prefill,Cerebras CS-3负责Decode,并通过Elastic Fabric Adapter高速网络连接。此次发布意味着Cerebras不再只是在合作公告中描述架构,而是给出了生产环境中的实际部署结果。(press.aboutamazon.com)
5倍提升到底意味着什么
Cerebras所说的5倍并不是“所有请求延迟缩短80%”,而是单位功耗能够处理的Token吞吐达到原来的5倍。
官方测试基于11月14日Cerebras Inference Cloud上的共享GPT-OSS-120B端点,对比启用分离式推理前后的每兆瓦吞吐量,并将纯CS-3聚合方案归一化为1倍。结果显示,GPU负责Prefill、CS-3专注Decode后,每兆瓦吞吐达到5倍,同时Token生成速度没有下降。(cerebras.ai)
这个限定条件很重要。Cerebras并不是声称单台CS-3突然多出5倍性能,而是把原本占用CS-3资源的Prefill任务转移给另一组加速器,使有限的晶圆级系统可以持续执行更擅长的Decode任务。
换句话说,5倍提升来自“给CS-3增加了专职备菜团队”,而不是CS-3本身凭空变快。系统额外使用了Prefill硬件,因此评估经济性时必须同时计算GPU成本、网络成本、机架空间和调度复杂度,不能只看Cerebras晶圆数量没有增加。
这一点也解释了为什么开源框架对分离式推理的表述更克制。vLLM官方文档明确指出,其Disaggregated Prefilling功能主要用于分别调节TTFT与ITL、控制尾部延迟,并不保证吞吐量必然增加。(github.com)
Cerebras实现5倍每兆瓦吞吐的关键,不只是“拆开”本身,而是异构硬件组合。GPU擅长计算密集型Prefill,拥有片上大容量SRAM和高带宽的晶圆级引擎则专注于访存密集型Decode;如果只是把同型号、同配置的GPU机械地拆成两个池,收益可能主要表现为延迟稳定性,而不是吞吐量翻倍。
为什么Cerebras押注Decode
Cerebras认为,未来推理基础设施的核心矛盾会从训练算力转向高并发Token生成能力。
训练一个模型可能只发生几次,但部署后的模型会被调用数十亿次。尤其在Agent场景中,一次用户任务可能触发规划、工具调用、代码生成、结果检查和重试等多轮推理,最终产生的Token数量远高于普通聊天请求。
Decode的重要性也随着推理模型增长而上升。模型在最终回答之前生成更长的思考过程,意味着单次请求需要输出更多Token;如果每一步都依赖顺序生成,那么再强的并行计算能力也无法完全绕过内存访问瓶颈。
Cerebras给出的硬件解释是,晶圆级引擎拥有数十GB片上SRAM和每秒数十PB的内存带宽。公司声称,其片上SRAM容量约为典型GB300 GPU的350倍,内存带宽约为5400倍,因此可以在芯片上保留更多模型数据、层和并发请求,减少Decode过程对外部内存的依赖。(cerebras.ai)
这些数据目前主要来自Cerebras自己的硬件口径,不能直接等同于端到端应用性能。实际速度仍会受到模型并行方式、量化精度、批处理规模、上下文长度和并发请求结构影响,但其战略方向是清晰的:把昂贵的晶圆级资源集中投入最能体现架构优势的环节。
分离式推理不是Cerebras独有
分离式推理已经从单一厂商的差异化设计,逐渐变成大模型Serving Stack的共同方向。
vLLM已经提供实验性的Disaggregated Prefilling功能,通过不同实例分别运行Prefill和Decode,并使用KV Connector传输缓存。SGLang支持Prefill/Decode模式以及Mooncake、NIXL等传输后端;llm-d也把分离式Serving列为核心架构能力,由Router分别选择Prefill Pod与Decode Pod。(github.com)
NVIDIA同样在TensorRT-LLM与Dynamo体系中推进分离式Serving,通过智能路由、独立Worker和KV Cache传输调度不同阶段。这意味着Cerebras的真正差异不在“发现了Prefill与Decode不同”,而在于能否证明晶圆级硬件作为Decode专用设备,拥有比通用GPU更好的功耗与容量经济性。(github.com)
| 平台或框架 | P/D分离 | 异构硬件支持 | 主要卖点 | 当前限制 | |---|---|---|---|---| | Cerebras | 支持 | 强调GPU + CS-3 | 高速Decode、每兆瓦吞吐 | 依赖专有硬件与软件栈 | | vLLM | 实验性支持 | 取决于Connector | 分别优化TTFT与ITL | 官方不承诺吞吐提升 | | SGLang | 支持 | 支持多种后端 | 灵活路由与KV传输 | 部署和参数调优复杂 | | llm-d | 支持 | 支持多类加速器 | Kubernetes原生资源池调度 | 系统组件较多 | | NVIDIA Dynamo | 支持 | 主要围绕NVIDIA生态 | 数据中心级统一调度 | 对网络和集群规模要求高 |
真正难点在调度和网络
分离式推理把一个资源竞争问题,转换成了资源匹配、网络传输和跨池调度问题。
第一项挑战是Prefill与Decode资源比例。长提示词、短回答的搜索请求需要更多Prefill容量,而短提示词、长推理过程的Agent任务需要更多Decode容量;如果比例配置错误,一边会排队,另一边则会空闲。
第二项挑战是KV Cache传输。模型越大、上下文越长,KV Cache占用越高;如果网络传输时间接近甚至超过Prefill节省的时间,拆分就会得不偿失。Cerebras选择RDMA,AWS方案使用EFA,本质上都是在降低这笔“交接成本”。
第三项挑战是故障处理。一个请求现在会经过Prefill节点、网络传输、Decode节点和统一路由器,任何环节失败都可能导致请求重算,因此容量健康检查、超时处理和缓存生命周期管理会成为生产部署的核心能力。
第四项挑战是指标不能只看平均值。分离架构最有价值的场景往往不是把平均速度从100 Token/s提高到110 Token/s,而是在大量长上下文请求进入时,仍然保持稳定的Token输出,避免P95和P99延迟突然恶化。
我们的判断
Cerebras此次发布的价值,是把分离式推理从架构概念推进到了异构硬件的生产验证阶段。
5倍每兆瓦吞吐是一个足够醒目的数字,但它不应被理解为适用于所有模型和集群的通用结论。这个结果来自GPT-OSS-120B共享端点、AMD Instinct GPU与CS-3的特定组合,而且衡量的是功耗归一化吞吐,而不是每个用户都能直接感知到的5倍延迟下降。
更值得关注的是,推理集群正在从“同一种芯片包办所有工作”转向按阶段配置硬件。未来的大模型基础设施可能更像现代数据中心:CPU、GPU、专用Decode芯片、网络设备和缓存层各自负责不同任务,由软件调度系统把它们组合成一条完整流水线。
这条路线也会削弱单一加速器架构的锁定效应。只要KV Cache传输接口和调度框架逐渐标准化,Prefill与Decode硬件就可以分别采购、独立扩容,芯片厂商不再需要赢下完整推理流程,只要在其中一个阶段做到极致,就有机会进入大规模部署。
Cerebras计划在2027年底前,把分离式推理扩展到其云服务及合作伙伴部署中的数百兆瓦容量。AWS、Fireworks AI、Gimlet Labs和General Compute已成为早期合作方,这说明它瞄准的并不是一个实验室演示,而是下一轮推理数据中心的采购与架构标准。(cerebras.ai)
对于开发者而言,短期内可能不需要亲自维护两套硬件池,但会逐渐在云服务中感受到变化:首Token等待更稳定、长提示词不再拖慢其他请求、Agent连续执行多步任务时的输出抖动减少。对于推理服务商而言,问题则更加直接——在电力成为稀缺资源后,每兆瓦能产生多少可销售Token,可能比单块芯片的理论FLOPS更重要。
参考来源
- vLLM Disaggregated Prefilling:vLLM官方的Prefill与Decode分离设计、KV Cache连接器和性能边界说明。
- llm-d Disaggregated Serving:介绍Prefill/Decode资源池、请求干扰和集群调度机制。
- SGLang Model Gateway:包含SGLang的P/D分离路由与多资源池配置说明。
- NVIDIA TensorRT-LLM Disaggregated Serving:介绍Dynamo体系下的分离式推理工作流与KV Cache调度。