Lakegres让RAG少搬一次数据
Onehouse发布Lakegres向量检索,可直接索引现有Hudi与Iceberg表。247M向量测试中,热查询中位延迟为63.5毫秒。
Lakegres让RAG少搬一次数据
Onehouse在11月18日发布Lakegres向量检索,核心变化不是又多了一个向量数据库,而是让企业直接在已有的Apache Hudi与Apache Iceberg表上建立向量索引,不再先把数据复制到独立检索系统。按照官方公布的测试结果,Lakegres在约2.47亿条、1024维向量上实现了63.5毫秒的热查询中位延迟,并将索引构建时间压缩到18分钟。(onehouse.ai)
Lakegres是一个面向开放湖仓表的低延迟查询与检索层。 它通过PostgreSQL兼容协议提供分析查询、点查、全文检索和向量检索,但数据仍然保存在用户原有的对象存储和开放表中,并不要求迁移进一个新的关系数据库。
这件事真正值得关注的地方,是它试图拆掉RAG系统里长期存在的一条复制链路:数据先进入湖仓,再被切片和生成Embedding,随后复制到向量数据库,最后还要维护删除、更新、权限和版本同步。Lakegres的方案是把向量索引视为表的派生元数据,让索引跟着Hudi时间线或Iceberg快照一起变化。
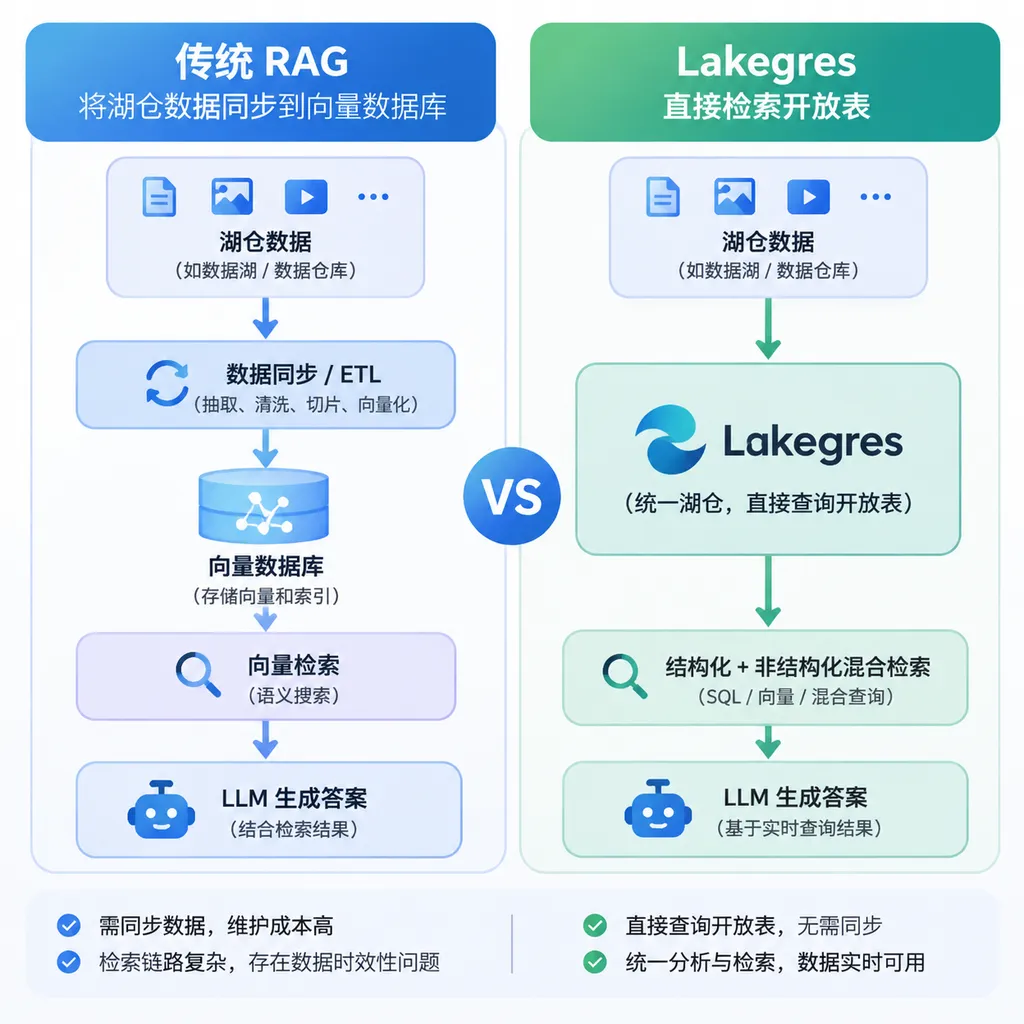
RAG为什么总要多维护一份数据
RAG是通过检索外部知识,为大模型生成过程补充可靠上下文的技术。 一套典型企业RAG系统至少包含原始文件、文本切片、元数据、Embedding向量和检索索引,其中最容易出现工程复杂度的环节不是生成向量,而是保持这些数据彼此一致。
传统架构通常把文档、工单、日志或商品数据保存在S3等对象存储中,再由Spark、Flink或批处理任务写入Iceberg、Hudi等湖仓表。检索侧则使用OpenSearch、Postgres加pgvector或独立向量数据库,因此同一份业务数据会形成湖仓副本和检索副本。
这个设计在千万级文档时尚可接受,但数据更新越频繁,问题越明显。源表删除一条记录,向量库需要同步删除;文档权限变化,检索系统需要重新应用过滤策略;Embedding模型升级,全部向量可能重新生成;同步任务延迟或失败,还会导致大模型检索到已经失效的内容。
Onehouse给出的判断很直接:企业Agent需要搜索的客服记录、产品目录、日志和历史事件往往已经在湖仓中,而这些数据集可能比典型Postgres实例大100至1000倍。把湖仓规模的数据复制进应用数据库,只为了获得向量搜索能力,成本和运维负担都很难忽略。(onehouse.ai)
Lakegres具体改变了什么
派生元数据是能够从基础表重建、但不改变基础数据文件的索引信息。 Lakegres把向量索引保存在表的元数据区域,并与原始数据文件放在同一个存储桶中;建立、删除或重建索引时,不需要重写原有Parquet、Lance或Vortex数据文件。
这意味着一张已经存在的Hudi或Iceberg表,只要包含向量列,就可以额外建立检索索引。原始完整向量仍然与文本、业务字段和元数据保存在基础表里,索引只保存聚类中心、量化状态、行定位信息以及用于快速评分的压缩编码。
Iceberg支持并不是重新发明一套封闭索引格式,而是建立在Apache XTable的跨格式索引工作之上。相关设计与Apache Hudi的RFC、实现代码和评审过程均在GitHub公开;目前Lakegres产品已经采用该设计,Hudi原生实现仍在向上游项目合并,XTable相关能力也处于开源发布准备阶段。(onehouse.ai)
| 方案 | 数据如何进入检索层 | 索引位置 | 数据更新后的工作 | |---|---|---|---| | Lakegres | 直接读取已有Hudi、Iceberg表 | 表元数据与原表同一存储体系 | 表提交同时维护索引增量 | | Databricks AI Search | 从Delta表同步到服务端点 | Databricks管理的独立存储 | 等待同步并维护服务端点 | | Snowflake Cortex Search | 从表同步到搜索服务 | Snowflake内部服务 | 由搜索服务刷新 | | AWS S3 Vectors | 将向量写入专用Vector Bucket | 与S3 Tables不同的存储类型 | 单独维护向量写入流程 | | pgvector或OpenSearch | 从湖仓抽取并写入数据库 | 数据库或搜索集群 | 自建CDC、批处理或同步任务 |
需要说明的是,以上并不意味着Lakegres完全没有额外存储。向量索引本身仍然要占用空间,也要消耗计算资源构建和压缩;它减少的是第二份完整检索数据、独立数据库集群和跨系统同步,而不是让索引成本凭空消失。(onehouse.ai)
它没有照搬HNSW
HNSW是一种通过多层近邻图进行快速向量搜索的索引算法。 它在向量可以放进内存时速度很快,因此被pgvector、OpenSearch以及大量向量数据库采用,但它并不天然适合对象存储上的百亿级数据。
问题在于,HNSW搜索需要沿图不断跳转,而每一步都可能变成一次小型随机读取。随机内存访问尚可接受,放到S3一类高延迟对象存储上就会非常昂贵;如果为了速度把整个图放进内存,容量成本又会快速膨胀。
按照AWS给出的OpenSearch HNSW估算公式,每条向量的内存需求约为1.1 ×(4 × 维度 + 8 × m)字节。对于2.47亿条1024维向量、m=16的测试表,仅索引就需要约1.15TB内存;扩展到100亿条向量,理论需求接近46TB。这不是HNSW不能扩展,而是它在湖仓规模上的经济性很难成立。(onehouse.ai)
Lakegres因此采用了聚类加量化的路线。构建索引时,系统先用K-means把向量划分到多个聚类中,再通过RaBitQ进行压缩编码。RaBitQ是一种面向相似度搜索的随机比特量化方法,Lakegres支持每维1至8比特,默认使用4比特,同时支持L2距离、余弦相似度和点积。
每个聚类又被拆成若干Posting Segment,单个Posting Block大约包含1000至4000个向量条目,目标大小约512KB。对对象存储来说,连续读取一个数百KB的数据块,远比沿HNSW图执行大量细碎随机读取更友好。(onehouse.ai)
一次查询如何跑完
近似最近邻搜索是通过缩小候选范围,以较低计算成本找到高概率相似结果的方法。 Lakegres收到查询向量后,不会扫描全部数据,而是先计算查询向量与聚类中心的距离,只打开最近的一批聚类。
参数nprobes决定一次查询需要探测多少个聚类。数值越大,系统读取的数据越多,召回率通常越高;数值越小,查询更快,但可能遗漏真实近邻。这与IVF类索引的基本权衡一致。
进入聚类后,Lakegres首先使用一比特估计值和误差边界排除不可能进入Top K的向量,然后再读取额外比特,对剩余候选进行更精细的评分。只有候选集合足够小时,系统才需要解析记录键和具体行位置。
如果应用要求更高精度,还可以启用精确重排。精确重排会从同一个表快照中读取候选项的完整向量,重新计算真实距离,但仍然不需要扫描未被选中的聚类。在Onehouse另一组十亿向量测试中,加入精确重排后达到0.96的Recall@10。(onehouse.ai)
这一设计对RAG尤其重要,因为RAG检索往往不仅需要语义相似度,还需要同时拿到文档内容、文件路径、时间、租户、权限和业务对象字段。向量与业务数据在同一张表中,意味着检索结果可以继续参与SQL连接和聚合,而不必先从向量库拿ID,再回业务数据库补齐上下文。
更新一致性比延迟更重要
快照一致性是查询在固定数据版本上读取基础数据和索引的能力。 对企业RAG来说,一个60毫秒但返回已删除文档的检索系统,通常不如一个100毫秒但版本正确的系统可靠。
Lakegres在每次查询前解析表快照和当前可用的索引Generation。插入、更新或删除数据时,写入任务会同步追加索引变更:向量更新会把旧索引项标记为删除,再写入新索引项;记录位置变化也会更新定位信息;后台Compaction则定期将小型增量合并进较大的Posting Block。
查询执行前,系统还会检查索引是否覆盖目标快照需要的提交。如果索引已经过期或版本不兼容,可以直接报错,或根据配置退回全表精确扫描,而不是悄悄返回旧结果。
重建索引也不要求暂停查询。新Generation会在旧索引旁边构建,并追赶构建期间发生的新提交;完成后通过一次原子元数据提交切换版本,因此正在执行的请求不会读到只构建了一半的索引。(onehouse.ai)
247M向量跑到63.5毫秒
Recall@10是前10条检索结果中命中真实近邻的比例指标。 Onehouse使用Cohere公开的多语言Wikipedia Embedding数据集进行测试,共包含247,154,006个段落向量,每条向量1024维,由Cohere Embed v3生成,表在S3上约占1TB。
| 指标 | Lakegres | Databricks AI Search | |---|---:|---:| | 热查询P50 | 63.5 ms | 655 ms | | 热查询P90 | 67.9 ms | 876 ms | | 热查询P99 | 75.3 ms | 1209 ms | | 冷查询P50 | 536.2 ms | 8242 ms | | Recall@10 | 0.950 | 0.952 | | 索引构建时间 | 18分钟 | 约3小时10分钟 |
这组结果里,Lakegres热查询中位延迟约快10倍,冷查询中位延迟约快15倍,召回率则基本相当。Lakegres使用5台m8gd.4xlarge执行节点和1台r8gd.4xlarge驱动节点,AWS按需实例价格约为每小时5.79美元,不包含Onehouse软件费用;Databricks使用6个Storage-Optimized Unit和1个副本,官方标价约为每小时7.68美元。(onehouse.ai)
不过,这并不是严格的总体拥有成本对比。Databricks公布的是服务端延迟,Lakegres采用客户端psql计时,两者覆盖的请求路径并不完全相同;Databricks底层硬件对用户不可见,Lakegres集群则由用户选择规格。因此,这组数据足以证明Lakegres方案具备竞争力,但还不足以宣布它在所有向量检索负载上都领先10倍。
它还不是向量数据库终结者
Lakegres当前更像湖仓检索层,而不是通用向量数据库的完全替代品。 它最有价值的场景,是数据已经以Hudi或Iceberg形式存在、规模达到数亿至数十亿条,并且团队希望统一分析查询、元数据过滤和语义搜索。
当前版本仍有三个明显限制。
- 向量检索和全文检索仍处于Preview阶段,成熟度不能与已经运行多年的专用搜索系统等同。
- 首个版本主要通过分区裁剪处理过滤条件,尚不支持任意SQL谓词与最近邻搜索的完整组合。
- 每次查询仍有约20至25毫秒耗费在Spark规划和任务调度上,而不是索引读取本身。
第三点尤其关键。Lakegres已经把对象存储上的向量候选搜索压缩到数十毫秒,但其查询引擎仍继承了湖仓计算框架面向大扫描任务的调度开销。Onehouse表示已经设计新的索引查询路径来移除这部分固定成本,但目前仍属于后续计划。(onehouse.ai)
对几十万到几千万条向量、要求个位数毫秒延迟的在线推荐或搜索应用,内存型HNSW、专用向量数据库或OpenSearch仍可能更合适。对已经使用Postgres且数据规模可控的团队,pgvector也依然是更简单的选择。
真正的价值是缩短数据链路
Lakegres的核心价值不是创造一种新的向量算法,而是让开放湖仓表同时成为RAG的事实来源和检索来源。 企业不再必须为语义搜索维护一套独立数据副本,Embedding、原文、权限字段和业务事实可以在同一个快照中被查询。
这会直接减少四类工程成本:第一,减少从湖仓到向量库的全量与增量同步;第二,降低Embedding模型升级时的双系统重建难度;第三,让删除和更新更容易满足一致性要求;第四,让检索结果能够直接连接结构化业务数据。
例如,一个售后Agent可以先按向量相似度找到故障描述,再连接同一湖仓中的产品批次、维修记录和召回状态;一个投研Agent可以检索公告段落,同时关联公司、行业和财务指标;一个训练数据流水线可以直接做语义去重和样本筛选,而不必把数十亿训练样本装进常驻内存的向量集群。
我的判断是,Lakegres不会让专用向量数据库消失,但它会迫使行业重新回答一个问题:如果数据、Embedding和业务元数据本来就在开放表里,为什么语义检索一定要再造一份副本?
对于湖仓规模RAG,少一次数据搬运往往比单次查询再快10毫秒更重要。延迟可以通过缓存和扩容继续优化,但跨系统的数据漂移、权限不一致和失败重试,通常才是生产RAG最难处理的部分。
参考来源
- Apache Hudi RFC-109:原生向量检索设计:描述向量索引的存储布局、查询路径和一致性模型。
- Apache Hudi向量索引实现PR:包含索引Bootstrap与Spark检索实现进展。
- Apache Hudi向量索引功能讨论:说明在Hudi元数据表中维护向量索引的目标和应用场景。
- Apache XTable跨格式二级索引PR:展示Hudi索引如何服务Iceberg等来源表。
- Cohere多语言Wikipedia向量数据集:Lakegres性能测试使用的公开数据集。