DaisyRose-27B:后训练提速2倍
RadixArk用1200个长时程任务和18天强化学习,让Qwen3.8-27B的智能体能力显著提升。真正值得关注的不是跑分,而是其将后训练成本降低57%的工程方案。
DaisyRose-27B:后训练提速2倍
2026年11月18日,RadixArk发布首款模型DaisyRose-27B:它以Qwen3.8-27B为底座,不做监督微调,也不依赖模型蒸馏,仅通过强化学习完成后训练,在144张H200上运行18天,最终把Terminal-Bench 4.1的pass@1成绩从5.6%提高到12.0%。
DaisyRose-27B是一个面向长时程智能体任务的270亿参数多模态推理模型。它保留了底座模型的架构、分词器、对话模板、图像理解能力和256K上下文窗口,因此可以直接替换现有推理栈中的Qwen3.8-27B,而不需要重新适配提示词格式或工具调用协议。(huggingface.co)
但这次发布最值得关注的,不是又多了一个27B模型,而是RadixArk展示了一套更便宜、更快,也更接近生产环境的智能体后训练方案:只用约1200个精心设计的任务,完成约6.3万GPU小时的训练,并将端到端吞吐提高到开源对照方案的约2倍。
重点不是参数,而是后训练怎么做
后训练是指基础模型预训练完成后,通过监督微调、强化学习、蒸馏或偏好优化等方法,使模型获得特定行为和任务能力的训练阶段。对于智能体模型来说,后训练尤其困难,因为训练样本不再是一个问题对应一个答案,而可能是一段持续几十分钟、调用上百次工具、不断失败和重试的完整工作过程。
DaisyRose-27B选择了一条相当克制的路线:不改Qwen3.8-27B的网络结构,不引入额外蒸馏模型,也不堆数十万条指令数据,而是集中处理底座模型真正容易犯错的复杂任务。
RadixArk与Eigent AI先从机器学习、软件工程和科学计算等领域构建了数千个候选任务,最后只有约1200个进入训练集。每个任务都需要满足三个条件:
- 底座模型确实会失败。 团队先让Qwen3.8-27B执行任务,再围绕其具体错误重新设计问题,而不是收集模型本来就能解决的样本。
- 任务必须包含相互依赖的多个步骤。 单次尝试最长运行1.5小时,可能产生超过100次工具调用和超过256K输出Token。
- 奖励必须对应真正完成任务。 如果模型能够绕过核心问题、利用评测漏洞或靠表面答案获得分数,该任务会被修正或移除。
长时程智能体任务是指模型必须在较长时间内持续规划、执行、读取反馈并修正策略的任务。它与传统问答最大的区别是,早期一个看似无关紧要的操作错误,可能在几十步后导致整个任务失败。
这种数据策略的价值在于提高了每条训练轨迹的“含金量”。1200个任务听起来不多,但如果每个任务都包含数十万Token、上百次工具交互和明确可验证的结果,其训练密度远高于普通的短问答数据。(huggingface.co)
Terminal-Bench得分翻倍,但它还不是榜首
DaisyRose-27B在RadixArk公布的七项评测中全部超过Qwen3.8-27B,其中最大增幅出现在更强调终端操作和长链路执行的Terminal-Bench 4.1。
| 基准测试 | Qwen3.8-27B | DaisyRose-27B | 变化 | |---|---:|---:|---:| | Terminal-Bench 4.1 | 5.6 | 12.0 | +6.4,约提升114% | | Terminal-Bench 2.1 | 73.0 | 75.5 | +2.5 | | DeepSWE v1.1 | 42.2 | 46.2 | +4.0 | | SWE-Bench Pro v2 | 91.3 | 94.7 | +3.4 | | HLE文本版 | 33.9 | 34.3 | +0.4 | | IFBench | 79.5 | 82.4 | +2.9 | | GPQA Diamond | 89.2 | 90.7 | +1.5 |
这组结果说明,强化学习主要强化了模型的智能体执行和软件工程能力,而不是让所有知识、推理指标同步跃升。Terminal-Bench 4.1提高114%,但HLE只增加0.4分,符合训练数据以长时程任务为核心的预期。(huggingface.co)
DaisyRose-27B并不是当前所有评测中的最强模型。按照官方模型卡列出的成绩,Terminal-Bench 4.1上,MiMo V2.6 Flash为16.1,GPT-6 Luna为15.2,均高于DaisyRose-27B的12.0;DeepSWE v1.1上,DaisyRose-27B的46.2也与头部模型存在明显差距。
不过,直接把这些分数排成一张总榜并不严谨。不同模型使用的智能体框架、推理预算、重复次数和评测版本并不完全一致,部分数字还是由各开发者自行报告。DaisyRose-27B更可靠的对照,是使用相近设置测试的底座Qwen3.8-27B,而不是配置不同的闭源模型。
换句话说,DaisyRose-27B的价值不是证明27B已经打赢前沿闭源模型,而是证明在不扩充参数、不蒸馏大模型的情况下,高质量强化学习仍能让同一个27B底座跨越一个清晰的能力档位。
训练效率为什么能提高2倍
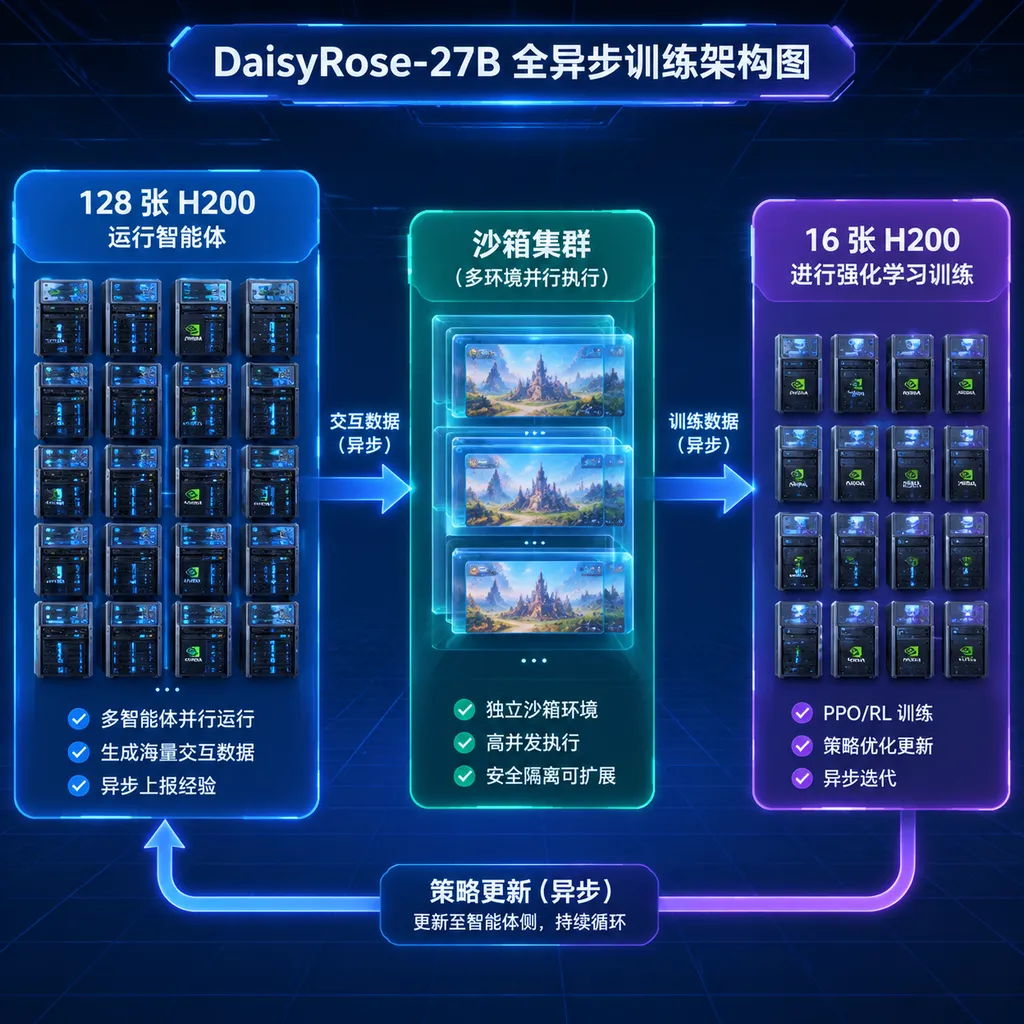
全异步强化学习是一种将模型生成训练轨迹与参数更新解耦的训练方式。在同步流程中,训练器往往需要等待最慢的一批智能体完成任务,而智能体又可能等待新权重下发;全异步方案则让两条流水线持续工作,减少GPU空转。
DaisyRose-27B训练时,128张H200负责运行智能体任务和生成轨迹,另外16张H200负责从已完成的轨迹中学习。每完成一个训练步骤,新权重就会被发送到负责推理的128张GPU,智能体不需要等待整个批次统一结束。
这套流程由RadixArk开源的Miles强化学习框架驱动。Miles将SGLang用于高吞吐推理,将Megatron用于分布式训练,并针对权重更新、低精度训练、故障恢复和长时程智能体轨迹进行了工程优化。(github.com)
MFU是模型浮点运算利用率,用来衡量GPU峰值算力中真正用于模型训练计算的比例。DaisyRose-27B的内部训练后端实现了37%的MFU,而基于Megatron的开源对照训练器只有16%。根据RadixArk的计算,完成相同训练所需的GPU时间因此减少57%。
端到端吞吐的差异更直观:
| 训练方案 | 144张H200总吞吐 | 相对速度 | |---|---:|---:| | RadixArk内部后端 | 约16,800 Token/秒 | 2.02倍 | | 开源对照训练器 | 约8,300 Token/秒 | 1倍 |
端到端吞吐包含了智能体实际执行任务、等待工具返回和生成长轨迹所花费的时间,因此比单纯测试模型前向计算更接近真实训练成本。整个发布训练持续18天,总计约6.3万GPU小时,期间速度和效率没有随着任务积压明显下降。(huggingface.co)
这也是DaisyRose-27B比单次跑分更重要的地方。当前智能体强化学习最大的门槛,往往不是算法公式,而是GPU在等待沙箱、权重同步和长尾任务时被大量浪费。如果训练基础设施只能跑出十几个百分点的有效利用率,再好的数据和奖励设计也很难经济地扩展。
1M Token训练轨迹是怎么装进去的
Harness summarization是一种由智能体运行框架定期压缩历史状态、再继续执行任务的上下文管理方法。它不是简单扩大模型窗口,而是将已经发生的操作、文件变化、错误信息和阶段性结论整理成摘要,使一次超长任务能够被拆成多段连续轨迹。
DaisyRose-27B保留的原生上下文长度是262,144 Token,但训练会话最长达到100万Token。RadixArk通过Harness summarization将这些超长会话折叠为多条相互关联的轨迹,再交给训练器学习。
这种方法解决了智能体训练中的一个现实矛盾:任务可能持续一小时,但模型不可能把终端输出、源代码、日志和每次工具调用永久塞在同一个上下文窗口里。摘要机制相当于给智能体维护一份动态工作笔记,让它忘掉大量低价值细节,同时保留后续决策需要的状态。
它也带来了新的风险。摘要如果遗漏关键错误、错误归因或覆盖原始证据,后续轨迹可能在错误状态上继续执行。DaisyRose-27B在Terminal-Bench上的提升说明这套机制至少能够工作,但它是否能迁移到浏览器操作、企业软件和更开放的真实环境,还需要社区复现。
沙箱才是智能体强化学习的隐形成本
智能体沙箱是一个隔离的临时运行环境,模型可以在其中执行命令、修改文件和安装依赖,而不会影响宿主系统。每次训练尝试都需要创建干净环境、运行任务、保存结果并完成自动评分,这使沙箱调度成为大规模智能体训练的核心基础设施。
DaisyRose-27B项目从9月中旬到11月中旬运行了约94.4万个沙箱,最高同时运行1566个。服务最初只有一台机器,随后扩展到最多12台,并在训练期间完成了10次升级。
RadixArk称,九周内沙箱创建成功率为99%,10月下旬以后超过99.95%,基础设施成本比使用主流云沙箱服务低约80%。其关键优化之一,是根据实际使用量动态调整每个沙箱的内存,让更多环境共享同一台机器,而不是为每个任务静态预留峰值资源。
该服务基于开源项目AgentENV构建。AgentENV是一个用于批量调度和运行智能体环境的分布式平台,负责处理环境生命周期、并发任务和执行隔离等问题。(huggingface.co)
27B仍然是一个务实的模型尺寸
DaisyRose-27B共有278亿参数,其中包括4.6亿参数的视觉编码器和4.2亿参数的多Token预测头。模型包含64层解码器,以3:1比例混合Gated DeltaNet线性注意力层和全注意力层,隐藏维度为5120,并保留27层视觉编码器。
这意味着它不是通过MoE只激活少量参数,而是一个每次推理都使用约27B参数的稠密模型。其优势是部署路径和性能表现相对稳定,代价则是显存需求高于活跃参数更少的MoE模型。
| 权重格式 | 权重体积 | 典型部署要求 | |---|---:|---| | BF16 | 约52GB | 适合H200、B200、GB300等数据中心GPU | | FP8 | 约29GB | 适合支持FP8的单卡或工作站级GPU | | NVFP4 | 约23GB | 需要Blackwell架构GPU |
RadixArk已经以Apache 2.0协议发布BF16、FP8和NVFP4权重。官方列出的可运行硬件从H200、B200和GB300延伸到RTX PRO 6000、RTX 5090和DGX Spark,推荐使用SGLang配合DSpark推测解码部署。(huggingface.co)
DSpark推测解码是一种让较小草稿模型提前生成候选Token,再由主模型批量验证的推理加速方法。它不会直接降低主模型参数量,而是减少主模型逐Token串行生成带来的等待时间,更适合DaisyRose-27B这类可能输出数万Token思考过程的模型。
不过,27B仍然不是普通消费级设备上的轻量方案。23GB只是NVFP4权重本身,实际运行还需要为KV Cache、激活值、视觉输入和长上下文预留显存。256K上下文并不意味着在24GB显卡上可以无条件跑满256K,开发者仍需根据并发量、输入长度和缓存精度做取舍。
DaisyRose-27B真正验证了什么
DaisyRose-27B验证的不是“少量数据一定胜过大量数据”,而是经过失败分析和难度控制的数据,可能比盲目扩大任务数量更有效。它的1200个任务不是从互联网随机采样,而是围绕底座模型的具体错误反复修改,并通过真实沙箱结果检查奖励是否可靠。
DaisyRose-27B也验证了后训练的竞争正在从算法扩展到系统工程。未来团队之间的差距,可能不只来自用了GRPO还是PPO,还来自谁能更快地生成轨迹、稳定运行百万级沙箱、在几秒内更新推理节点权重,以及让GPU少等待几十个百分点。
从产品角度看,DaisyRose-27B更适合代码智能体、机器学习实验助手、终端自动化和可验证的科学计算任务,而不是被简单理解为一个新的通用聊天模型。它在HLE等通用知识评测上的增幅有限,却在Terminal-Bench 4.1上实现翻倍,已经清楚体现了能力取向。
这款模型目前最大的悬念是社区复现。官方成绩大量使用内部配置、摘要机制和特定智能体Harness,模型权重开源并不等于评测流程天然可复制。开发者接下来需要验证的,是DaisyRose-27B离开RadixArk的基础设施后,在不同沙箱、工具协议和真实代码仓库中还能保留多少增益。
但至少在今天,DaisyRose-27B给出了一个比“继续扩大参数”更有现实意义的方向:把基础模型当作原材料,通过高质量任务、异步强化学习和可靠执行环境,将有限GPU真正转化成可用的智能体能力。
参考来源
- DaisyRose-27B官方发布文章:包含训练流程、效率数据、沙箱规模及主要基准测试结果。
- DaisyRose-27B模型卡:包含模型架构、硬件要求、评测设置、权重格式和许可证信息。
- DaisyRose-27B FP8权重:适用于支持FP8的推理硬件和部署环境。
- DaisyRose-27B NVFP4权重:面向Blackwell GPU的低精度权重版本。
- Miles开源仓库:RadixArk用于大规模LLM与VLM强化学习后训练的框架。
- AgentENV开源仓库:DaisyRose-27B沙箱服务所基于的分布式智能体环境平台。
- SGLang开源仓库:官方推荐的DaisyRose-27B高性能推理框架。