微调为何总比FLOPs估算更久
Dharma-AI 分析 272 次真实 SFT 任务发现,传统 FLOPs 公式的平均误差超过 12 小时。可靠的训练排期,必须把评估、检查点、数据处理和集群争用纳入端到端模型。
FLOPs 算出 9 小时,为什么训练第二天还没结束?
传统 FLOPs 公式并没有算错,它只是算漏了大半个训练系统。 11 月 18 日,Dharma-AI 在 Hugging Face 发布了一项针对真实生产任务的研究预览:团队收集了 272 次监督微调任务,覆盖约 7382 GPU 小时,并比较了 FLOPs 公式、分析型性能模型和机器学习回归模型对训练时长的预测能力。结果相当直接——常见 FLOPs 估算的平均绝对误差为 12.41 小时,而加入评估、检查点和任务配置特征的 CatBoost 模型,将误差压到了 1.71 小时。(huggingface.co)
这项研究讨论的不是怎样让单个训练 Step 更快,而是怎样在任务启动前判断 GPU 什么时候能够释放。 对共享 GPU 集群而言,这个问题比单纯计算吞吐更实际:一个任务晚结束 6 小时,影响的通常不只是该实验,还包括后续排队任务、模型验收窗口和交付日期。
先分清 FLOPs、FLOPS 和 MFU
FLOPs 是完成一次计算任务所需的浮点运算总量。 这里的小写 s 表示 operations,不是每秒速度;模型越大、Token 越多,需要执行的 FLOPs 通常越高。
FLOPS 是硬件每秒能够执行的浮点运算次数。 GPU 参数页上的 TFLOPS 或 PFLOPS 是一种峰值吞吐指标,但训练任务几乎不可能持续跑满理论峰值。
MFU 是模型实际浮点计算量与 GPU 理论峰值计算能力之比。 MFU 全称 Model FLOPs Utilization,它试图回答一个关键问题:标称算力中,究竟有多少真正用于模型前向传播和反向传播。
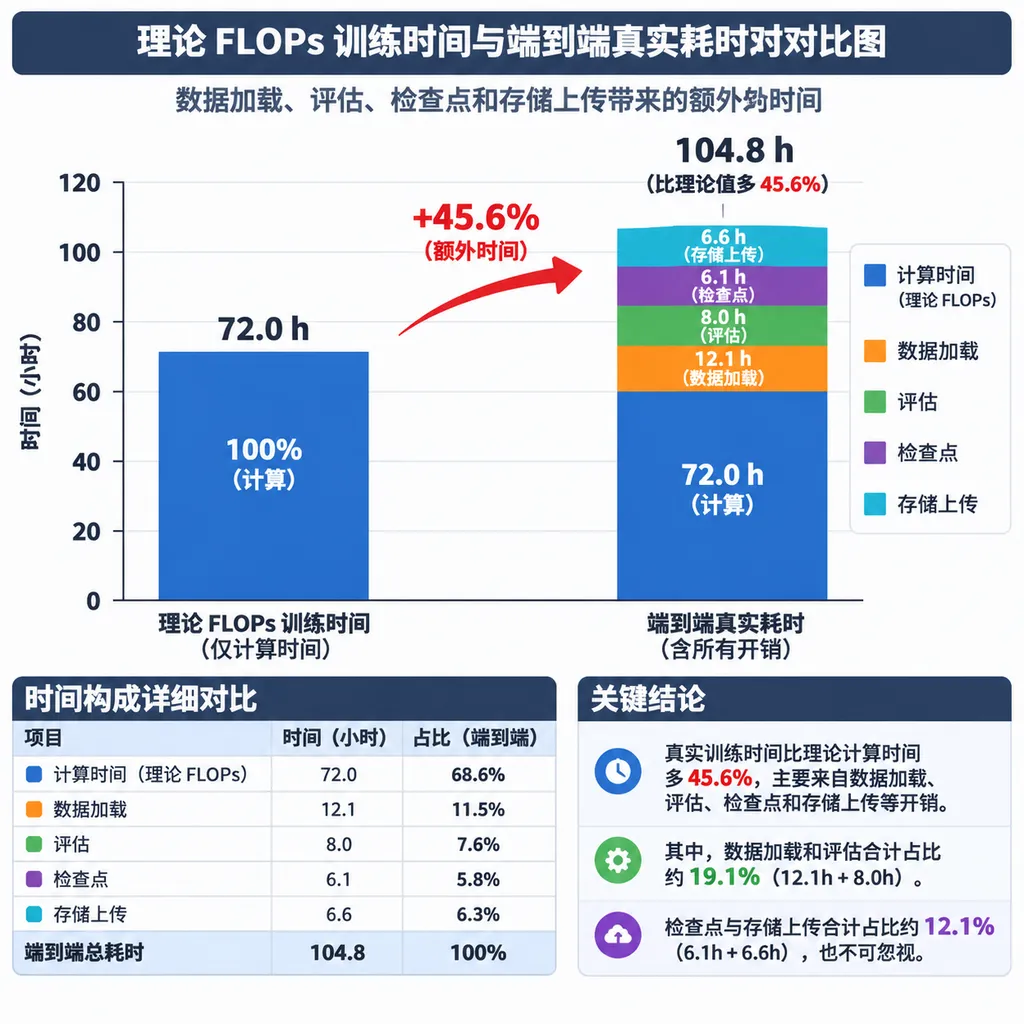
端到端训练时间是从任务获得 GPU 到最终产物写入存储的墙钟时间。 墙钟时间不仅包含矩阵乘法,还包含环境启动、模型加载、数据预处理、评估、检查点保存、跨卡通信、日志记录和最终上传。
对于稠密 Transformer,一个常用的粗略训练计算量公式是:
训练 FLOPs ≈ 6 × P × D
其中,P 是模型参数量,D 是训练 Token 总数。进一步除以 GPU 数量、单卡峰值算力和 MFU,可以得到理论训练时间:
T_compute = 6 × P × D ÷(GPU 数量 × 单卡峰值 FLOPS × MFU)
这个公式给出的更接近训练计算循环时间,而不是整个任务的完成时间。 Dharma-AI 的实验已经把计划中的评估 Token 纳入 FLOPs 基线,并在 25% 至 65% 的 MFU 区间内进行了搜索,但最优结果仍然只有 R²=0.31,平均绝对误差达到 12.41 小时。(huggingface.co)
272 次生产任务暴露了多大的估算偏差
Dharma-AI 的数据集来自共享 H200 集群,而不是干净的单机基准测试。 这些任务使用 1、2 或 4 张 GPU,运行在拥有 8 至 32 张 H200、横跨 1 至 4 个节点的资源池中,并与其他训练和推理工作负载共享网络和存储。
样本覆盖了 LoRA 和全参数微调,但模型规模最高只有 150 亿参数。 272 次 SFT 的持续时间从 1.6 小时到 172.4 小时不等,平均值为 23.43 小时,中位数为 15.29 小时;训练栈主要包括 Hugging Face Transformers 和 Unsloth。(huggingface.co)
| 估算方法 | R² | RMSE | MAE | 适合解决的问题 | |---|---:|---:|---:|---| | FLOPs 基线,MFU 30% | 0.31 | 20.45 小时 | 12.41 小时 | 计算量级和理论下限 | | FLOPs 基线,MFU 45% | 0.18 | 22.38 小时 | 13.01 小时 | 乐观算力预算 | | Calculon | -0.51 | 30.40 小时 | 20.36 小时 | Step 级计算、显存和通信分析 | | 线性回归 | 0.69 | 13.52 小时 | 7.52 小时 | 简单经验校正 | | Ridge | 0.73 | 12.72 小时 | 7.23 小时 | 有共线性时的线性估算 | | XGBoost | 0.97 | 4.18 小时 | 1.95 小时 | 非线性端到端预测 | | CatBoost | 0.98 | 3.52 小时 | 1.71 小时 | 带大量类别配置的排期预测 |
更复杂的硬件分析模型也不等于端到端排期模型。 Calculon 会显式描述 Transformer 层、显存流量和设备间通信,Dharma-AI 还扩展了其公开实现,使其支持 LoRA、GQA、融合注意力、BF16 和 SwiGLU;但 Calculon 预测的中位时长只有真实墙钟时间的 11%。这不是 Calculon 失效,而是它原本解决的就是 Step 级性能建模,而不是生产任务生命周期建模。(huggingface.co)
真正吞掉训练排期的六类时间
第一类遗漏是任务启动和数据准备时间。 容器调度、环境初始化、模型权重下载、分片加载、Tokenizer 启动和数据集 Tokenization 都发生在第一个优化 Step 之前;对于短任务,这些固定成本甚至可能比训练循环本身更显眼。
第二类遗漏是周期性评估时间。 eval_strategy、eval_steps、验证集规模和评估 Batch Size 会共同决定训练期间模型需要额外跑多少次前向传播。Hugging Face Transformers 允许按固定 Step 或 Epoch 运行评估,因此两份训练 Token 数相同的配置,只要评估频率不同,墙钟时间就可能明显分叉。(github.com)
第三类遗漏是检查点保存和上传时间。 save_strategy 和 save_steps 决定保存频率,而保存内容可能包括模型权重、优化器状态、学习率调度器状态和随机数状态。save_only_model=True 可以显著缩小检查点,但代价是无法完整恢复训练;如果每 100 Step 保存一次,慢速共享存储很容易把理论吞吐优势吃掉。(github.com)
第四类遗漏是内存、网络和跨卡通信等待。 多卡训练需要执行梯度同步、参数分片交换或张量并行通信,GPU 可能在等待网络数据,而不是持续执行矩阵乘法。增加 GPU 只有在通信能够与计算有效重叠时,才可能接近线性加速。
第五类遗漏是共享基础设施的争用。 同一个任务在空闲集群和繁忙集群中的 FLOPs 完全相同,但对象存储带宽、节点网络、模型下载服务和共享文件系统的可用吞吐可能完全不同。
第六类遗漏是任务结束阶段。 最终模型合并、权重序列化、文件校验、上传对象存储和清理临时文件都发生在训练进度条达到 100% 之后,但排期系统必须等这些步骤完成后才能把 GPU 和任务状态视为真正释放。
评估频率比很多人想象得更贵
评估总量是这项研究中最重要的预测特征。 CatBoost 的特征重要性显示,整个任务生命周期内处理的评估样本总量 num_eval_data 排名第一,随后才是可训练参数量、评估 Batch 占比、模型总参数量和每张 GPU 的训练负载;检查点需要保存的参数总量同样位居前列。(huggingface.co)
评估成本不能只用验证集大小表示。 一个更实用的估算方式是:
评估总样本数 = 单次评估样本数 × 评估次数
如果训练共 6000 Step,每 100 Step 评估一次,就会执行约 60 轮评估;把间隔改为 500 Step 后,评估次数降到约 12 轮。即使单次评估只耗时 8 分钟,前一种配置也会额外占用约 8 小时,后一种配置则约为 1.6 小时。
高频评估不是错误,但它应该被视为一种有成本的实验设计。 在调试阶段,高频评估有助于及时发现发散和过拟合;在参数基本稳定的正式训练阶段,机械地沿用调试配置,通常只是在用昂贵 GPU 购买更多相似的中间指标。
从一个公式升级成三层排期模型
可靠排期应该同时给出理论下限、配置开销和经验修正。 不要试图寻找一个“万能 MFU”把所有误差塞回 FLOPs 公式,而应该把排期拆成三层。
第一层:计算下限
计算下限用于判断任务的基本量级。 可以继续使用 6PD 公式,或者使用实测单 Step 时间乘以总 Step 数,但结果应明确标注为 T_compute,而不是直接称为“任务完成时间”。
第二层:显式生命周期预算
生命周期预算把可从配置文件直接推导的开销逐项加入。 一个适合工程排期的简化表达式是:
T_total ≈ T_setup + T_train + N_eval × T_eval + N_save × T_save + T_finalize + T_contention
其中:
T_setup:容器启动、模型下载、权重加载和数据预处理;T_train:训练循环,包括前向、反向、优化器更新和通信;N_eval × T_eval:评估次数乘以单次评估时长;N_save × T_save:检查点数量乘以单次保存时长;T_finalize:最终权重保存、合并和上传;T_contention:共享网络、存储和节点资源争用带来的尾部延迟。
这些时间不一定完全串行,因此公式更适合做保守预算而不是物理定律。 如果上传和计算能够异步重叠,应只计入真正阻塞关键路径的部分;如果所有任务都向同一个共享存储同步写入,则应使用高峰期数据,而不是午夜空闲时的最佳成绩。
第三层:历史任务校准
历史校准用于学习那些很难手工写成公式的非线性关系。 Dharma-AI 使用了 24 个特征,其中所有输入都能在任务调度前获得,包括模型标识、参数量、训练 Token、可训练参数量、GPU 数量、训练和评估 Batch、评估次数、检查点次数、保存参数量以及微调方式。
团队不必一开始就训练 CatBoost。 如果历史样本不足 100 条,可以先按模型家族、GPU 类型和微调方式分组,分别统计以下指标:
- 计算公式误差的中位数;
- 启动时间的 P50 和 P90;
- 单次评估时长;
- 单次检查点时长;
- 每小时有效训练 Token;
- 真实时长与计算时长的比值;
- 不同时段和集群负载下的争用系数。
小团队最实用的模型往往是“分组系数加分位数缓冲”。 例如,同类 LoRA 任务过去的 T_actual ÷ T_compute 中位数为 1.45,P90 为 1.8,那么内部实验可按 1.45 排期,对外承诺或流水线超时则按 1.8 设置。
一个更接近现实的排期示例
下面的示例说明了为什么 9 小时的 FLOPs 估算会变成 16 小时任务。 假设某次微调的理论训练循环为 9 小时,另有 30 分钟环境和模型加载时间;训练期间评估 12 次,每次 15 分钟;保存 6 个检查点,每次 18 分钟;最终模型合并与上传需要 42 分钟;共享存储争用预计增加 1.3 小时。
| 时间项目 | 估算时长 | |---|---:| | FLOPs 训练循环 | 9.0 小时 | | 启动与加载 | 0.5 小时 | | 12 次评估 | 3.0 小时 | | 6 次检查点保存 | 1.8 小时 | | 最终合并与上传 | 0.7 小时 | | 集群争用缓冲 | 1.3 小时 | | 端到端排期 | 16.3 小时 |
这个示例中,FLOPs 公式没有低估任何一次矩阵乘法,却把总时长低估了 7.3 小时。 更重要的是,其中大部分差异来自配置选择,而不是 GPU 性能:降低评估频率、减少冗余检查点或改善存储路径,可能比更换一张理论算力更高的 GPU 更有效。
多加 GPU,为什么排期不一定按比例缩短
GPU 数量增加并不保证端到端时间按反比例下降。 四张卡把计算循环从 8 小时缩短到 3 小时之后,启动、Tokenization、评估、检查点和最终上传并不会自动缩短到原来的四分之一。
短任务尤其容易受到固定开销支配。 如果环境初始化和模型加载共需 30 分钟,那么一个理论训练时间为 1 小时的任务至少有三分之一时间不在执行训练;即使把训练计算加速一倍,端到端时长也只会从 90 分钟降到约 60 分钟,而不是 45 分钟。
Dharma-AI 数据中 GPU 数量与预测时长呈正相关也不能解读成“GPU 越多越慢”。 原因是更大的任务通常会申请更多 GPU,GPU 数量在该数据集中同时充当了任务规模的代理变量,这正是相关性不能直接等同因果关系的典型案例。(huggingface.co)
怎么把这套方法落到自己的训练平台
第一步是把任务日志从“成功或失败”升级为结构化运行记录。 每次任务至少应记录提交配置、GPU 型号和数量、模型参数量、可训练参数量、训练及评估样本数、Token 数、启动时间、首个 Step 时间、每次评估时长、每次保存时长和最终结束时间。
第二步是统一端到端时间的起止口径。 建议从任务真正获得 GPU 开始计时,到最终模型完成保存并返回成功状态结束;排队等待时间应单独记录,否则调度能力、资源供给和训练性能会被混在一个指标里。
第三步是为不同用途输出不同分位数。 研究人员需要 P50 判断大致多久能看到结果,调度器需要 P80 或 P90 避免任务碰撞,交付计划则可能需要 P95 作为超时和资源预留依据。
第四步是先做小规模校准任务。 当模型、数据管线或 GPU 型号第一次出现时,可以先运行 1% 至 5% 数据,测量稳定后的 Step 时间、评估时间和保存时间,再推算完整任务;这种方式仍不是完美预测,但通常比直接套用某个行业平均 MFU 更可靠。
第五步是把评估和保存策略当成预算参数。 Hugging Face Transformers 已经把 eval_strategy、eval_steps、save_strategy、save_steps 和 save_only_model 暴露为明确配置项,训练平台完全可以在任务提交前计算预计评估次数、保存次数和数据写入量。(github.com)
这项研究值得学什么,又不能照搬什么
最值得复制的不是 CatBoost 模型,而是“把训练排期视为监督学习问题”的思路。 FLOPs 仍然是很好的物理先验,但它应该只是特征之一;真正决定排期准确度的,是能否把配置、数据、存储和集群状态转化为可追踪特征。
这组结果不能直接迁移到所有训练集群。 当前数据仅包含 SFT,GPU 全部为 H200,模型规模不超过 15B,而且 60 小时以上的任务只有 13 次;研究没有覆盖 DPO、RLHF、RLVR、混合 GPU 池和更大规模的跨节点并行。对于 60 至 175 小时任务,CatBoost 的中位绝对误差扩大到 5.19 小时,P90 误差达到 18.51 小时。(huggingface.co)
研究目前还是论文预览,而不是已经完成同行评审的通用结论。 不过它用生产日志量化了一个长期存在的工程常识:模型训练不是一道只由参数量、Token 数和显卡峰值算力决定的除法题。
最后的判断
FLOPs 适合回答“至少要算多久”,但不适合单独回答“任务几点结束”。 如果目标只是比较模型规模或 GPU 理论计算能力,6PD 和 MFU 仍然足够有用;如果目标是安排共享集群、控制成本或承诺交付时间,就必须估算完整训练生命周期。
真正可靠的排期公式应该是“物理下限加配置开销,再用历史数据校准”。 当团队开始记录评估量、检查点写入量、启动时间和共享基础设施争用后,微调耗时就不再是一个不断延期的黑盒,而会变成可以预测、可以解释,也可以优化的工程指标。
参考来源
- Dharma-AI:Why your fine-tuning job takes longer than the FLOPs say——本文核心研究来源,包含 272 次 H200 微调任务、预测模型和误差数据。
- Hugging Face Transformers:TrainingArguments——评估频率、检查点策略、保存内容和训练配置的官方实现说明。
- Hugging Face Transformers:Training Guide——Trainer 训练、评估、保存和显存优化配置的官方文档。
- Calculon——面向大语言模型训练的计算、显存与通信性能分析工具。