OCR千页成本跌破0.1美元
Hugging Face 对8款OCR模型的850页实测显示,千页识别成本已从0.51美元降至0.1美元以下。但低推理费不等于低数字化总成本,中文古籍也仍需单独验证。
8款模型实测,OCR推理成本一年半下降超80%
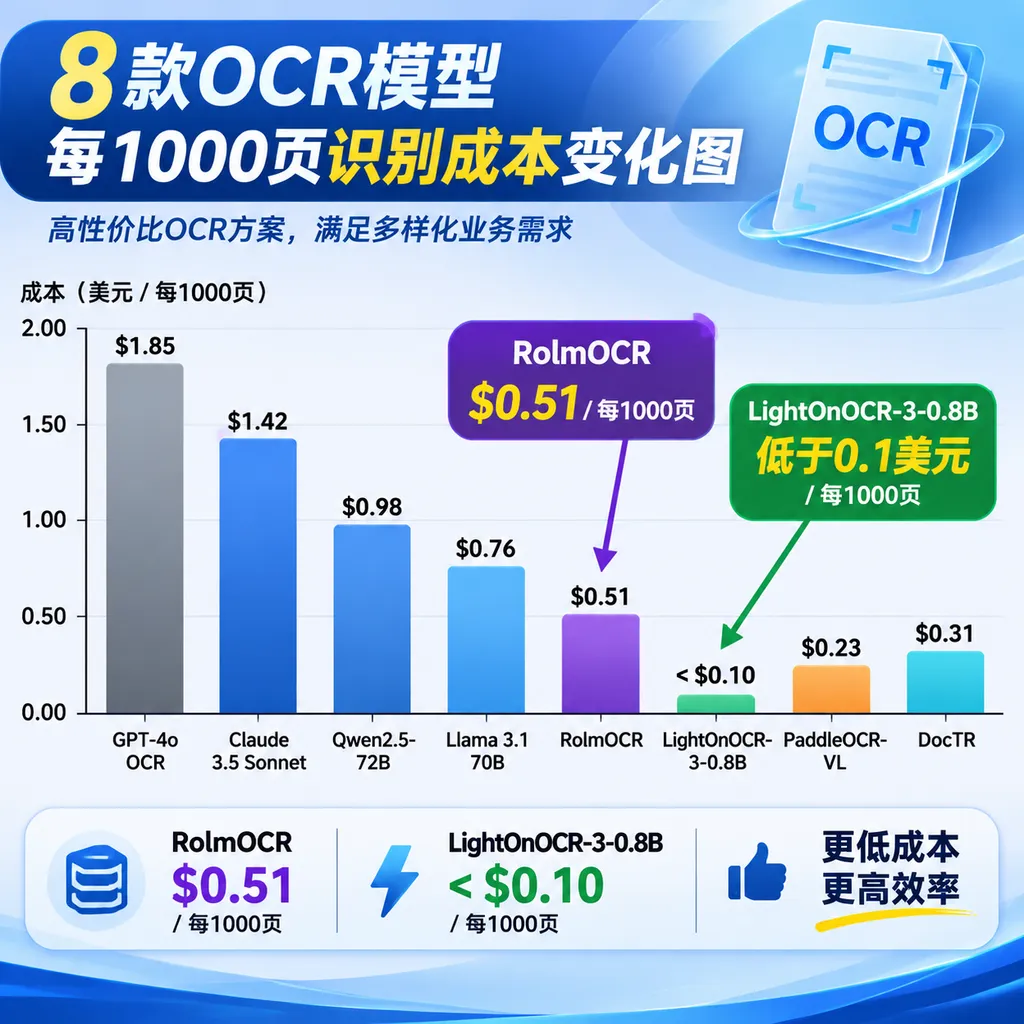
Hugging Face 研究人员 Daniel van Strien 最新完成了一轮 OCR 模型横向测试:在同一张 Nvidia RTX PRO 6000 GPU 上处理850页历史文献,2026年10月发布的 LightOnOCR-3-0.8B 将每1000页识别成本压到了0.1美元以下,而2025年4月发布的 RolmOCR 约为0.51美元。
**OCR(Optical Character Recognition,光学字符识别)是把扫描图片中的文字转换为可检索、可编辑文本的技术。**这一轮变化的关键并不是传统 OCR 又便宜了一点,而是尺寸不到10亿参数的视觉语言模型,已经能以每秒数页的速度完成整页转写,并同时理解多栏布局、标题、脚注和阅读顺序。
按0.1美元计算,1000页历史文献的纯 GPU 识别费用约合人民币0.67元,相比 RolmOCR 的0.51美元下降至少80.4%。测试者给出的进一步估算是:处理100万页材料只需65至130美元 GPU 租赁费,约合人民币434至869元,具体数字取决于文献类型、图片尺寸和页面复杂度。
这意味着 OCR 的推理费用正在从数字化项目的核心预算项,快速退化为一个几乎可以忽略的零头。
测试用了什么材料,结果能说明什么
**这次测试是历史文献 OCR 基准,而不是严格意义上的中文古籍基准。**850页测试材料包括旧版自然历史书籍、1771年版《大英百科全书》,以及打字或印刷的历史档案文件,覆盖了老式字体、多栏排版、纸张老化、扫描噪声和复杂版面等典型难点。
所有模型都运行在同一张 Nvidia RTX PRO 6000 上,GPU 租赁价格为每小时2.75美元。统一硬件和图片尺寸很重要,因为 OCR 成本同时受模型速度、输入分辨率、批处理效率和硬件利用率影响;如果一款模型使用低分辨率图片,另一款模型直接读取原始大图,最后比较出来的并不是模型能力,而是两套完全不同的计算预算。
公开报道确认参测模型共有8款,但目前摘要信息只给出了首尾模型的精确成本,没有完整披露其余6款的逐项名称、吞吐量和准确率。因此,下表只整理能够交叉确认的数据,不用推测数字填满榜单。
| 对比项 | RolmOCR | 中间批次参测模型 | LightOnOCR-3-0.8B | |---|---:|---:|---:| | 发布时间 | 2025年4月 | 2025年至2026年间 | 2026年10月 | | 模型定位 | 早期整页OCR模型 | 多款视觉OCR模型 | 0.8B轻量视觉OCR模型 | | 测试硬件 | RTX PRO 6000 | RTX PRO 6000 | RTX PRO 6000 | | GPU价格 | 2.75美元/小时 | 2.75美元/小时 | 2.75美元/小时 | | 每1000页成本 | 约0.51美元 | 多数处于相近区间,公开摘要未披露精确值 | 低于0.1美元 | | 推算处理时间 | 约11.13分钟/1000页 | 未完整披露 | 少于2.18分钟/1000页 | | 推算最低吞吐量 | 约1.50页/秒 | 未完整披露 | 高于7.64页/秒 | | 书籍页面识别表现 | 基准模型 | 因模型而异 | 至少不逊于RolmOCR | | 已观察到的问题 | 未披露统一错误率 | 部分模型会在空白页生成文字或循环输出 | 仍需针对材料复测 |
上述吞吐量是根据租赁价格和页面成本反推的理论值,不是测试者直接公布的端到端速度。以 RolmOCR 为例,0.51美元除以2.75美元/小时,得到约0.185小时,即处理1000页需要约11.13分钟;LightOnOCR-3-0.8B 的成本低于0.1美元,对应处理时间少于2.18分钟,吞吐量高于每秒7.64页。
**从0.51美元降到0.1美元以下,意味着相同硬件上的单位页面成本至少下降了80.4%,吞吐量提升超过5.1倍。**这比简单比较模型参数量更有价值,因为数字化机构最终关心的不是模型有多少参数,而是一块固定价格的 GPU 每小时能稳定产出多少页可校对文本。
真正值得关注的是0.8B,而不只是0.1美元
**LightOnOCR-3-0.8B 是一款约8亿参数的轻量整页 OCR 模型。**0.8B 这一规模说明,历史文献识别并不一定要调用数十亿甚至数百亿参数的通用多模态模型;只要训练目标足够聚焦,小模型也能完成页面理解、文字转写和阅读顺序恢复。
传统 OCR 通常把任务拆成文本检测、行框切分、字符识别和版面恢复几个阶段。视觉语言 OCR 则更接近“看完整张页面后直接抄写”:模型不仅识别单个字符,还根据上下文判断某段文字属于标题、正文、脚注还是旁注。对于多栏百科全书和旧式档案,这种端到端方式可以减少栏位串行、脚注混入正文和跨栏跳读等问题。
小模型的另一项现实优势是更容易把 GPU 喂满。超大模型可能需要较低批量运行,显存中还要保留庞大的权重和 KV Cache;0.8B 模型则有机会一次并行处理更多页面,把固定的模型加载和调度开销摊薄到每一页上。对数十万页的批处理任务来说,批量大小从1提高到8,往往比单页跑分快10%更有意义。
不过,参数少不等于任何页面都能便宜处理。高分辨率扫描图会产生更多视觉 token,密集小字、多栏表格和跨页插图也会拉长输出序列;如果模型在模糊页面上反复生成同一段文本,表面上的单页推理价格甚至可能失去意义,因为错误输出仍然需要重跑或人工修订。
0.1美元不是古籍数字化的全部成本
**每1000页低于0.1美元只代表 GPU 推理费,不代表完整数字化成本。**一个可用的历史文献项目还包括纸本扫描、图像裁边、去倾斜、文件存储、元数据整理、失败页重试、人工校对、版本管理和长期归档,其中人工复核通常比模型推理贵几个数量级。
以100万页项目为例,测试者估算的 GPU 费用是65至130美元。按每小时2.75美元计算,这相当于约23.6至47.3个 GPU 小时,对应平均每秒处理5.88至11.75页;但只要每页仍需人工检查10秒,100万页就会产生约2778个工时。模型省下来的几十或几百美元,远不如把人工复核时间从每页10秒降到2秒重要。
因此,这组数据真正改变的是项目的试错方式。过去,机构可能先抽取几百页做样本,确认预算后才敢批量处理;现在即使把100万页用多个模型各跑一遍,纯推理支出仍可能只有数百美元。团队可以把不同模型的结果交叉比较,把算力换成更低的漏字率,而不必一开始就押注单一模型。
**OCR 的经济性最终取决于“每页可用文本成本”,而不是“每页生成文本成本”。**如果模型A每1000页只需0.08美元,但有5%的页面必须返工;模型B需要0.15美元,却能把返工率压到1%,后者通常才是更便宜的生产方案。
空白页幻觉,是视觉语言OCR最危险的问题
**OCR 幻觉是模型在图片中没有对应文字时仍生成文本的错误。**测试发现,部分模型会在空白页面上凭空写出内容,或者持续重复同一句话,这类错误比普通错别字更难处理,因为输出看起来可能语法通顺,甚至符合整本书的主题。
传统 OCR 的典型错误是把“rn”识别为“m”,或者漏掉模糊字符;生成式视觉模型则可能根据上下文补出整句话。对于普通资料检索,这种补全或许只是噪声;对于历史档案、法律文件和学术版本整理,它会制造原件中不存在的证据。
空白页检测因此应该放在模型推理之前,而不是完全交给模型决定。一个稳妥的流水线至少需要检查页面像素密度、连通区域数量和输出长度,并对以下异常自动标记:
- 图片近乎空白,但模型输出超过预设字符数;
- 输出中某个短语连续重复3次以上;
- 相邻页面输出高度相似,疑似缓存或批处理错位;
- 输出长度与页面文字区域占比明显不匹配;
- 页面有大量文本区域,但模型只返回空字符串;
- 模型改变了日期、数字、人名或专有名词。
这种规则不会提高模型本身的准确率,却能把最危险的错误送进人工复核队列。对于百万页项目,异常检测器哪怕只拦下0.1%的问题,也意味着提前发现1000个潜在错误页面。
中文古籍不能直接照搬这组结论
**中文古籍 OCR 是针对繁体字、异体字、竖排版式和受损纸张进行识别的专门任务。**这次测试所用材料主要是西文历史书籍和档案,因此“1000页不到0.1美元”可以证明历史文献 OCR 的算力门槛大幅下降,却不能证明模型已经解决中文古籍识别。
中文古籍比1771年英文百科全书多出几层难度:页面可能从右向左竖排,正文与双行小注混排,同一字在不同刻本中存在异体,印章、虫蛀和透页还会覆盖笔画。模型即使生成了一段语义合理的现代汉语,也可能已经悄悄把异体字归一化,破坏版本研究需要保留的原貌。
准确率评估也不能只看“读起来是否通顺”。中文古籍项目至少应该同时报告字符错误率 CER、阅读顺序准确率、版面区域召回率,以及数字、人名、地名和异体字的专项错误率。没有这些指标,“不逊于早期模型”只是定性观察,不能替代可复现的质量结论。
因此,把这次结果直接写成“中文古籍数字化成本降到每千页0.1美元”并不严谨。更准确的说法是:历史书籍与档案的模型推理成本已经跌破这一门槛,而中文古籍能否达到同等成本和质量,需要用真实刻本、抄本、地方志和手稿重新测试。
开发者如何复现一套可信的OCR成本测试
**可信的 OCR 测试必须同时记录质量、吞吐量和失败率。**只比较单次推理速度,会漏掉模型加载、图片解码、批处理等待、输出截断和失败重试;只比较准确率,又无法回答百万页项目需要多少机器和预算。
建议把测试集按材料类型分层,而不是随机混成一个平均分。至少可以划分为清晰印刷页、模糊印刷页、多栏页面、表格页面、纯图片页、空白页和受损页面,并单独统计每类结果。
一套更接近生产环境的评测应记录以下字段:
| 指标 | 定义 | 为什么重要 | |---|---|---| | 字符错误率 CER | 插入、删除、替换字符数占参考字符数的比例 | 衡量基础转写准确度 | | 页面完全正确率 | 无字符错误页面占比 | 估算无需人工修改的页面数量 | | 异常输出率 | 空白页幻觉、重复生成、截断等页面占比 | 衡量生产稳定性 | | P50/P95延迟 | 50%与95%页面的处理时长 | 发现复杂页面造成的长尾阻塞 | | 每秒页数 | 稳态批处理吞吐量 | 计算硬件规模与项目工期 | | 每千页GPU成本 | GPU小时价格乘以处理时间 | 比较不同模型和硬件 | | 每千页可用文本成本 | 推理、重试与人工复核成本之和 | 衡量真实商业成本 |
测试还应固定图片最长边、像素总量、输出长度上限、批量大小、推理精度和软件版本。Daniel van Strien 特别指出,页面任务分配得是否均衡、扫描图片是否过大、软件是否更新以及 GPU 是否适配,都可能带来与更换新模型相当甚至更高的节省。
**工程优化与模型升级正在变得同等重要。**如果一个任务队列总让少数复杂页面拖住整个批次,GPU 就会出现等待;如果扫描原图远高于文字识别所需分辨率,视觉编码器会把算力浪费在纸张纹理上;如果推理框架没有使用合适的注意力实现和批处理策略,再小的模型也跑不出理论吞吐量。
这轮降价会先改变哪些场景
**低成本 OCR 最先受益的是“页数巨大、单页价值不高”的长尾档案。**珍贵孤本本来就值得逐页人工整理,推理费是否为0.1美元影响有限;真正因为预算长期无法数字化的,是地方报刊、企业档案、会议记录、旧技术手册和馆藏普通书籍。
搜索索引也会成为一个直接受益场景。机构不必等到文本完全校对后再上线,可以先用低成本模型生成检索层,让用户通过关键词定位到扫描原页,再逐步修订高访问量页面。此时 OCR 文本承担的是“找到原图”的导航功能,而不是替代原件成为权威版本。
多模型交叉验证同样变得可行。开发者可以让两款低成本模型分别转写同一页,只把字符差异较大的页面交给人工;即使推理费用翻倍,100万页的 GPU 预算仍处在数百美元范围内。与盲目追求单模型最高跑分相比,这种流程通常更容易控制风险。
判断:算力成本已经解决,可信度还没有
**这次8款模型实测证明,OCR 的算力成本已经不再是大规模历史文献数字化的主要障碍。**从每1000页0.51美元降到0.1美元以下,降幅至少80.4%;0.8B模型在固定硬件上跑出超过每秒7页的推算吞吐量,也说明专用小模型正在取代昂贵通用模型承担批量转写任务。
但这并不是一个“古籍数字化已经解决”的结论。测试没有完整公布8款模型的逐项准确率,材料又以西文历史文献为主;空白页幻觉和重复输出进一步说明,生成式 OCR 仍需要规则检测、抽样复核和原图追溯机制。
对开发者来说,最有价值的结论不是立即把所有扫描件交给最新模型,而是把评测单位从“模型跑分”改成“每千页可用文本成本”。推理费已经便宜到可以忽略,下一阶段真正拉开差距的,将是异常页发现率、人工校对效率以及结果是否能够被可靠追溯。
参考来源
- IT之家:AI模型大幅降低古籍数字化成本 —— 汇总Daniel van Strien对8款OCR模型、850页历史材料及RTX PRO 6000运行成本的测试结果。
- Hugging Face:Image-to-Text任务说明 —— Hugging Face 对图像转文本任务、适用场景和相关模型的官方介绍。
- Hugging Face:LightOnOCR-3-0.8B模型检索页 —— 用于查找LightOnOCR-3-0.8B模型卡、权重及许可证信息。
- Hugging Face:RolmOCR模型检索页 —— 用于查找RolmOCR相关模型页面与公开技术资料。