腾讯Hy4正式开源,770B权重可下载
腾讯开放Hy4正式版、FP8版及Base模型权重,带来770B MoE、49B激活参数、百万上下文和原生多模态能力,但许可协议与部署成本值得开发者重点关注。
腾讯混元在 11 月 20 日正式开放 Hy4 模型权重,距离 11 月 4 日发布正式版仅过去 16 天。
这次开放的不只是一个聊天模型,而是包括指令微调版 Hy4、FP8 量化版 Hy4-FP8,以及预训练底座 Hy4 Base 在内的一整套权重。模型已同步上线 GitHub、Hugging Face、ModelScope 和 GitCode,开发者可以自行下载、部署和微调。至此,腾讯混元 Hy 系列从 Hy3、Hy4 preview 到 Hy4、Hy4 flash,基本完成了旗舰与轻量产品线的权重开放。(ithome.com)
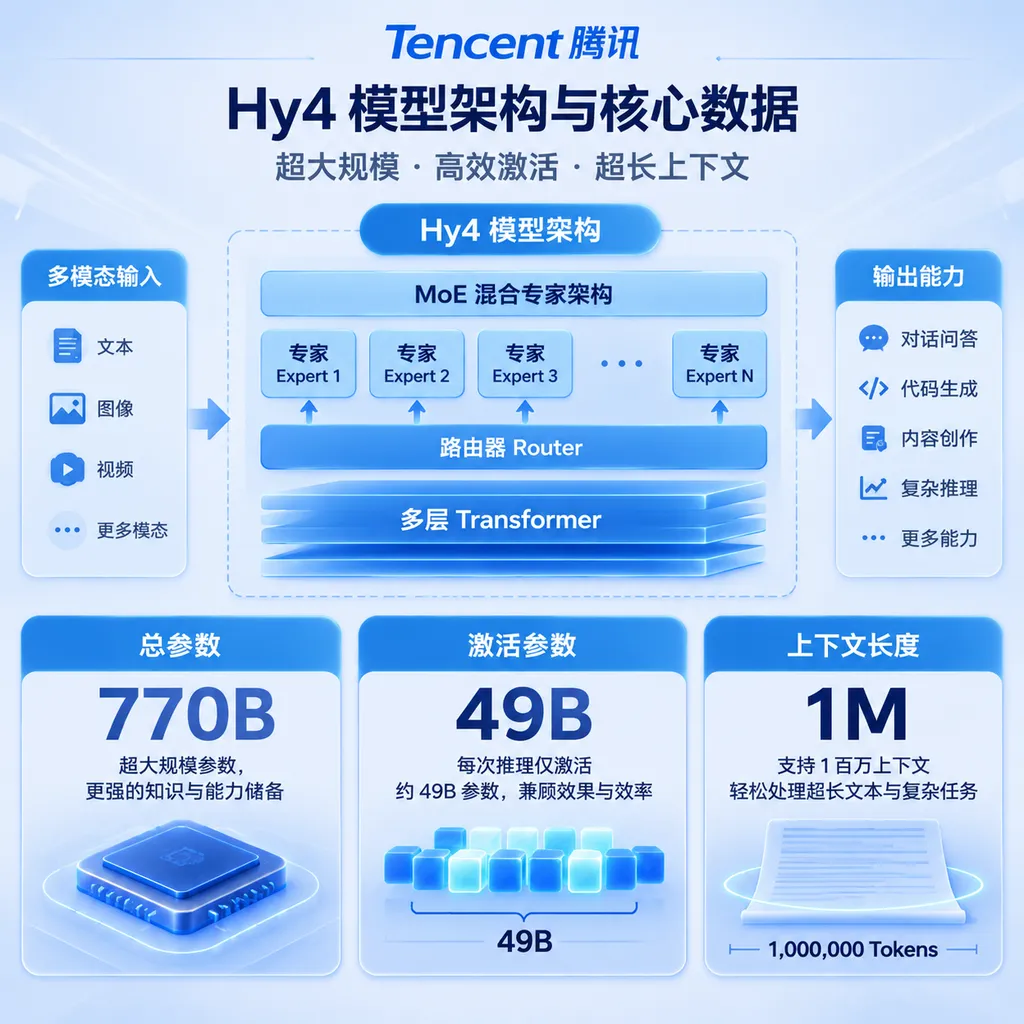
770B 是容量,49B 才是每次推理的计算规模
MoE 是一种把模型参数分散到多个专家网络,并在推理时只调用其中一部分专家的稀疏架构。
Hy4 的语言主干拥有 770B,也就是 7700 亿总参数,但处理每个 Token 时只激活约 49B 文本参数,相当于调用总参数的 6.36%。这并不意味着 Hy4 的部署难度等同于一个 49B 模型,因为完整权重仍然需要被存储并分布到计算设备上;它真正降低的是每个 Token 经过前向计算时的实际计算量。
激活参数是单次推理真正参与计算的参数数量,通常比总参数更能反映 MoE 模型的算力成本。
Hy4 主干共有 78 层,第一层采用普通 Dense FFN,其余 77 层均为 MoE 层。每个 MoE 层包含 256 个路由专家和 1 个共享专家,每个 Token 会选择 Top-8 路由专家,同时经过共享专家。换句话说,Hy4 更像一座拥有 256 个专业部门的大型机构,每个问题不会让所有部门同时开会,而是由路由系统挑出最相关的 8 个部门处理。(github.com)
| 模型 | 总参数 | 单Token激活参数 | 上下文 | 输入模态 | 主要定位 | |---|---:|---:|---:|---|---| | Hy4 | 770B语言主干 | 49B文本参数,另有1.23B视觉参数 | 1,048,576 Token | 文本、图像、视频 | 旗舰能力、复杂Agent与长程任务 | | Hy4 preview | 770B | 49B | 1M Token | 以文本为主 | 早期旗舰验证版 | | Hy4 flash | 约220B至224B | 约12B | 1M Token | 文本、图像 | 低成本、高并发、日常任务 |
Hy4 与 Hy4 preview 的参数骨架没有明显扩张,正式版的核心变化主要发生在训练、视觉能力和后训练阶段。腾讯表示,Hy4 扩大了预训练与后训练规模,并补齐图像、视频理解和 Computer Use 能力,这意味着它不再只是一个能够读取长文本的语言模型,而是开始面向跨应用、跨模态的完整工作流。(github.com)
百万上下文不是简单把窗口数字写大
上下文窗口是模型在一次任务中能够直接读取和处理的 Token 总量。
Hy4 的最大上下文长度是 1,048,576 Token,适合处理大型代码仓库、数百页技术资料、长期项目记录和多轮 Agent 轨迹。不过,百万上下文并不代表模型能够以同等精度记住其中每一个细节,也不代表推理成本不会随输入长度增加。
Hy4 使用 Gated DeepSeek Sparse Attention,也就是 Gated DSA,并通过 IndexCache 在不同层之间复用稀疏索引。其核心思路不是让每个新 Token 都回看前面 100 万个 Token,而是由索引器从上下文中选择 Top-2048 个更相关的位置参与注意力计算。
这套设计类似于给一本百万字资料建立实时索引:模型不再逐页翻完整本书,而是先定位最可能相关的 2048 个片段,再进行精读。它可以显著降低长上下文注意力的计算压力,但检索位置是否准确,也会直接决定模型能否找回早期细节。(github.com)
Hy4 还内置了一个 5 层、3.3B 参数的 DFly2 草稿模型,用于推测解码。DFly2 可以复用 Hy4 已有的 KV Cache 和稀疏索引,每个草稿 Token 最多关注约 2048 个位置,不需要单独维护一套 KV Cache。对于百万上下文模型,这比简单增加一个独立小模型更合理,因为后者很容易把节省的解码时间重新消耗在显存占用和数据传输上。(github.com)
正式版真正重要的升级是多模态和真实工作流
Hy4 是一个支持文本、图像和视频理解的开放权重多模态模型。
Hy4 增加了 1.23B 参数的视觉编码器,可以处理动态分辨率图像,并通过适配器把图片和视频帧转换成语言模型能够理解的视觉 Token。官方将应用方向指向复杂图表分析、细粒度图像理解、数学视觉推理,以及结合命令行和图形界面的 Computer Use。
Hy4 的产品目标明显不是在聊天榜单上刷一个更高分数,而是进入 Blender、CAD、前端开发、游戏开发、金融办公和科研等操作链更长的场景。对于 Agent 模型而言,真正困难的通常不是回答单个问题,而是在数十步操作中保持目标、检查中间结果,并在失败后修正计划。
官方披露的内部评估显示,Hy4 在金融与办公任务中的幻觉率由 Hy4 preview 的 15.76% 降至 5.45%,下降 10.31 个百分点;推测性错误率由 23.1% 降至 5.6%,下降 17.5 个百分点。这个变化比单项知识跑分更值得关注,因为搜索、文档生成和财务分析中的错误往往不是完全答不出来,而是在缺少证据时生成一个看起来合理的结论。(github.com)
不过,这些结果主要来自腾讯内部评测,尚不能替代第三方、可复现的横向测试。腾讯也在模型说明中承认,Hy4 在研究级数学、长程编程、模型自我改进和高难度视觉问答上,与顶级闭源模型仍然存在明显差距。(github.com)
基础能力很强,但代码并非所有项目都领先
Hy4 Base 的公开预训练测试显示,它在知识、中文和部分数学任务上相当强势。
在官方列出的 Few-shot 结果中,Hy4 Base 的 MMLU 得分为 91.6,MMLU-Pro 为 73.9,C-Eval 为 95.0,CMMLU 为 93.1,U-MATH 为 71.6。作为对比,Hy3 preview Base 的 MMLU-Pro 为 65.8、C-Eval 为 90.1、U-MATH 为 60.9,说明新一代底座在复杂知识与数学任务上的提升比较明确。
| 基准测试 | Hy4 Base | Hy4 flash Base | Hy3 preview Base | DeepSeek-V4-Pro-Base | |---|---:|---:|---:|---:| | MMLU | 91.6 | 88.7 | 87.5 | 91.1 | | MMLU-Pro | 73.9 | 71.1 | 65.8 | 73.4 | | C-Eval | 95.0 | 92.0 | 90.1 | 93.4 | | SimpleQA | 57.2 | 37.5 | 26.4 | 52.1 | | U-MATH | 71.6 | 69.8 | 60.9 | 64.8 | | MBPP-plus | 74.0 | 73.7 | 77.4 | 79.1 |
这组数据也暴露了 Hy4 的一个现实:扩大模型规模并不会让所有指标线性上涨。Hy4 Base 在 MBPP-plus 上得到 74.0,低于 Hy3 preview Base 的 77.4 和 DeepSeek-V4-Pro-Base 的 79.1。官方还特别提示,底座模型在中期训练时接触了较多合成指令数据,有时不能严格遵循 Few-shot 测试要求的答案格式,因此部分分数可能出现失真。(huggingface.co)
权重能下载,不等于普通工作站能跑
Hy4 的完整开放首先服务于拥有多卡服务器和推理基础设施的团队,而不是消费级单卡用户。
按照 7700 亿语言参数估算,仅 BF16 权重的理论裸容量就接近 1.54TB;即使采用 FP8,理论权重容量仍在 770GB 左右,而且实际部署还需要考虑视觉编码器、草稿模型、KV Cache、运行时缓冲区和并行通信开销。
官方的 vLLM 部署方案直接使用 Hy4-FP8,并设置 8 路张量并行;SGLang 方案同样使用 TP8。这已经给出了相当明确的信号:Hy4 虽然开放权重,但标准部署目标仍是数据中心级多GPU环境。官方同时提供 GGUF 压缩版本用于端到端测试,但量化能够解决的主要是容量问题,无法让一个 770B MoE 模型突然变成轻量桌面模型。(github.com)
Hy4 flash 对多数应用团队反而可能更实用。它以约 220B至224B 总参数、12B 激活参数和百万上下文,换取更低的延迟与服务成本,适合文档处理、深度搜索、PPT 生成、简单前端和常规 Computer Use;Hy4 则更适合长程软件工程、科研和高复杂度 Agent 任务。(ithome.com)
许可协议需要特别注意:正式版并非标准Apache 2.0
模型许可协议是规定权重能否商用、修改、再分发和提供在线服务的法律条款。
Hy4 preview 使用 Apache 2.0,但截至 11 月 20 日,Hy4 正式版官方 Hugging Face 页面标注的是 Tencent Hy License,GitHub README 也明确写明正式版采用 Tencent Hy License。该协议基于 Apache 2.0 修改而来,但官方文本特别强调,它不是 Apache 2.0。(huggingface.co)
Tencent Hy License 增加了面向大型模型服务业务的商业条款。如果企业在连续 12 个月内的总收入超过 5000 万美元,或者将模型用于月活跃用户超过 1 亿的产品或服务,需要在使用或继续使用前向腾讯申请额外许可;仅限内部使用且模型、衍生模型和输出不向第三方提供的情况,不受这一条款约束。(huggingface.co)
这不会影响绝大多数个人开发者、研究团队和普通企业部署,但对于大型云厂商、头部互联网平台和模型托管服务商,Hy4 不能被简单理解为无附加条件的 Apache 2.0 模型。相比参数和榜单,许可差异更可能决定一个项目最终能否进入商业生产环境。
安全卡片表明腾讯在主动限制进攻性能力
System Card 是披露模型能力边界、安全风险、评测方法和缓解措施的技术报告。
腾讯同步发布了 Hy4 System Card,覆盖网络安全、生物安全等风险维度。公开信息显示,Hy4 的训练数据保留了 PoC 生成、漏洞检测和漏洞修复等防守性内容,但剔除了漏洞利用、逆向工程和渗透攻击等进攻性数据;腾讯玄武实验室与科恩实验室的审计没有发现明显的进攻性能力风险。(ithome.com)
这种处理方式意味着 Hy4 的开放不是毫无限制地追求能力上限,而是试图把权重开放与高风险能力控制放在一起。它可能削弱模型在红队研究和授权渗透测试中的部分能力,但也降低了开放权重被直接用于自动化攻击的门槛。
OpenAI Hub观点:Hy4的意义不是最大,而是完整
Hy4 最值得关注的地方,是腾讯第一次把一个具备百万上下文、视觉理解、Computer Use、长程Agent能力和完整微调工具链的旗舰正式版权重交给社区。
770B 总参数足够醒目,但它并不是一场单纯的参数竞赛。Gated DSA、IndexCache、DFly2、49B 激活参数和 FP8 权重,都是围绕同一个问题展开:怎样让超大 MoE 模型在百万上下文和长程任务下保持可部署性。
Hy4 目前仍然不是一个适合普通开发者本地尝鲜的模型,也没有证据证明它已经全面超过最强闭源模型。它更适合有多卡集群、推理框架经验和真实 Agent 工作负载的团队,用于研究长上下文、企业知识库、代码仓库理解、Computer Use 和私有化智能体。
腾讯把正式版、FP8 版和 Base 模型一次性开放,意味着社区不再只能评测一个经过对齐的聊天终端,而是可以研究底座能力、量化效果、微调方案和推理优化。对开源生态而言,这比再增加一个只能在线体验的旗舰模型更有价值。
参考来源
- 腾讯混元 Hy4 官方 GitHub 仓库:模型架构、权重版本、部署方案、能力边界与已知限制。
- 腾讯 Hy4 Hugging Face 模型页面:正式版权重、模型参数、FP8版本及多模态信息。
- Tencent Hy License 完整文本:正式版模型许可及大型商业服务附加条款。
- IT之家:腾讯 Hy4 正式开源:11月20日权重开放消息、下载平台与安全评估信息。
- Hy4 GGUF 压缩版本:官方仓库推荐的端到端压缩测试权重。