小米MiMo旗舰推理提速20倍
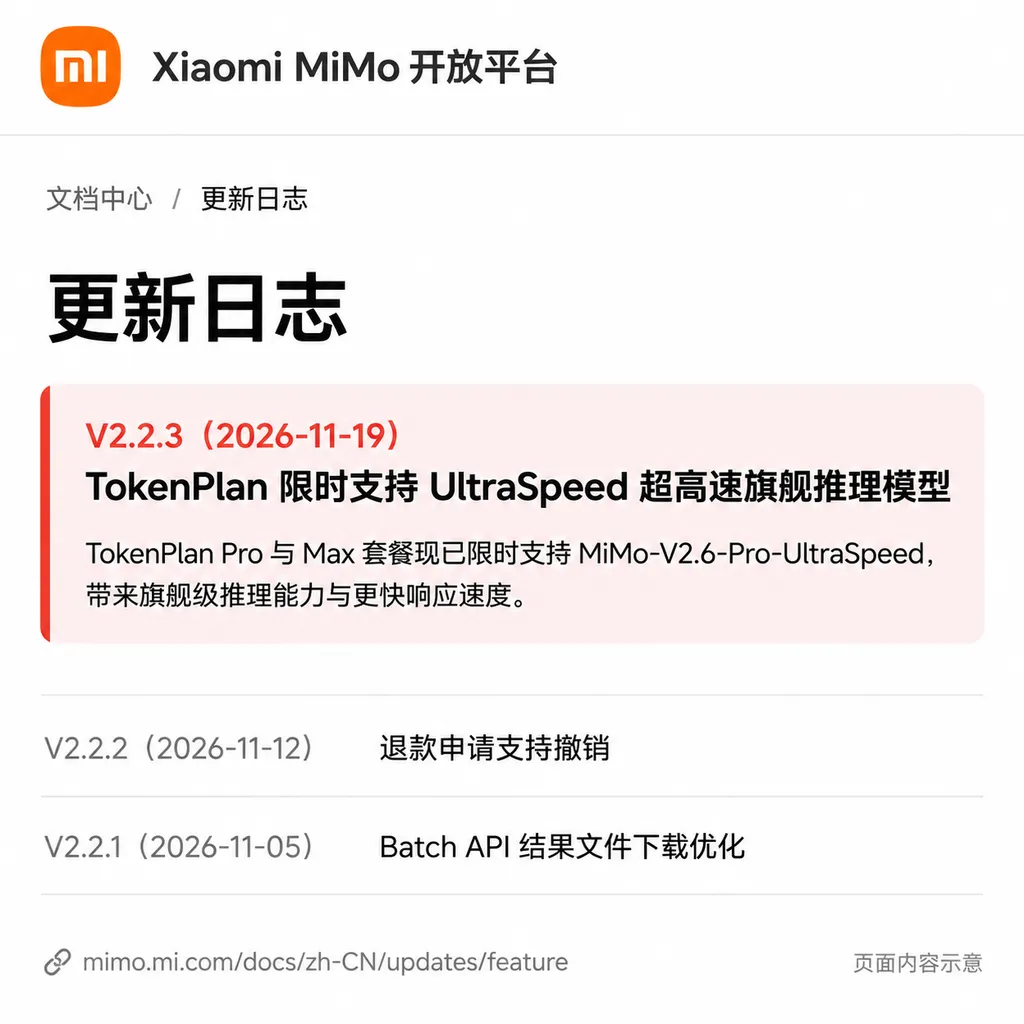
11月19日起,小米MiMo向Token Plan的Pro与Max套餐限时开放UltraSpeed模型,在保留旗舰推理能力的同时,输出速度最高提升至标准Pro的20倍。
小米MiMo向订阅用户开放UltraSpeed,旗舰推理最高提速20倍
小米正在把原本偏向高成本生产场景的超高速推理能力,直接放进开发者订阅套餐里。
11月19日起,Xiaomi MiMo Token Plan 的 Pro 与 Max 套餐限时开放 mimo-v2.6-pro-ultraspeed。这是一个以 MiMo-V2.6-Pro 为能力基线、专门优化输出速度的旗舰推理模型,官方给出的最高输出速度是标准 Pro 的 20 倍。此次开放没有覆盖 Lite 和 Standard 套餐,结束日期也暂未公布。(mimo.mi.com)
这次更新的重点不是模型变得“聪明了20倍”,而是等待模型输出的时间可能被显著压缩。对于代码生成、长篇研究报告、复杂 Agent 任务等输出量较大的工作负载,推理质量不变但生成过程明显加快,往往比一次新的跑分领先更能改善实际体验。
UltraSpeed是什么:用更多推理资源换时间
**MiMo-V2.6-Pro-UltraSpeed 是 MiMo-V2.6-Pro 的低延迟、高吞吐版本。**它保留标准 Pro 的全模态理解、深度思考、工具调用、联网搜索、结构化输出和上下文缓存能力,同时通过更激进的推理资源调度,将输出速度最高提升至标准 Pro 的 20 倍。(mimo.mi.com)
UltraSpeed 的模型规格并没有因为提速而缩水:上下文窗口仍为 100 万 tokens,单次最大输出长度仍为 12.8 万 tokens,输入支持文本、图像、视频和音频,输出为文本。换句话说,它并不是一个通过蒸馏、量化或缩短上下文换取速度的轻量模型,而是旗舰模型的高速服务档位。(mimo.mi.com)
| 模型 | 产品定位 | 相对输出速度 | 上下文窗口 | 最大输出 | 按量计费输出价格 | |---|---|---:|---:|---:|---:| | MiMo-V2.6-Flash | 高频、低成本任务 | 未公布统一倍率 | 1M tokens | 128K tokens | ¥2 / 百万tokens | | MiMo-V2.6-Pro | 复杂任务与旗舰推理 | 1×基准 | 1M tokens | 128K tokens | ¥6 / 百万tokens | | MiMo-V2.6-Pro-UltraSpeed | 强实时、低延迟旗舰推理 | 最高20× | 1M tokens | 128K tokens | ¥60 / 百万tokens |
UltraSpeed 的按量计费价格也是标准 Pro 的 10 倍:缓存命中输入为每百万 tokens 0.25 元,未命中缓存输入为30元,输出为60元;标准 Pro 对应价格分别为0.025元、3元和6元。这个价格差说明,UltraSpeed 本质上不是“免费加速开关”,而是用更多计算资源购买更短的任务完成时间。(mimo.mi.com)
20倍输出速度,不等于端到端延迟缩短20倍
**输出速度是模型开始生成答案后,每秒能够输出多少 tokens 的指标。**它主要影响长回答、长代码和长文档的生成时间,但不能直接等同于首字延迟,也不能代表完整 Agent 任务一定快20倍。
一次大模型请求通常可以拆成四段:请求排队、输入预处理、生成首个 token,以及持续生成后续 tokens。UltraSpeed 官方强调的是“输出速度最高20倍”,目前没有同时公布首字延迟、平均输出吞吐、并发条件和测试提示词长度,因此开发者不应把20倍直接写入自己的端到端延迟预算。
举个例子,如果某项任务在标准 Pro 上需要5秒读取和处理上下文,再用20秒输出结果,即使输出阶段真的加速20倍,总耗时也只是从25秒降至约6秒,整体速度提高约4.2倍,而不是20倍。
如果任务还包含搜索网页、执行代码、读取数据库或调用外部工具,工具等待时间也不会随着模型解码速度同步减少。对多 Agent 系统来说,UltraSpeed 最有价值的环节通常是多个智能体之间频繁生成长消息,而不是网络请求占主要耗时的任务。
Token Plan只开放Pro和Max,门槛是329元/月
**Token Plan 是小米MiMo面向开发者提供的固定周期订阅方案。**套餐通过统一 Credits 额度扣减不同模型的 token 消耗,适合在 AI 编程工具和 Agent 工作流中持续、高频调用模型。
此次 UltraSpeed 仅向 Pro 和 Max 开放,意味着个人用户的最低月度门槛是329元。Pro 每月包含380亿 Credits,Max 每月包含820亿 Credits;Lite 与 Standard 虽然仍能使用标准 Pro 和 Flash,但目前不包含 UltraSpeed 权益。(mimo.mi.com)
| Token Plan套餐 | 月费 | 每月固定额度 | UltraSpeed权益 | 更适合谁 | |---|---:|---:|---|---| | Lite | ¥39 | 41亿 Credits | 不支持 | 偶尔体验、轻量任务 | | Standard | ¥99 | 110亿 Credits | 不支持 | 日常办公与中等频率开发 | | Pro | ¥329 | 380亿 Credits | 限时支持 | 每天高频使用的开发者 | | Max | ¥659 | 820亿 Credits | 限时支持 | 将AI作为核心生产力的重度用户 |
需要注意的是,UltraSpeed 消耗 Credits 的速度也明显更快。当前额度规则显示,标准 Pro 的缓存输入、普通输入和输出每 token 分别消耗2.5、300和600 Credits,UltraSpeed 对应消耗为25、3000和6000 Credits,三个项目都是标准 Pro 的10倍。(mimo.mi.com)
这意味着,如果用户把 Pro 套餐的380亿 Credits 全部用于 UltraSpeed 输出,理论上最多对应约633万输出 tokens;Max 的820亿 Credits 则约为1367万输出 tokens。实际任务还会产生输入、缓存和推理过程中的计费 token,因此真实可生成数量会低于这个理论上限。
小米选择只给 Pro 和 Max 开放并不意外。UltraSpeed 所需要的推理资源显著高于标准模型,如果直接进入39元或99元套餐,很容易被少数高强度用户迅速耗尽共享容量。限定高档套餐既能测试真实需求,也能避免短期流量冲击影响普通 Pro 用户。
哪些场景真的需要20倍速度
**UltraSpeed 最适合任务结果需要在几秒甚至数百毫秒内返回,而且模型推理质量不能明显下降的场景。**官方列出的方向包括量化交易、实时风控、科学研究和实时编程辅助。(mimo.mi.com)
1. 实时编程和复杂重构
代码生成是最容易感知输出速度差异的场景。模型补全几行代码时,标准 Pro 已经足够快;但当任务变成跨文件重构、生成数百行测试、修改大型前端页面时,持续输出速度会直接影响开发节奏。
一个需要输出8000 tokens 的代码任务,如果标准模型平均输出50 tokens/s,仅生成阶段就需要160秒;在理想的20倍速度下,生成时间可能缩短至8秒。这里的1000 tokens/s只是数学示例,并非小米对所有请求的固定承诺,但它足以说明为什么高速解码会改变编程工具的交互方式。
2. 多Agent协作
多 Agent 系统往往不是只生成一个答案,而是由规划、执行、验证和修正等多个角色反复交换长文本。单次生成慢5秒,经过20个步骤就可能多等待近两分钟;如果每一步还要输出长代码或结构化结果,延迟会继续叠加。
UltraSpeed 的价值在于压缩这些累计等待,而不是单纯让聊天窗口里的文字滚得更快。对长程任务来说,用户关心的是项目何时完成,不是模型每秒显示多少字。
3. 实时风控与市场分析
金融场景对延迟敏感,但“模型输出更快”不能简单等同于“可以直接自动交易”。大模型输出存在概率性,生产系统仍需要规则校验、数据时间戳检查、风险阈值和确定性执行层。
UltraSpeed 更适合承担非结构化信息分析,例如快速总结突发新闻、识别公告中的风险因素、生成可供规则系统处理的结构化判断,而不是绕过风控直接发出交易指令。
4. 人机协同研究
科研和数据分析任务经常需要在“提出假设—生成实验—观察结果—修改假设”之间循环。等待时间从几十秒降到几秒后,用户更容易保持连续思考,模型也更接近交互式研究工具,而不是一个提交任务后等待结果的批处理系统。
UltraSpeed并非所有任务的最优选择
**速度不是唯一指标,总任务成本和结果通过率往往更重要。**如果任务本身只输出几百 tokens,或者主要时间消耗在搜索、数据库和外部工具上,UltraSpeed 带来的绝对时间收益可能只有一两秒,却需要消耗10倍 Credits。
对于批量摘要、离线分类、数据标注和不要求实时返回的工作负载,Flash 或普通 Pro 通常更合理。Flash 的输出价格仅为UltraSpeed的三十分之一,更适合规模化任务;标准 Pro 则在旗舰能力和价格之间提供了更稳妥的平衡。(mimo.mi.com)
| 任务类型 | 推荐模型 | 原因 | |---|---|---| | 高频分类、摘要、信息抽取 | MiMo-V2.6-Flash | 单价最低,适合规模化调用 | | 深度研究、复杂代码、长上下文分析 | MiMo-V2.6-Pro | 旗舰能力,成本相对可控 | | 实时代码生成、多Agent交互、低延迟生产任务 | MiMo-V2.6-Pro-UltraSpeed | 最高20倍输出速度 | | 非实时大批量任务 | Flash或Pro的批量处理模式 | 没必要为即时输出支付高速成本 |
小米在卖的不是跑分,而是“完成时间”
**UltraSpeed 的真正竞争指标是 Time to Result,也就是从提交任务到拿到可用结果的总时间。**过去模型厂商习惯比较参数量、基准测试和上下文长度,但随着主流模型能力逐渐接近,用户开始更在意任务能否在不打断思路的时间内完成。
小米这次没有发布一个新的模型权重,而是把高速推理能力下放到现有订阅体系。这种更新看起来不如新模型发布抢眼,却更接近开发者的日常痛点:模型已经能完成任务,但等待太久,导致用户不愿意把它放进实时产品。
从商业策略看,限时开放也是一次容量和需求测试。小米可以观察 Pro、Max 用户切换 UltraSpeed 后的实际 token 消耗、峰值并发和任务类型,再决定最终权益、价格及长期容量。由于官方尚未公布结束时间,现有订阅用户更适合把这段窗口当作一次性能验证,而不是默认其会永久包含在套餐中。(mimo.mi.com)
值不值得升级
**已经订阅Pro或Max的用户值得立即测试,但不建议普通用户只为“20倍”三个字盲目升级。**最合理的方法是选取一个有明确完成条件的真实任务,同时记录标准 Pro 与 UltraSpeed 的首字延迟、总耗时、输出 token、Credits 消耗和最终验收结果。
如果复杂编程任务从两分钟降到十几秒,且一次通过率没有下降,UltraSpeed 很可能值得使用;如果任务本来只需5秒,而且大部分时间花在外部工具上,升级套餐和10倍额度消耗就未必划算。
小米这次更新最有价值的地方,是让开发者可以在同一套旗舰能力上直接比较“成本优先”和“时间优先”两条路径。未来大模型产品的差异,可能不再只是哪个模型分数高两分,而是谁能在用户失去耐心之前,把任务真正做完。
参考来源
- IT之家:小米MiMo Token Plan的Pro/Max套餐限时支持UltraSpeed——报道本次开放时间、适用套餐和最高20倍输出速度。
- Hugging Face:XiaomiMiMo的MiMo-V2.6模型合集——查看MiMo-V2.6系列公开模型、蒸馏模型及相关研究资源。