AI塞进软盘:486也能本地问答
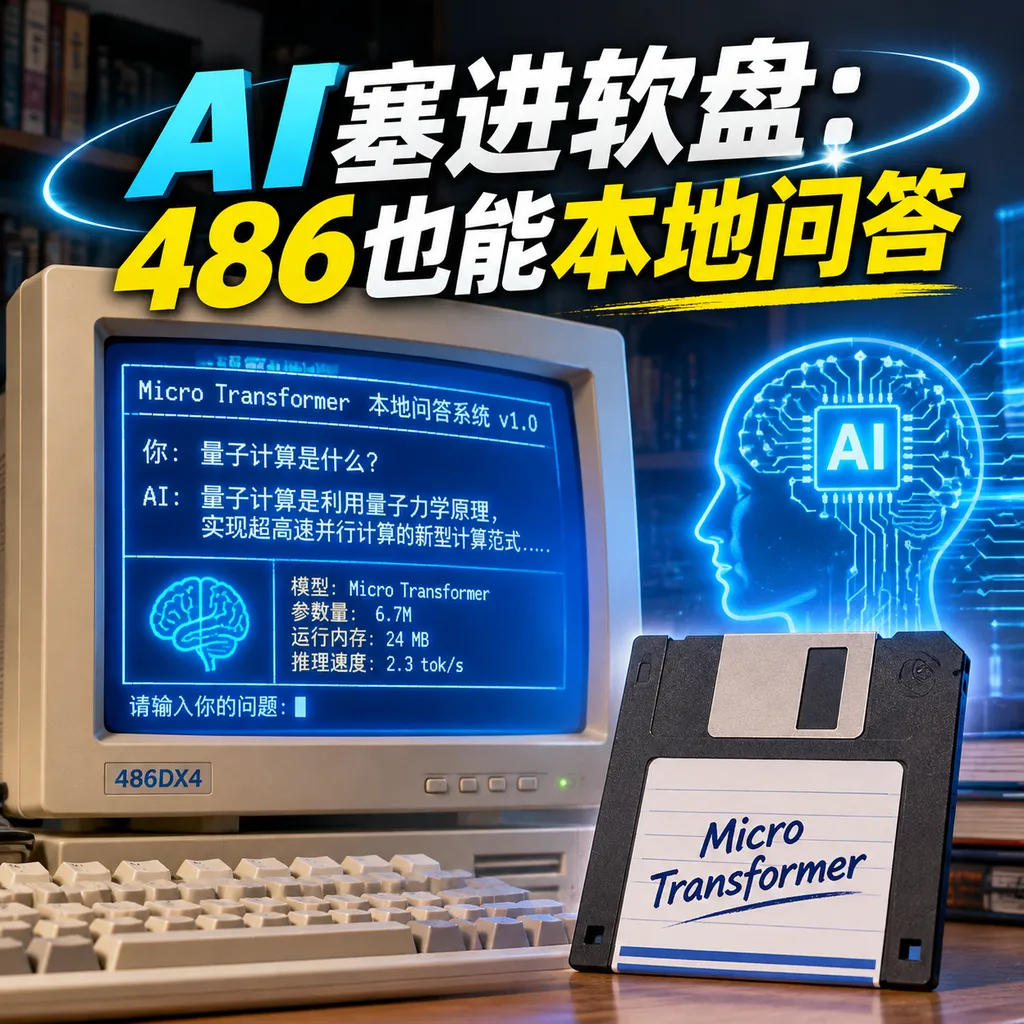
微型 Transformer 被压进 1.44MB 软盘,可在 486 级硬件上离线回答约 3500 条事实问题。它远非现代大模型,却是一次颇有价值的极限部署实验。
一张软盘,装下模型、程序和交互界面
开发者近日把一个微型 Transformer 连同运行程序压进了 1.44MB 软盘,让面向 486DX、早期 Pentium 的电脑也能离线运行问答模型。这个项目通常被称为 Tiny 2.1:用户启动程序后输入问题,模型会在没有云服务、没有 GPU,甚至没有现代操作系统支持的环境里,逐字母生成答案。
Transformer 是一种通过注意力机制建模序列关系的神经网络架构,也是 GPT、Llama 等现代语言模型的技术基础。Tiny 2.1 使用了同一类架构,但它并不是缩小版 ChatGPT,更准确的定位是一台只有约 3500 条事实知识、能够理解有限问法的字符级问答机。
截至 2026 年 11 月 22 日,公开资料显示,这个项目有两个容易被混为一谈的版本:一是媒体报道和演示视频中的 Tiny 2.1,参数量约 36.7 万、模型约 380KB;二是开发者 Lasimeri 在 GitHub 发布的从零重构版本,包含 373,312 个权重,可制作成自启动软盘镜像。后者明确表示,代码并非来自原演示,而是依据视频重新实现。
这一区别很重要,因为公开仓库能够验证的是“486 级指令集和资源限制下可以运行”,而不是所有媒体描述都已在同一台实体老电脑上完成复现。GitHub 项目目前提供了 QEMU、DOSBox-X 等测试方式,但仓库说明也写得很清楚:重构版本尚未在真实 486 硬件上测试。
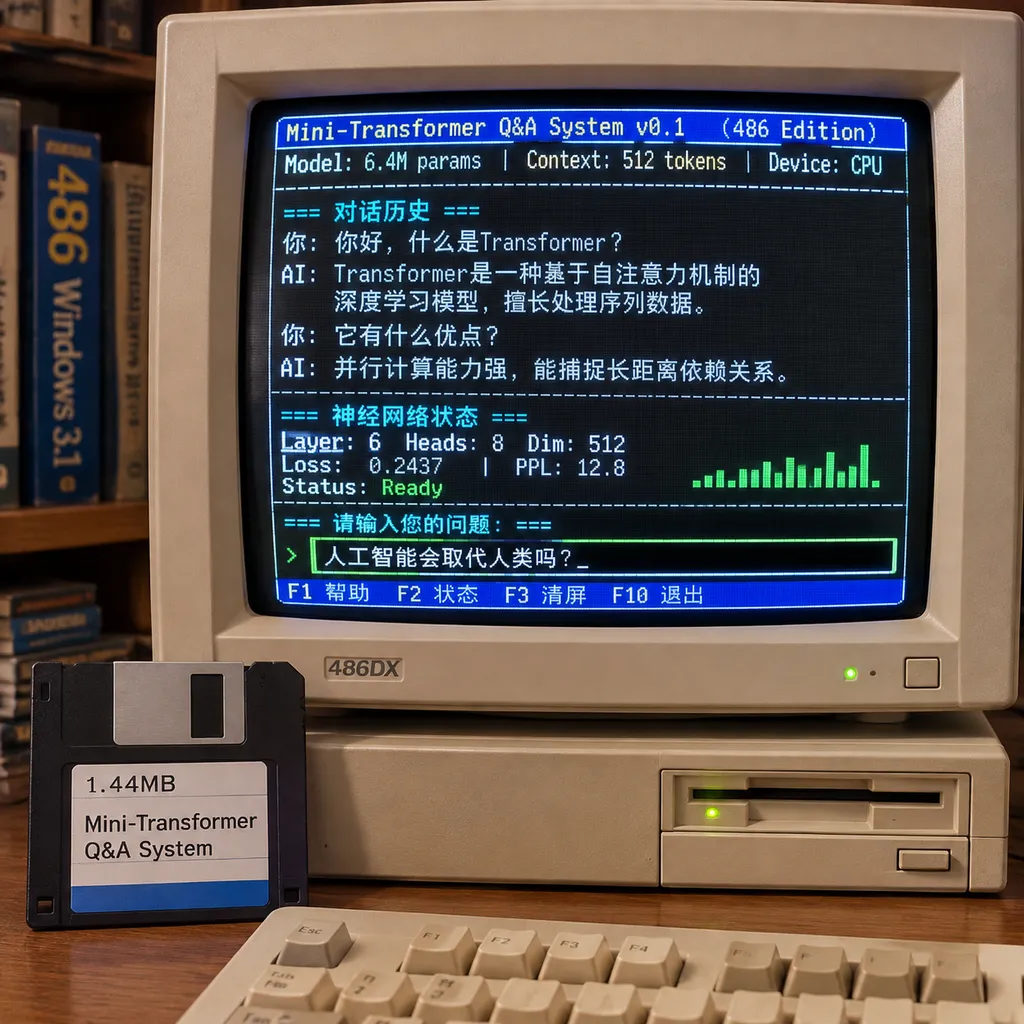
36.7 万参数,为什么还能叫 Transformer
Tiny 2.1 的核心规格只有 4 层网络、96 维隐藏状态和约 36.7 万个参数,与今天动辄数十亿参数的本地模型不在同一个数量级。它仍然拥有嵌入、注意力、前馈网络和逐步生成等 Transformer 的基本组件,只是把宽度、深度、词表和知识范围全部压缩到了极限。
字符级生成是 Tiny 2.1 节省空间的重要手段。字符级模型是指模型不使用现代大模型常见的子词 Token,而是逐个字母或字符读取和输出内容;这样可以缩小词表及其嵌入矩阵,但生成步骤会更多,对拼写和长文本结构的学习也更困难。
这套模型大约围绕 3500 条事实信息训练,每条事实再改写成多种提问方式。它可以回答训练覆盖范围内的常识题,却没有足够容量形成现代大模型那种广泛的语言能力,更谈不上稳定处理编程、长文总结、复杂推理或多轮任务。
公开信息中的关键参数可以整理如下:
| 项目 | 原演示 Tiny 2.1 | GitHub 重构版本 | 现代本地大模型的常见形态 | |---|---:|---:|---:| | 参数或权重数量 | 约 36.7 万 | 373,312 | 通常以十亿计 | | 网络结构 | 4 层、隐藏维度 96 | 面向同类微型架构重构 | 更深、更宽,部分采用 MoE | | 权重精度 | 8 位量化 | 针对 486 环境压缩实现 | 常见 FP16、INT8、INT4 等 | | 模型体积 | 约 380KB | 与启动程序共同放入 1.44MB 镜像 | 通常需要数 GB 至数十 GB | | 生成单位 | 字符级 | 字符级 | 多数采用子词 Token | | 知识规模 | 约 3500 条事实 | 取决于配套数据与训练结果 | 覆盖海量语料,但仍会出错 | | 目标硬件 | 486DX、早期 Pentium | 486,支持有或无数学协处理器 | CPU、GPU、NPU 或 Apple 芯片 | | 联网要求 | 不需要 | 不需要 | 本地模型通常也不需要 | | 实机验证状态 | 有演示资料 | 仓库称尚未在真实 486 上测试 | 取决于具体部署平台 |
这个对比说明,Tiny 2.1 的意义不在于挑战现代模型,而在于证明 Transformer 的最小可运行边界可以低到什么程度。把它称为“大模型”显然不准确,但把它当作神经网络版的电子百科卡片,则相当贴切。
380KB 模型是怎样塞进软盘的
8 位量化是这次体积压缩的关键技术。量化是把神经网络中原本使用高精度浮点数保存的权重,映射成位宽更低的整数,从而减少存储空间和计算成本。
36.7 万个权重如果每个使用 1 字节保存,理论体积约为 367KB,再加上每行共享的缩放系数和少量元数据,模型总大小约 380KB。这里采用的是逐行缩放方案:同一行权重共享一个比例因子,推理时再恢复到适合计算的数值范围,在精度损失与元数据开销之间取得平衡。
1.44MB 软盘的标准格式化容量是 1,474,560 字节,因此放下 380KB 权重并不是全部难题。启动扇区、内核、C 与汇编程序、字符向量表、界面资源、问题输入逻辑和语音输出组件,都必须在剩余约 1.1MB 空间内解决。
GitHub 重构版本采用了更彻底的裸机路线。自启动软盘是指软盘本身包含启动扇区和运行内核,电脑完成 BIOS 自检后可直接从 A 盘加载程序,而不需要先进入 DOS;这与部分报道中“运行在 DOS 上”的描述并不完全相同。
内存限制比磁盘容量更加苛刻。传统 16 位 PC 的常规内存上限是 640KB,而 Tiny 2.1 需要大约 540KB 可用常规内存,这意味着模型权重、激活值、程序代码、界面缓冲区和对话历史必须非常克制,几乎没有现代推理框架常见的运行时余量。
逐字母生成则降低了单步状态管理的复杂度,却把计算时间拉得更长。486DX 级处理器没有现代 SIMD 指令,也没有专门的矩阵运算单元,因此每一次注意力和前馈计算都要依靠通用 CPU 完成;GitHub 重构版本还分别考虑了有数学协处理器和无数学协处理器的运行路径。
它能回答问题,但不能被当成可靠知识库
Tiny 2.1 的能力上限基本由那 3500 条训练事实决定。用户换一种训练中出现过的问法,它可能仍能匹配到正确答案;一旦问题超出数据覆盖范围,模型就只能根据有限的字符模式继续生成,看起来像在回答,实际上没有可靠的事实依据。
幻觉是指语言模型生成语法通顺、语气确定,但事实错误或没有依据的内容。开发者也没有回避这一点,而是直接提醒:在训练知识之外,模型会非常自信地编造答案。
这种幻觉在 Tiny 2.1 上甚至比现代大模型更容易理解。现代模型可能把训练记忆、上下文信息和推理错误混在一起,而 Tiny 2.1 的知识边界非常窄——如果它没学过某条事实,却仍然被要求继续输出,那么“编一个像答案的字符串”几乎是架构决定的结果。
因此,这个项目不适合医疗、法律、维修诊断或资料查询等需要准确性的场景。它更适合以下用途:
- 计算机历史展示具有直观价值。 参观者可以看到 30 多年前的硬件运行真正的神经网络,而不只是播放预录视频。
- 嵌入式教学具有较高价值。 开发者能够观察权重加载、注意力计算、量化和自回归生成,而不必先理解庞大的现代推理框架。
- 封闭领域问答具有实验价值。 用户可以替换训练数据,把模型改造成针对设备手册、游戏设定或个人收藏的微型问答机。
- 生产环境价值非常有限。 3500 条事实、字符级生成和高幻觉率,决定了它无法替代搜索系统、数据库或现代本地模型。
最值得看的不是“复古”,而是软硬件协同
Tiny 2.1 真正有技术含量的部分,是开发者为既定硬件预算重新设计整个推理栈。现代 AI 项目通常先选择模型,再寻找足够大的显存;这个项目反过来先接受 1.44MB 磁盘、640KB 常规内存和 486 指令集,然后让模型、数据格式、界面与启动方式共同适配限制。
这种思路与今天的端侧 AI 并不遥远。手机、耳机、传感器和工业控制器虽然比 486 强得多,但同样受到功耗、内存、散热、实时性和网络条件约束;模型量化、词表裁剪、领域训练和固定内存分配,依然是端侧部署的核心方法。
项目附带训练文件夹也提升了它的可玩性。开发者可以补充自己的事实与不同问法,重新训练一个窄领域版本;不过,增加数据并不等于可以无限扩展知识,因为固定的参数量最终会面临容量冲突,旧知识和新知识也可能互相干扰。
MIT 许可证则让这套代码更适合作为教学和移植底座。开发者可以研究它如何在没有 Python、PyTorch、CUDA 和现代操作系统的条件下完成推理,也可以尝试移植到其他老式 x86 机器、微控制器或复古掌机。
一个必须保留的现实判断
“486 也能运行 AI”在技术上成立,但“486 跑起了现代大模型”并不成立。AI 是一个远大于大语言模型的概念,几十年前的电脑早已能运行规则系统和小型神经网络;Tiny 2.1 的新鲜之处,是把今天最具代表性的 Transformer 架构压缩到了软盘时代的资源预算中。
公开重构版本尚未完成真实 486 实机验证,也是现阶段不能忽略的限定条件。模拟器能够验证指令兼容性和大部分内存行为,却无法完全覆盖老硬件的 BIOS 差异、软驱读盘稳定性、时序问题与外围设备兼容性,因此严格来说,它现在更像“可启动软盘镜像与 486 目标实现”,而不是已经在大量实体机器上验证的成熟软件。
这项实验依然值得关注,因为它把模型能力、存储容量与运行成本之间的关系展示得足够直白。参数多并不自动等于产品好用,参数少也不意味着没有价值;只要任务边界足够清楚,一个 380KB 模型仍然能够在完全离线的机器上完成有限但真实的问答。
Tiny 2.1 最终不会改变大模型竞争格局,却可能成为比许多跑分项目更好的工程教材。它提醒开发者:模型部署不只是把权重交给框架,真正极端的优化,需要从训练数据、数值格式、内存布局、启动过程一直做到交互界面。
参考来源
- IT之家:开发者将微型 Transformer 模型塞进软盘,让 486 老电脑也能用上 AI——介绍 Tiny 2.1 的模型规模、量化方式、训练数据、内存需求和交互界面。
- GitHub:Lasimeri/486DX-LLM——公开的 486 Transformer 重构项目,包含自启动软盘镜像、构建方式、模拟器测试说明及实机验证限制。