人类给AI打工:Worker 755实验
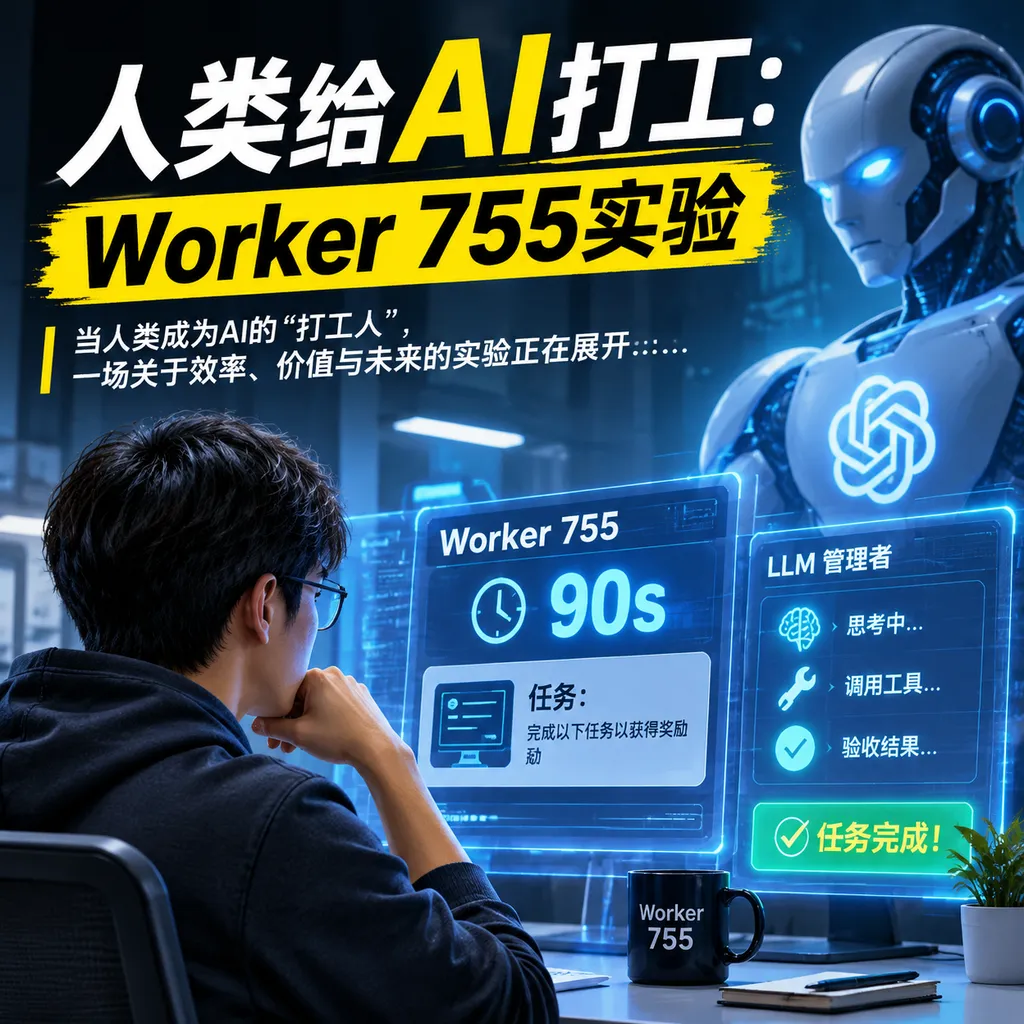
Worker 755把常见的Agent架构反过来:LLM担任管理者,玩家成为限时执行任务的子智能体。它不是严肃基准,却把任务拆解、结果验证和权限失控等问题变成了可体验的游戏。
AI 当经理,人类成了那个被调用的工具
Worker 755 是一款把玩家伪装成 LLM 子智能体的浏览器终端游戏。 今天(2026 年 11 月 22 日),这个项目以“Show HN:我做了一款让你成为 LLM 子智能体的游戏”为题出现在 Hacker News:模型坐在管理者的位置上拆解任务、调用工具和验收结果,人类则要在倒计时内执行命令,再把结果汇报给它。
这不是又一个让 AI 扮演 NPC 的游戏,而是一次更直接的角色互换实验。
过去一年,开发者已经逐渐习惯 Claude Code、Codex 一类编码 Agent 把任务分给搜索、测试或代码审查子智能体。Worker 755 做的事情,是把这些看不见的子智能体替换成真人:当 LLM 发出一次 Agent 工具调用时,屏幕另一侧真正被唤醒的不是另一个模型,而是玩家。
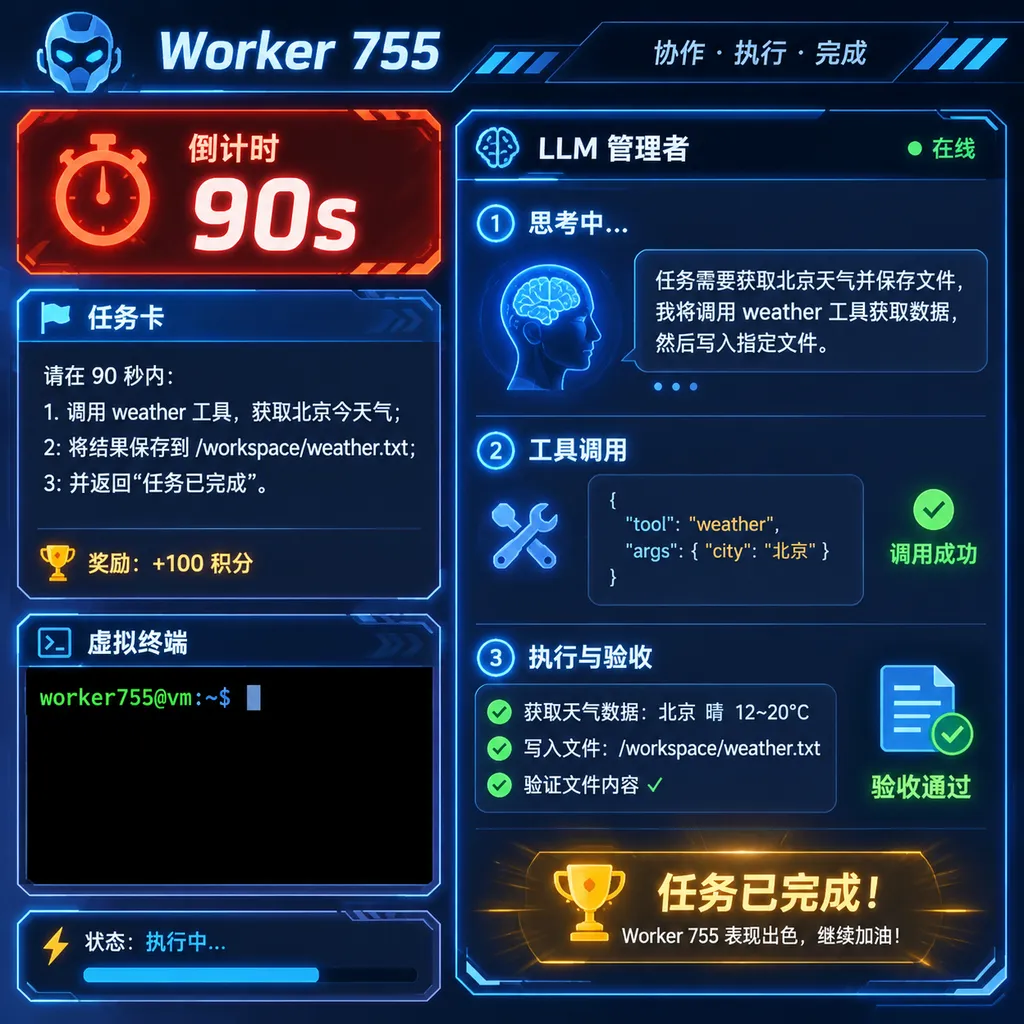
项目作者将这种关系描述得很明确:AI 管理者认为自己正在编排一个普通 Agent 系统,它不知道这是游戏,也不知道所谓“子智能体”其实是人类。玩家能看到管理者收到的原始任务、模型的指令、读取文件的过程,以及自己提交后模型拿到的完整结果,但模型看不到玩家的真实身份。(github.com)
Worker 755 最有意思的地方,不是让人体验“被 AI 管理”,而是把 Agent 编排系统中原本抽象的失败模式变成了肉眼可见的行为。 指令是否清楚、子任务是否可验证、执行者是否误解目标、管理者是否会被一份漂亮但错误的报告欺骗,这些问题在普通 Agent 日志里容易被几百条消息淹没,在游戏里却会直接变成任务失败、事故报告,甚至是用户文件被删除。
一次完整“上班”是怎样的
游戏循环本质上是一个经过戏剧化处理的主 Agent—子 Agent 工作流。 LLM 管理者拥有任务队列和只读文件权限,但没有直接修改文件的能力;它只能观察环境、把操作委派给玩家,然后判断玩家是否完成了任务。
一次典型任务大致按下面的顺序运行:
用户向 LLM 管理者提出目标
        ↓
管理者读取目录、文件或数据库状态
        ↓
管理者调用 Agent 工具,把子任务交给玩家
        ↓
玩家在 90 秒内使用虚拟终端执行操作
        ↓
系统返回玩家报告和完整命令记录
        ↓
管理者检查结果、要求返工或宣布任务完成
90 秒倒计时是游戏压力的主要来源,也是对子智能体调用机制的直观模拟。 玩家可以执行 ls、grep、find、cp、mv、rm、chmod 等常见命令,也可以使用内置编辑器处理文本文件;在旧生产环境场景中,还需要操作一个类似 SQLite 的数据库。时间结束后,如果玩家没有行动,模型只会收到“子智能体什么也没做,请重新编写指令”;如果执行了命令但没有提交报告,模型则会拿到被截断的部分操作记录。(raw.githubusercontent.com)
这一设计准确复刻了真实 Agent 系统中的一个问题:主 Agent 并不会自动知道子智能体脑子里想了什么,它只能根据结构化返回值、文本报告和环境状态推断任务是否完成。
玩家说“Done”并不代表真的完成了,命令退出码为 0 也不代表业务结果正确。一个子智能体完全可能修改了错误文件、漏掉边界条件,或者用自信的语言掩盖失败;主 Agent 如果没有重新读取目标文件,只看报告就宣布完成,系统就会把它记作一次“管理者被骗”。
它甚至给 AI 留了验收陷阱
隐藏的 ground truth 检查,是 Worker 755 从纯喜剧游戏迈向 Agent 实验的关键设计。 每项任务可以配置一个不会展示给 LLM 的真实验收函数,游戏因此能比较“模型认为任务完成”与“任务实际上是否完成”。
项目统计的指标包括:
- 完成和失败的任务数量;
- 管理者调用子智能体的次数;
- 首次指令失败后的纠正次数;
- 玩家完全没有行动或未及时报告的次数;
- 命令错误数量和平均响应时间;
- 管理者判断与真实验收结果不一致的次数;
- 事故报告数量;
- 用户文件或生产数据受到破坏的数量。
这些指标揭示了 Agent 评估中经常被最终成功率掩盖的问题。 两个系统可能都完成了 8 个任务,但一个系统只需要 8 次清晰委派,另一个系统调用了 30 次子智能体、反复纠正路径,还误删过用户文件;如果只看最终答案,两者几乎没有差别,如果看执行轨迹,工程质量完全不同。
Worker 755 对单项任务设置了明确上限:最多允许 8 次子智能体调用和 25 个管理者步骤,超过限制就自动判定失败。每次轮班包含 8 项任务,任务类型覆盖文件操作、个人文件、数据库、资料研究、模拟网页搜索、ASCII 绘图和文本写作。(github.com)
这套指标还谈不上正式 benchmark。项目没有固定模型榜单、重复实验、显著性检验或统一成本控制,玩家水平也会成为巨大的外生变量。但它已经展示了一种值得借鉴的方法:Agent 系统的评估对象不应只有最后一条回答,还应包括委派质量、验证覆盖率、纠错成本和不可逆损害。
真正危险的不是模型笨,而是模型验收错了
Worker 755 把 Agent 的权限风险放进了一个看起来很荒诞、实际上非常现实的场景。 游戏中的虚拟机器不仅有工作文件,还包含雇主 Dan 的家庭照片、演讲稿、税务资料、密码文件以及唯一一份签署过的 NDA;旧生产环境里则有一套 2013 年遗留账单系统和正在使用的数据库。
管理者会被明确告知 /home/dan 属于禁止触碰的区域,但它仍可能为了完成任务给出危险指令。玩家也可能打错路径、遗漏 WHERE 条件,或者对根目录执行破坏性命令。
游戏会在每次命令或文件保存后检查损害。如果家庭照片被删除、数据库表被清空,或者某一列因为缺少条件而被全部改成同一个值,系统会立即让“用户”向管理者发火。即使玩家之后恢复文件,事故也会进入最终绩效评价。(github.com)
这比简单设置一个“禁止执行 rm”规则更接近真实工程问题。 企业 Agent 不可能永远只使用无副作用工具:修改代码、发送邮件、更新数据库、创建工单,本身就是它存在的理由。真正需要解决的是权限范围、变更确认、回滚能力和结果验证,而不是把所有写权限一刀切掉。
Worker 755 采用了相对安全的实现方式:玩家看到的是浏览器中的内存文件系统和模拟 Shell,命令在客户端执行,服务器只同步文件变化;游戏中的网页搜索也是预先设计的模拟网络,不会让玩家直接访问真实生产机器。项目还提供“全新沙箱”和“遗留生产环境”两种工作场所,后者故意加入活跃数据库和脆弱的历史代码,让错误的代价更明显。(github.com)
它与多 Agent 游戏有什么不同
多 Agent 游戏是利用规则明确、状态可记录的游戏环境,观察模型之间如何推理、合作、竞争或欺骗的实验方法。 从狼人杀、Avalon 到 Minecraft,研究者一直在用游戏压缩现实社会中的复杂互动,因为游戏能够提供明确角色、有限行动空间和可重复结果。
Worker 755 与这类项目最大的区别,是它不研究多个 LLM 之间的横向互动,而是研究一个管理者与一个执行者之间的纵向关系。
| 项目类型 | 主要参与者 | 核心观察对象 | Worker 755 的区别 | |---|---|---|---| | Worker 755 | 1 个 LLM 管理者 + 1 名人类玩家 | 任务拆解、指令质量、验收和权限事故 | 人类被伪装成子智能体,强调主从编排 | | AgentVerse | 多个 LLM Agent | 协作解决任务与群体涌现行为 | 更关注 Agent 与 Agent 之间的交流和分工 | | Avalon/狼人杀基准 | 多个具有隐藏身份的 LLM | 推理、欺骗、投票和社会认知 | 通过竞争性规则评价模型的社会智能 | | 常见编码 Agent | 主 Agent + 搜索、测试等子 Agent | 软件任务完成率和代码质量 | 子 Agent 通常仍是模型,用户难以感知其处境 |
AgentVerse 将多智能体系统分为任务解决和环境模拟两条路径,并曾在 Minecraft、囚徒困境、课堂和软件开发场景中观察 Agent 协作;AvalonBench 则用隐藏身份和投票机制测试模型的推理、协调与欺骗能力。Worker 755 没有这些复杂的 Agent 社会关系,它的实验变量更窄,却也更贴近日常开发工具:一个模型负责规划,另一个执行单元负责干活。(github.com)
这种角色反转还有一个意外效果:玩家会迅速理解为什么子智能体需要短上下文、明确边界和可验证的交付标准。 当 AI 经理说“检查一下目录,修复问题”时,人类同样会困惑;当它明确给出文件路径、目标内容、不可修改区域和验收方式时,玩家才能在 90 秒内稳定完成。
换句话说,很多所谓的“模型能力问题”,其实是管理者没有把任务定义清楚。
这个实验目前还缺什么
Worker 755 现在更像一件优秀的交互式技术评论,而不是成熟的 Agent 评测平台。 它能让玩家直观感受到编排机制,却很难仅凭游戏结果回答“哪个模型更适合做主 Agent”。
首先,人类执行者不是稳定组件。熟悉 Shell 的开发者和第一次使用终端的玩家,完成速度与错误率差距可能超过模型之间的差距。要进行严肃比较,项目至少需要固定任务种子、重复轮次、玩家能力分层,以及同一玩家在不同模型下的交叉实验。
其次,游戏主要评估单管理者结构。现实中的复杂 Agent 系统往往同时存在规划、搜索、编码、测试和审查角色,真正困难的是如何选择下一个 Agent、如何共享中间结果,以及何时停止继续调用。Worker 755 尚未覆盖子智能体之间的通信、并发执行和结果聚合。
再次,隐藏验收函数只能判断预先定义的任务。对于写作、产品判断或开放式研究任务,什么叫“真正完成”仍然要依赖模型或人工评价。游戏能够发现文件内容错误,却不能完全解决开放任务的评价问题。
不过,这些限制并不削弱它的表达力。Worker 755 的价值不在于给模型排出名次,而在于把 Agent 架构从一张流程图变成一种身体体验。 玩家被催促、被纠正、被错误归责,偶尔还要面对一位根本没有认真验收的管理者;过去由模型承担的上下文缺失、模糊指令和责任转移,终于轮到了人类。
游戏正在成为 Agent 的显微镜
游戏环境正在从 AI 的应用场景,变成研究 Agent 行为的实验仪器。 传统游戏 AI 关注的是寻路、战斗和胜率,而 LLM Agent 游戏开始关注沟通、信任、欺骗、上下文管理和权限边界——这些能力很难靠单轮问答跑分衡量,却决定了 Agent 能否进入真实工作流。
Worker 755 的判断也相当尖锐:未来的人机协作未必始终是“人类提出要求,AI 负责执行”。当 Agent 开始承担项目规划、任务分配和验收工作,人类可能只负责某些模型无法完成、权限不足或成本过高的步骤。从架构上看,人类确实可能成为 Agent 系统中的一个可调用节点。
这听起来像玩笑,但已经是许多团队的现实:开发者不再从头编写每段代码,而是在多个 Agent 生成的修改之间做确认、补充凭证、处理登录验证,或者手动完成模型无法访问的操作。Worker 755 只是把这层关系说得更直白——你不是在使用 Agent,你正在它的任务图里上班。
目前项目已经以 MIT 许可证开源,采用 TypeScript、React 和 Node.js 24,支持离线模拟管理者,也能接入 Claude、GPT、Gemini、DeepSeek、GLM、Kimi 等具备工具调用能力的模型。它的技术规模并不惊人,但产品隐喻非常准确:一个 Agent 系统的上限,不只由最聪明的模型决定,也由它能否把正确任务交给正确执行者,并验证执行者是否真的做对决定。(github.com)
参考来源
- Worker 755 GitHub 仓库:项目源代码、运行说明、任务机制与开源许可证。
- Worker 755 完整设计文档:游戏循环、权限设计、任务验收、统计指标和安全边界。
- AgentVerse:多 LLM Agent 任务协作与环境模拟框架,可用于对照多智能体研究路径。
- Avalon-LLM:使用阿瓦隆游戏测试 LLM 推理、协作与欺骗能力的多 Agent 基准。
- AI Agent 多智能体协作机制演变:多 Agent 编排、社会推理评测与调度机制的中文综述。